Modèles vocaux full-duplex : 5 mythes testés
Les modèles full-duplex comme Dessa révèlent pourquoi les chaînes ASR-LLM-TTS ne sonnent pas naturelles. Nous testons cinq mythes sur l'IA vocale.
 Sarah Chen
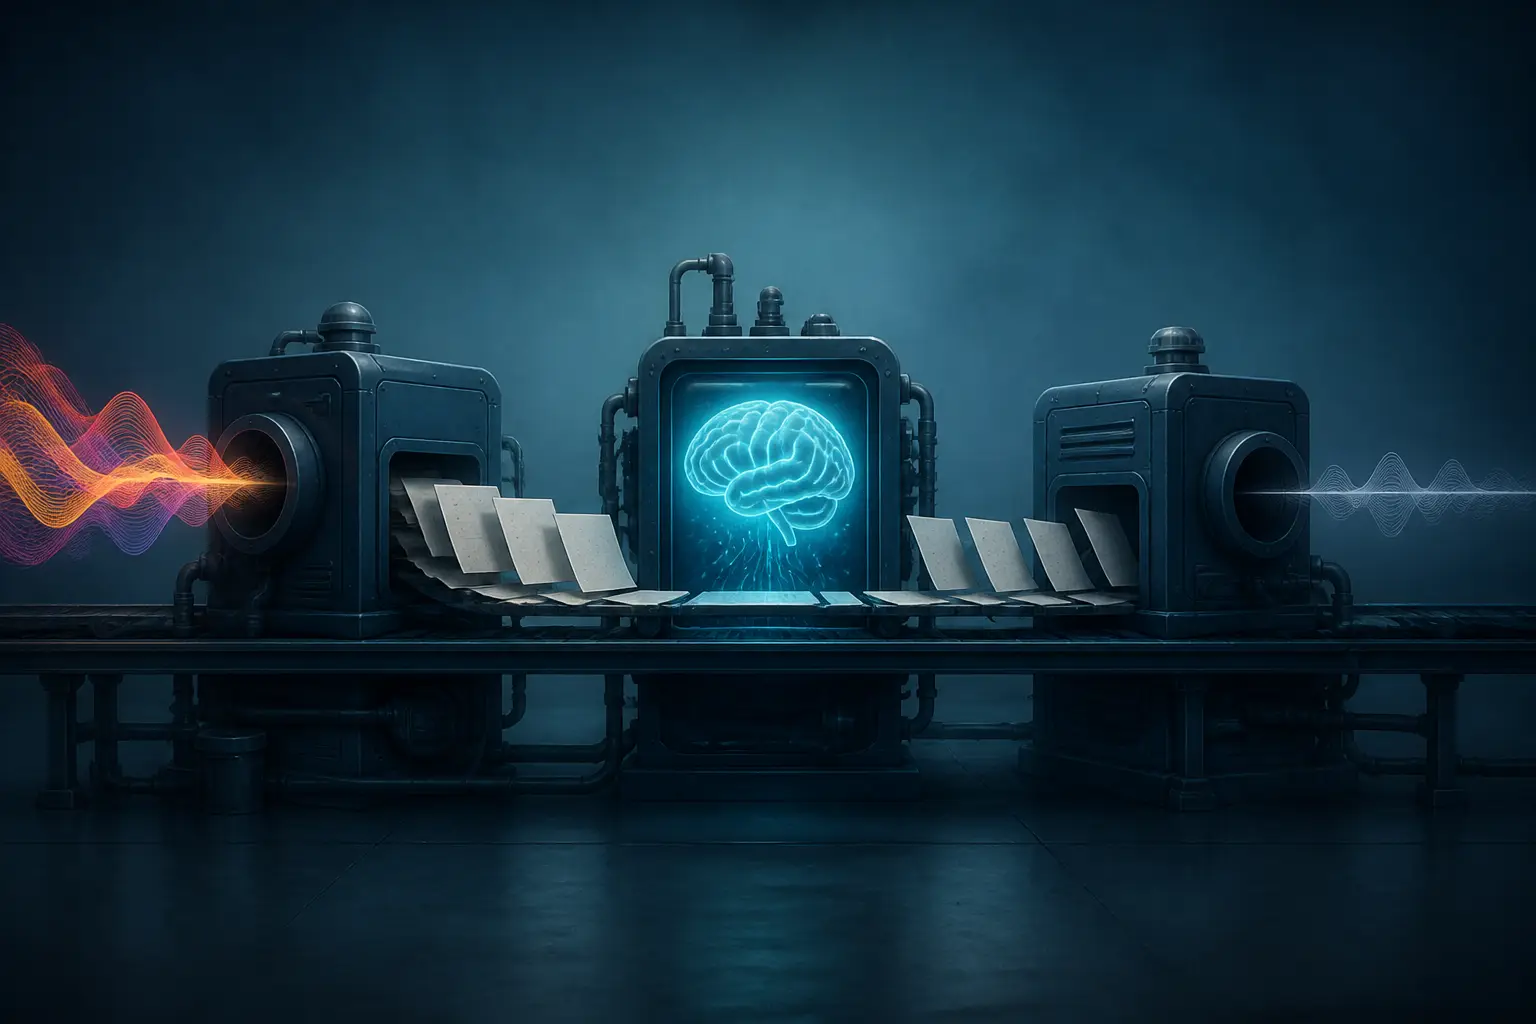
J'ai passé deux ans à construire des assistants vocaux sur la stack classique : reconnaissance vocale en entrée, modèle de langage au milieu, synthèse vocale en sortie. Chaque optimisation de latence qu'on a livrée les rendait plus rapides et, d'une façon ou d'une autre, pires. La vague récente de modèles vocaux full-duplex — des systèmes comme Dessa, un aperçu de recherche d'un petit laboratoire chez Block, entraîné entièrement à partir de zéro sur de la conversation humaine brute — explique enfin pourquoi. Le problème n'a jamais été la vitesse. C'était l'architecture. Et le folklore qui circule sur la façon dont l'IA vocale « devrait » fonctionner est vertigineux. Alors faisons ce que nous avons fait avec les mythes sur le moteur d'inférence de DeepSeek : prenons les croyances courantes sur l'IA vocale conversationnelle et testons-les réellement face à ce que ces nouveaux modèles démontrent.
Mythe 1 : les chaînes en cascade ont juste besoin d'une latence plus faible
C'est la croyance que j'ai gardée le plus longtemps, et c'est aussi la plus fausse. L'architecture standard — reconnaissance automatique de la parole (ASR) alimentant un LLM, qui alimente la synthèse vocale (TTS) — a un défaut fatal qu'aucune ingénierie ne peut corriger : la première étape supprime le signal sur lequel repose la conversation.
Quand on transcrit la parole, on garde les mots et on jette le reste. L'hésitation. Le sarcasme. Le soupir avant « bon, d'accord ». La fêlure dans une voix qui signale que quelqu'un est sur le point de pleurer. Votre étape ASR convertit tout cela en une chaîne du type « ça va » et le LLM en aval n'a littéralement aucun moyen de savoir que l'utilisateur est contrarié. On peut ajouter un classifieur d'émotions à part, bien sûr — voilà un quatrième modèle, encore 100 ms de latence, et un label comme sadness: 0.73 que le LLM traite toujours comme un token, pas comme un sentiment. C'est une compression avec pertes appliquée à la partie du canal qui porte le plus de sens.
Il y a un second problème, plus subtil : dans une pipeline, la latence est additive et séquentielle. L'ASR ne peut pas finir tant que vous ne vous taisez pas (ou qu'il ne devine pas une fin de tour), le LLM ne peut pas démarrer tant que l'ASR n'a pas terminé, et la TTS ne peut pas commencer tant que le LLM n'émet pas de tokens. Les humains ne fonctionnent pas ainsi. On commence à formuler une réponse pendant que l'autre personne est en plein milieu de sa phrase, ce qui explique que l'écart moyen entre deux tours de parole dans une conversation naturelle soit d'environ 200 millisecondes — plus vite que ce que la plupart des systèmes en cascade parviennent même à finir pour leur étape ASR. Un modèle full-duplex, qui traite l'audio entrant et sortant en continu dans un seul réseau, contourne toute cette file d'attente. C'est la différence entre une course de relais et deux personnes qui discutent simplement.
Verdict : mythe démonté. Régler la latence d'une chaîne en cascade revient à optimiser la mauvaise variable. C'est l'architecture elle-même qui constitue le goulot d'étranglement.
Mythe 2 : le texte capture tout ce qui compte dans une conversation
Essayez cette expérience, que j'ai empruntée au billet de l'équipe Dessa parce que c'est la meilleure illustration que j'aie vue. Dites cette phrase à voix haute sept fois, en accentuant un mot différent à chaque fois : « Je n'ai pas dit qu'elle avait volé mon code CUDA. » Sept chaînes de texte identiques. Sept sens totalement différents — dénégation de l'accusation, sous-entendu qu'une autre personne l'a fait, chicane sur le verbe. Tout système basé sur le texte ne voit qu'une seule entrée. Un modèle natif de la parole en voit sept.
La prosodie — accentuation, hauteur, rythme, débit — n'est pas une décoration posée sur la langue. Dans une conversation orale, elle est une grande partie de la langue. Un rire au milieu d'une phrase ne signifie pas la même chose qu'un rire après elle. Les signaux d'écoute (« ouais », « mm-hm », « d'accord ») ne portent aucun contenu lexical, et pourtant une conversation privée de ces signaux donne l'impression de parler à un mur. Si la représentation interne de votre système est du texte, vous avez déjà perdu. L'information n'entre jamais dans le modèle, donc aucune ingénierie en aval ne la récupère. C'est le théorème de Nyquist appliqué à l'UX : échantillonner sous la largeur de bande du signal, et le repliement de spectre (aliasing) devient permanent.
Il y a aussi une dimension de sécurité, et c'est l'argument qui me paraît le plus convaincant. Un assistant vocal qui entend « j'ai vraiment très mal » avec un ton plat est sourd à l'urgence dans précisément la modalité où l'urgence vit. L'équipe Dessa l'énonce explicitement : à mesure que les systèmes d'IA gagnent en autonomie, être aveugle au contenu émotionnel de la parole humaine n'est pas seulement un manque d'UX, c'est un danger. Qu'on adhère ou non à leur modèle comme solution, le diagnostic est juste.
Verdict : mythe démonté, et il n'a jamais été près de tenir. Le texte est une projection de la parole, et comme toute projection, il perd une dimension.
Mythe 3 : la prise de parole n'est qu'un problème de détection d'activité vocale
Demandez à la plupart des ingénieurs comment un assistant vocal sait quand parler, et ils vous répondront « endpointing » : un module VAD attend N millisecondes de silence, puis passe la main. C'est pourquoi chaque assistant vocal que vous avez utilisé vous interrompt en pleine réflexion ou reste planté dans un silence pénible après que vous avez fini. Le silence est un très mauvais indicateur de « c'est à toi ». Les humains marquent des pauses au milieu d'une phrase pour réfléchir, laissent traîner la fin d'une phrase pour inviter à répondre, accélèrent quand ils veulent garder la parole, et ralentissent quand ils la cèdent. La prise de parole se négocie en continu grâce à la prosodie, à la grammaire et au contexte — elle se prédit, elle ne se détecte pas.
Les modèles full-duplex traitent cela comme un problème de modélisation de premier plan. Puisqu'ils écoutent et parlent simultanément, ils peuvent apprendre la distribution réelle du timing conversationnel humain : quand émettre un signal d'écoute, quand intervenir pour finir la phrase bloquée de quelqu'un (une démo de Dessa lui fait fournir un titre de film que l'humain a sur le bout de la langue), et quand se taire. L'interruption n'est pas une condition d'erreur à réprimer ; c'est un signal à modéliser. Ce recadrage est la vraie contribution ici, bien plus que n'importe quelle démo isolée.
Mais je vais nuancer l'emballement, car les commentateurs de Hacker News ont un point légitime : plusieurs de ces démos paraissent trop empressées. Quand le modèle rit avant que l'humain ait fini sa phrase, ou se lance dans un monologue en écrasant tout, on a l'impression d'un modèle qui a trop bien appris que « interrompre = naturel ». La prise de parole prédictive, faite parfaitement, est invisible. Faite à 80 %, elle agace davantage qu'un délai poli d'une demi-seconde, parce qu'une mauvaise interruption paraît impolie d'une façon qu'une réponse lente ne l'est pas. La vallée de l'étrange pour le timing conversationnel est bien réelle, et personne ne l'a encore franchie complètement.
Verdict : mythe à moitié démonté. La prise de parole est bel et bien un problème d'apprentissage, pas un problème de seuil — mais les modèles actuels prouvent davantage que l'approche est la bonne qu'ils ne prouvent qu'elle est résolue.
Mythe 4 : il faut des données textuelles à l'échelle d'internet pour apprendre une langue
Cela semble évident — les LLM consomment des milliers de milliards de tokens, donc le langage exige des milliers de milliards de tokens — jusqu'à ce qu'on se souvienne que chaque être humain ayant jamais vécu a appris à parler à partir de quelques années d'exposition à l'audio, sans aucun texte. Les bébés sont la preuve que les besoins en données sont bien moindres que ce que suppose la recette LLM. Dessa est la version machine de cette expérience : entraîné à partir de zéro, sans poids pré-entraînés, sans aucun texte, uniquement sur des conversations humaines enregistrées. Et selon les affirmations de l'équipe, il a appris la langue à partir de des centaines de fois moins de mots qu'un corpus typique de LLM.
Avant de couronner l'audio comme signal d'entraînement supérieur, quelques réserves honnêtes. D'abord, un mot prononcé coûte des milliers de fois plus d'octets que sa forme écrite, et la parole ne se répète jamais — la même phrase dite deux fois constitue des données différentes. Donc « moins de mots » ne veut pas dire « moins d'octets » ; cela signifie moins de mots, ce qui est une affirmation sur la quantité d'information que la parole porte par unité lexicale, pas sur l'efficacité des données au sens du stockage. Ensuite, les corpus des LLM ne sont pas que du langage : ce sont du code, des maths, du LaTeX, l'ensemble de la trace écrite du savoir humain. Un modèle purement oral en sait étonnamment beaucoup pour son régime d'entraînement, mais personne ne lui demandera de relire votre pull request. Cela s'inscrit dans un schéma plus large que nous avons déjà couvert : les benchmarks et les démos ne capturent qu'une fine tranche de ce que demande le travail réel, et le charme conversationnel est un axe de capacité différent de la profondeur de raisonnement.
Ce que le résultat établit est vraiment intéressant pour la recherche : la structure du langage est apprenable à partir de l'acoustique seule, ce qui en dit long sur la part du « langage » qui réside dans les conventions de l'écrit par rapport à la parole elle-même. Cela ouvre aussi des questions pratiques : les modèles natifs de la parole peuvent-ils apprendre des langues peu dotées, là où l'audio existe mais où les textes transcrits manquent ? C'est un fil qui mérite d'être tiré, d'autant plus que les travaux sur les langues peu dotées butent sur l'absence de corpus textuels.
Verdict : mythe largement démonté pour la langue parlée, avec un astérisque de la taille d'un datacenter. L'apprentissage à partir de l'audio seul fonctionne ; il optimise simplement une chose différente de l'apprentissage à partir du texte seul.
Mythe 5 : une voix réaliste signifie un système intelligent — ou sûr
C'est le mythe qui devrait vous inquiéter, et la section commentaires l'a repéré immédiatement : « usurpation d'identité — c'est à ça que ça sert. » Dur, mais juste sur le fond. Fluidité et intelligence sont orthogonales, et la fluidité vocale est la plus convaincante des deux. Un modèle qui laisse échapper un « oh mon dieu » à votre histoire d'anniversaire avec un timing lacrymal parfait réalise quelque chose de remarquable techniquement, mais rien de cela n'implique qu'il raisonne bien, qu'il connaisse fiablement les faits, ou qu'il ne va pas inventer avec assurance des choses d'une voix chaleureuse et empathique. Au contraire, une diction expressive masque un raisonnement superficiel — nous sommes programmés pour faire confiance aux interlocuteurs sûrs d'eux et émotionnellement attentifs. C'est tout le fondement de l'escroquerie.
Le modèle de menace s'écrit tout seul. Clonage vocal plus capacité conversationnelle full-duplex plus identifiant d'appelant falsifié forment un kit de fraude qui contourne le réflexe sur lequel la plupart des gens comptent : « je saurais si ce n'était pas lui ». Une parade proposée par un commentateur mérite d'être adoptée : une question de défi sur un souvenir commun pour tout appel suspect d'une personne que vous connaissez. Cela paraît paranoïaque. Cela va devenir une pratique courante. À l'honneur de l'équipe, elle invite explicitement les chercheurs en sécurité à sonder le modèle avant une diffusion plus large, ce que peu de laboratoires font. Mais la technologie elle-même est à double usage au sens le plus littéral, et aucun cadrage ne change cela.
Il y a aussi une histoire de coût, enfouie ici, qui joue dans l'autre sens, et de façon positive. Il est affirmé que l'inférence tourne plus vite que le temps réel sur un MacBook Pro avec puce M4 Max, et que l'entraînement a tenu sur un seul système NVIDIA GB200 NVL72. Si ces chiffres se confirment, c'est remarquable : une IA conversationnelle qui a l'air de sortir de la frontière, sans être réservée à un cluster d'hyperscaler. L'inférence locale compte pour la vie privée (votre voix ne quitte jamais l'appareil), pour la latence (pas de saut réseau au milieu d'un flux duplex), et pour savoir qui peut construire sur ces technologies. La tendance à l'efficacité des petits modèles performants, que nous avions déjà signalée avec les LLM de catégorie flash, montre que l'action en inférence se situe de plus en plus du côté des modèles qui tournent sur le matériel qu'on possède.
Verdict : mythe démonté, et c'est le plus dangereux de la liste. Traitez le réalisme vocal comme une propriété d'interface, pas comme un signal de capacité ou de confiance — et adaptez vos habitudes de sécurité personnelles en conséquence.
Ce que ça change vraiment
Mettez de côté le marketing du « plus authentique jamais construit » (le titre a été modéré sur Hacker News pour une raison) et il reste quelque chose d'important : un modèle de parole de bout en bout est une chose catégoriquement différente d'une chaîne, et les différences se cumulent. L'émotion reste dans la boucle. Le timing devient un comportement appris au lieu d'un seuil réglé à la main. Les interruptions deviennent des données. Rien de tout cela n'est atteignable en rendant l'ASR 50 ms plus rapide.
Mon avis pragmatique, en tant que personne qui a livré l'ancienne architecture : les chaînes en cascade ne sont pas mortes. Pour les interfaces vocales transactionnelles — consulter un solde, prendre un rendez-vous, piloter un appareil — elles conviennent, elles sont déboguables, et chaque étape peut être remplacée indépendamment. Les intermédiaires textuels offrent gratuitement la journalisation, la caviardage et l'application des politiques, ce qui compte énormément en production. Mais pour tout ce où la conversation est le produit — le tutorat, la compagnie, les outils d'accessibilité, l'entraînement à la négociation — la chaîne est une impasse, et l'audio de bout en bout est la seule architecture qui puisse jamais paraître naturelle. Choisissez selon que vos utilisateurs parlent à la machine ou à travers elle.
Les questions ouvertes sont les plus intéressantes. Dans quelle mesure l'apprentissage en contexte fonctionne-t-il quand le contexte est audio ? Ces modèles peuvent-ils maintenir un long état conversationnel sans la béquille d'une transcription textuelle ? La fluidité émotionnelle rend-elle les échecs plus nocifs parce que les utilisateurs font confiance à la diction ? Et la question inconfortable : une fois ce niveau d'usurpation possible en local sur un ordinateur portable, à quoi ressemble encore la vérification de l'identité humaine ? Les laboratoires qui répondront honnêtement à ces questions compteront davantage que ceux qui ont la vidéo de démo la plus léchée.
La voix est la plus ancienne interface des humains. Nous avons passé quarante ans à la forcer à passer par un trou en forme de texte en nous demandant pourquoi cela sonnait faux. Il s'avère que le trou était le problème.


