Full-duplex речевые модели: 5 мифов о голосовом ИИ
Full-duplex модели вроде Dessa показывают, почему связки ASR → LLM → TTS звучат неестественно. Разбираем пять мифов о разговорном голосовом ИИ.
 Sarah Chen
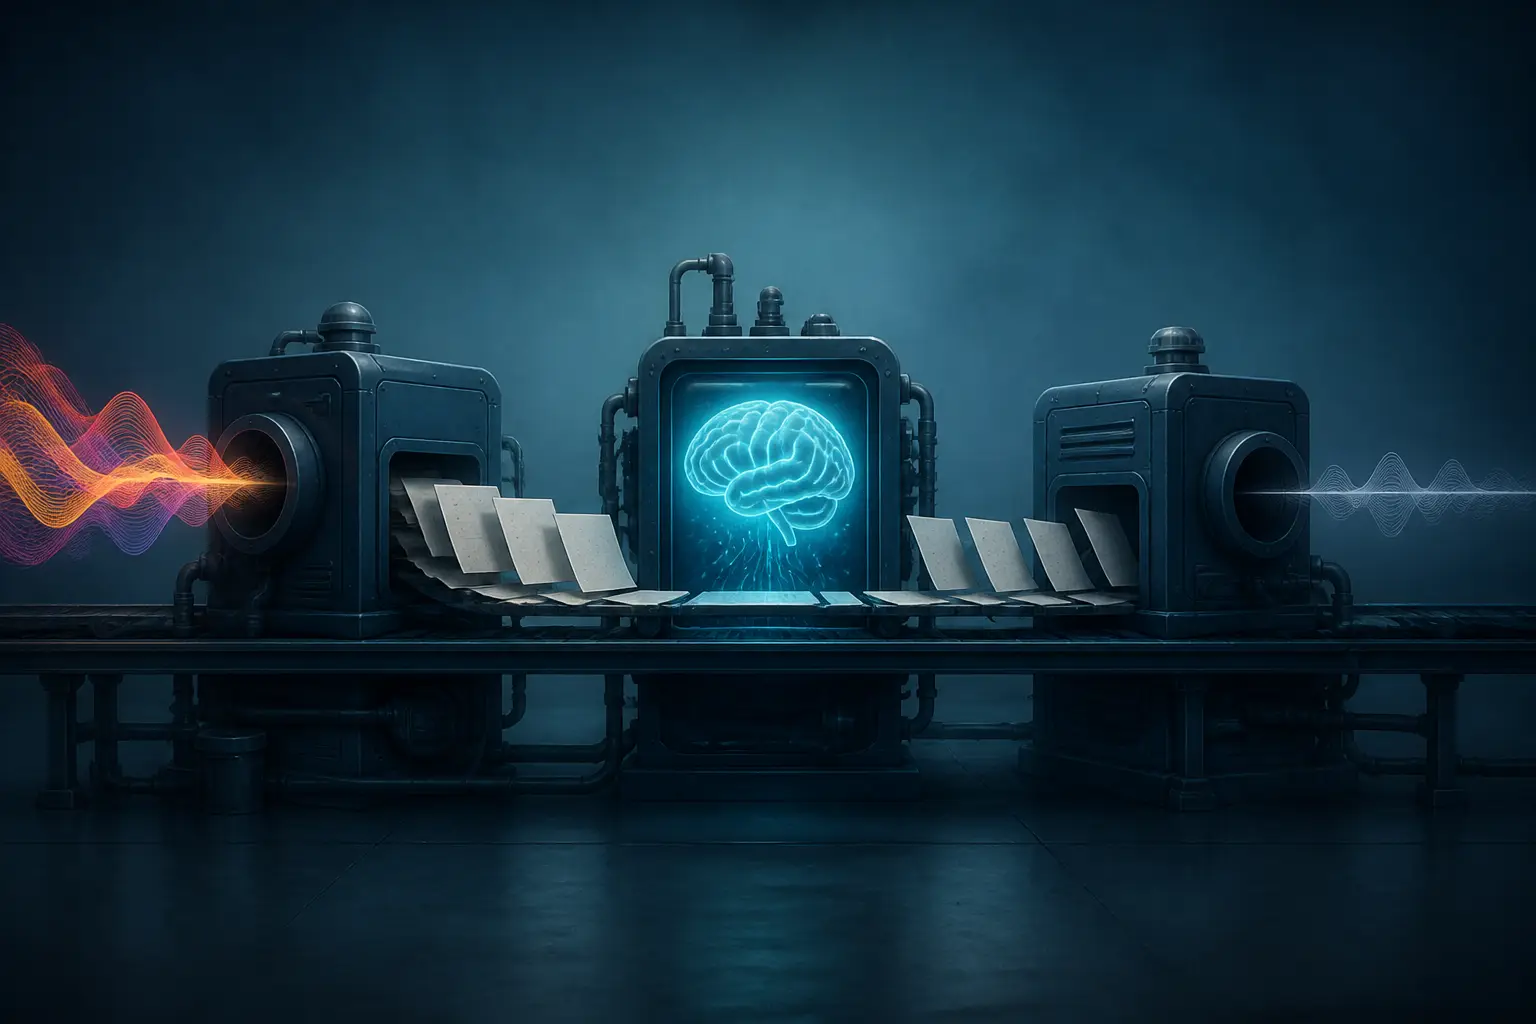
Два года я строил голосовых ассистентов по классической схеме: речь в текст, языковая модель посередине, синтез речи на выходе. Каждая оптимизация задержки делала систему быстрее и почему-то хуже. Недавняя волна моделей с full-duplex речью, таких как Dessa, исследовательская превью-версия от небольшой лаборатории Block, обученная с нуля только на сырых записях живых разговоров, наконец объясняет почему. Проблема никогда не была в скорости. Она была в архитектуре. А вокруг того, как голосовой ИИ «должен» работать, ходит невероятное количество фольклора. Поэтому сделаем то же, что с мифами о движке инференса DeepSeek: возьмём распространённые представления о разговорном речевом ИИ и проверим их на том, что демонстрируют эти новые модели.
Миф 1: каскадным пайплайнам нужна просто меньшая задержка
Это убеждение я дольше всего разделял, и оно самое ошибочное. Стандартная архитектура (автоматическое распознавание речи, ASR, которое кормит LLM, которая кормит синтез речи, TTS) имеет один фатальный недостаток, который никакой инженерией не исправить: первый этап удаляет сигнал, на котором держится разговор.
Когда вы транскрибируете речь, вы сохраняете слова и выбрасываете всё остальное. Запинки. Сарказм. Вздох перед «ладно». Надлом в голосе, по которому понятно, что человек вот-вот расплачется. Ваш ASR превращает всё это в строку вроде «у меня всё нормально», и нижестоящая LLM буквально не может узнать, что пользователь расстроен. Можно прикрутить отдельный классификатор эмоций, конечно. Теперь у вас четвёртая модель, ещё 100 мс задержки и метка вроде sadness: 0.73, которую LLM всё равно воспринимает как токен, а не как чувство. Это сжатие с потерями, применённое к той части канала, которая несёт больше всего смысла.
Есть и вторая, более тонкая проблема: задержка в пайплайне складывается и последовательно. ASR не может закончить, пока вы не замолчите (или пока он не угадает конец фразы), LLM не может начать, пока не закончит ASR, а TTS не может стартовать, пока LLM не выдаст токены. Люди так не работают. Мы начинаем формулировать ответ, пока собеседник ещё говорит, поэтому средний промежуток между репликами в естественном разговоре составляет около 200 миллисекунд, быстрее, чем большинство каскадных систем успевают завершить даже этап ASR. Full-duplex модель, которая непрерывно обрабатывает входящее и исходящее аудио в одной сети, обходит всю эту очередь. Это разница между эстафетой и двумя людьми, которые просто разговаривают.
Вердикт: миф разбит. Настройка задержки в каскадном пайплайне — это оптимизация не той переменной. Узкое место — сама архитектура.
Миф 2: текст передаёт всё, что важно в разговоре
Попробуйте эксперимент, который я позаимствовал из разбора команды Dessa, потому что это самая понятная иллюстрация из всех, что я видел. Произнесите вслух семь раз фразу «Я не говорил, что она украла мой код CUDA», каждый раз делая ударение на другом слове. Семь одинаковых текстовых строк. Семь совершенно разных смыслов: отрицание обвинения, намёк на другого человека, придирка к глаголу. Любая текстовая система видит один вход. Речевая модель видит семь.
Просодия (ударения, высота, ритм, темп) не украшение поверх языка. В устном разговоре она и есть значительная часть языка. Смех посреди фразы сигнализирует одно, смех после неё другое. Бэкченнелы («угу», «ммм», «понял») вообще не несут лексического содержания, но разговор без них ощущается как разговор со стеной. Если внутреннее представление вашей системы текстовое, вы уже проиграли. Информация никогда не попадает в модель, и никакая умность на нижних этапах её не вернёт. Это теорема Найквиста, применённая к UX: если дискретизировать ниже полосы сигнала, наложение спектров становится необратимым.
У этого есть и реальное измерение безопасности, и это самый убедительный довод из всех. Голосовой ассистент, который слышит «мне очень больно» ровным тоном, глух к срочности именно в том канале, где срочность и живёт. Команда Dessa прямо формулирует это так: по мере роста автономности ИИ-систем слепота к эмоциональному содержанию человеческой речи становится не просто пробелом в UX, а опасностью. Согласны вы с их моделью как с решением или нет, диагноз верный.
Вердикт: миф разбит, и даже близко не подходил к истине. Текст это проекция речи, и, как любая проекция, он теряет одно измерение.
Миф 3: очерёдность реплик это просто задача детекции голосовой активности
Спросите большинство инженеров, как голосовой ассистент понимает, когда говорить, и они ответят «эндпоинтинг»: модуль VAD ждёт N миллисекунд тишины и передаёт управление дальше. Поэтому каждый голосовой ассистент, которым вы когда-либо пользовались, либо перебивает вас на полуслове, либо мучительно молчит после того, как вы закончили. Тишина ужасный индикатор того, что «теперь моя очередь». Люди делают паузы, чтобы подумать, приглашающе обрывают фразу, ускоряются, когда хотят удержать слово, и замедляются, когда его отдают. Очерёдность реплик согласуется непрерывно через просодию, грамматику и контекст. Её предсказывают, а не детектируют.
Full-duplex модели рассматривают это как первоклассную задачу моделирования. Поскольку они слушают и говорят одновременно, они могут выучить реальное распределение тайминга человеческого разговора: когда подать бэкченнел, когда вклиниться и достроить чужую застрявшую фразу (в одном демо Dessa модель подсказывает человеку название фильма, которое тот не может вспомнить), и когда замолчать. Перебивание это не ошибка, которую нужно подавить, а сигнал, который нужно моделировать. Этот сдвиг оптики и есть главный вклад работы, важнее любого отдельного демо.
Но здесь я буду спорить с хайпом, потому что комментаторы на Hacker News по делу замечают: несколько демо выглядят чересчур усердными. Когда модель смеётся раньше, чем человек закончил фразу, или сходу уходит в монолог, это выглядит как модель, которая слишком хорошо усвоила, что «перебивать естественно». Предиктивная очерёдность реплик, выполненная идеально, незаметна. Выполненная на 80%, она раздражает сильнее, чем вежливая полусекундная пауза, потому что неудачное перебивание кажется грубым, а медленный ответ нет. Зона неприятного ощущения («uncanny valley») для тайминга разговора реальна, и никто её пока полностью не преодолел.
Вердикт: наполовину разбит. Очерёдность реплик действительно задача обучения, а не задача пороговых значений. Но нынешние модели скорее доказывают, что подход верный, чем что проблема решена.
Миф 4: чтобы выучить язык, нужны тексты масштаба всего интернета
Звучит очевидно: LLM потребляют триллионы токенов, значит, языку нужны триллионы токенов. Пока не вспомнишь, что каждый человек, когда-либо живший на свете, научился говорить после нескольких лет слушания речи без единого текста. Младенцы живое доказательство того, что требования к данным гораздо скромнее, чем предполагает стандартный подход LLM. Dessa машинная версия этого эксперимента: обучена с нуля, без предобученных весов, вообще без текста, только на записанных человеческих разговорах. По заявлениям команды, она выучила язык на в сотни раз меньшем количестве слов, чем типичный корпус LLM.
Прежде чем провозглашать аудио лучшим обучающим сигналом, несколько честных оговорок. Во-первых, одно произнесённое слово весит в тысячи раз больше байтов, чем его текстовая форма, и речь никогда не повторяется: одно и то же предложение, сказанное дважды, это разные данные. Так что «меньше слов» не значит «меньше байтов»; это утверждение о том, сколько информации речь несёт на единицу лексики, а не об эффективности данных в смысле хранения. Во-вторых, корпуса LLM это не только язык, это код, математика, LaTeX, весь письменный массив человеческих знаний. Речевая модель знает удивительно много для своей диеты обучения, но никто не будет просить её проверить ваш пул-реквест. Это вписывается в более широкую закономерность, о которой мы уже писали: бенчмарки и демо охватывают тонкий срез того, что требует настоящая работа, а разговорное обаяние это другая ось способностей, нежели глубина рассуждений.
Что результат действительно доказывает, так это интересно для исследований: структуру языка можно выучить из одной только акустики, и это многое говорит о том, сколько «языка» живёт в текстовых соглашениях, а сколько в самой речи. Это также открывает практические вопросы: могут ли речевые модели освоить языки с малым количеством ресурсов, где есть аудио, но нет расшифрованного текста? Это ниточка, за которую стоит потянуть, особенно учитывая, как много работы по языкам с малым количеством ресурсов упирается в отсутствие текстовых корпусов.
Вердикт: для устной речи в основном миф разбит, но с оговоркой размером с дата-центр. Обучение только на звуке работает; просто оно оптимизирует другое, чем обучение только на тексте.
Миф 5: реалистичный голос означает умную или безопасную систему
Это миф, который должен вас тревожить, и комментарии сразу это увидели: «подмена личности, вот для чего это нужно». Резко, но по сути верно. Беглость речи и интеллект ортогональны, и речевая беглость более убедительная из двух. Модель, которая восклицает «боже мой» на вашу историю про годовщину свадьбы с идеальным дрожанием в голосе, делает технически впечатляющую вещь, но из этого никак не следует, что она хорошо рассуждает, надёжно знает факты или не станет уверенно выдумывать тёплым, сочувствующим голосом. Скорее наоборот: экспрессивная подача маскирует поверхностное мышление, ведь мы устроены так, что доверяем уверенным и эмоционально настроенным собеседникам. На этом и держится всё мошенничество.
Модель угрозы напрашивается сама: клонирование голоса плюс full-duplex разговорная способность плюс подменённый определитель номера это набор для мошенничества, который обходит инстинкт, на который большинство людей полагается: «я бы понял, что это не он». Одна из предложенных комментаторами мер стоит того, чтобы её взять на вооружение: для любого подозрительного звонка от знакомого задавать вопрос о общей памяти. Это кажется паранойей. Скоро это станет стандартной практикой. Команде стоит отдать должное: они прямо приглашают исследователей безопасности поковырять модель до более широкого релиза, что делают не все лаборатории. Но сама технология двойного назначения в самом буквальном смысле, и никакое обрамление этого не меняет.
Есть и история о стоимости, которая работает в другую сторону, и в хорошем смысле. Заявляется, что инференс идёт быстрее реального времени на MacBook Pro с M4 Max, а обучение уместилось в одной системе NVIDIA GB200 NVL72. Если эти цифры подтвердятся, это замечательно: разговорный ИИ с ощущением передовых моделей, который не заперт за гипермасштабным кластером. Локальный инференс важен для приватности (ваш голос не покидает устройство), для задержки (нет сетевого перехода посреди дуплексного потока) и для того, кто вообще сможет на этом строить. Тенденцию к эффективным небольшим, но способным моделям мы уже отмечали в связке с LLM флеш-класса: интересные события в инференсе всё больше происходят на стороне «работает на железе, которое вам принадлежит».
Вердикт: миф разбит, и это самый опасный миф в списке. Относитесь к вокальному реализму как к свойству интерфейса, а не как к признаку способностей или доверия, и соответствующим образом пересмотрите личные привычки безопасности.
Что это на самом деле меняет
Если отбросить маркетинг «самая аутентичная из когда-либо созданных» (заголовок, кстати, модерировали на Hacker News не просто так), остаётся всё равно значимое: сквозная речевая модель принципиально другая вещь по сравнению с пайплайном, и различия накапливаются. Эмоции остаются в контуре. Тайминг становится выученным поведением, а не вручную подобранным порогом. Перебивания превращаются в данные. Ничего из этого не достичь, ускорив ASR на 50 мс.
Мой прагматичный взгляд, как у человека, который выкатывал старую архитектуру в продакшен: каскадные пайплайны не мертвы. Для транзакционных голосовых интерфейсов (проверить баланс, записаться на приём, управлять устройством) они подходят, их легко отлаживать, и каждый этап можно независимо заменить. Текстовые промежуточные слои бесплатно дают логирование, маскирование персональных данных и применение политик, а в продакшене это очень важно. Но там, где сам разговор и есть продукт (репетиторство, компаньонство, инструменты доступности, тренировка переговоров), пайплайн тупиковый, и только сквозное аудио может ощущаться естественно. Выбирайте исходя из того, говорят ли ваши пользователи с машиной или через неё.
Открытые вопросы самые интересные. Насколько хорошо работает обучение в контексте, когда контекст это аудио? Могут ли такие модели удерживать долгое разговорное состояние без костыля в виде текстовой расшифровки? Делает ли эмоциональная убедительность сбои опаснее, потому что пользователи доверяют подаче? И неудобный вопрос: когда такое качество подмены заработает локально на ноутбуке, как вообще будет выглядеть проверка личности человека? Лаборатории, которые честно ответят на эти вопросы, будут важнее тех, у кого самый глянцевый демо-ролик.
Голос самый старый интерфейс, который есть у людей. Мы сорок лет пропихивали его через текстовую дыру и удивлялись, почему это ощущается неправильно. Оказалось, проблема была в дыре.


