Full-duplex en voz IA: 5 mitos puestos a prueba
Los modelos full-duplex como Dessa muestran por qué las pipelines ASR-LLM-TTS no suenan naturales. Probamos cinco mitos de la IA de voz conversacional.
 Sarah Chen
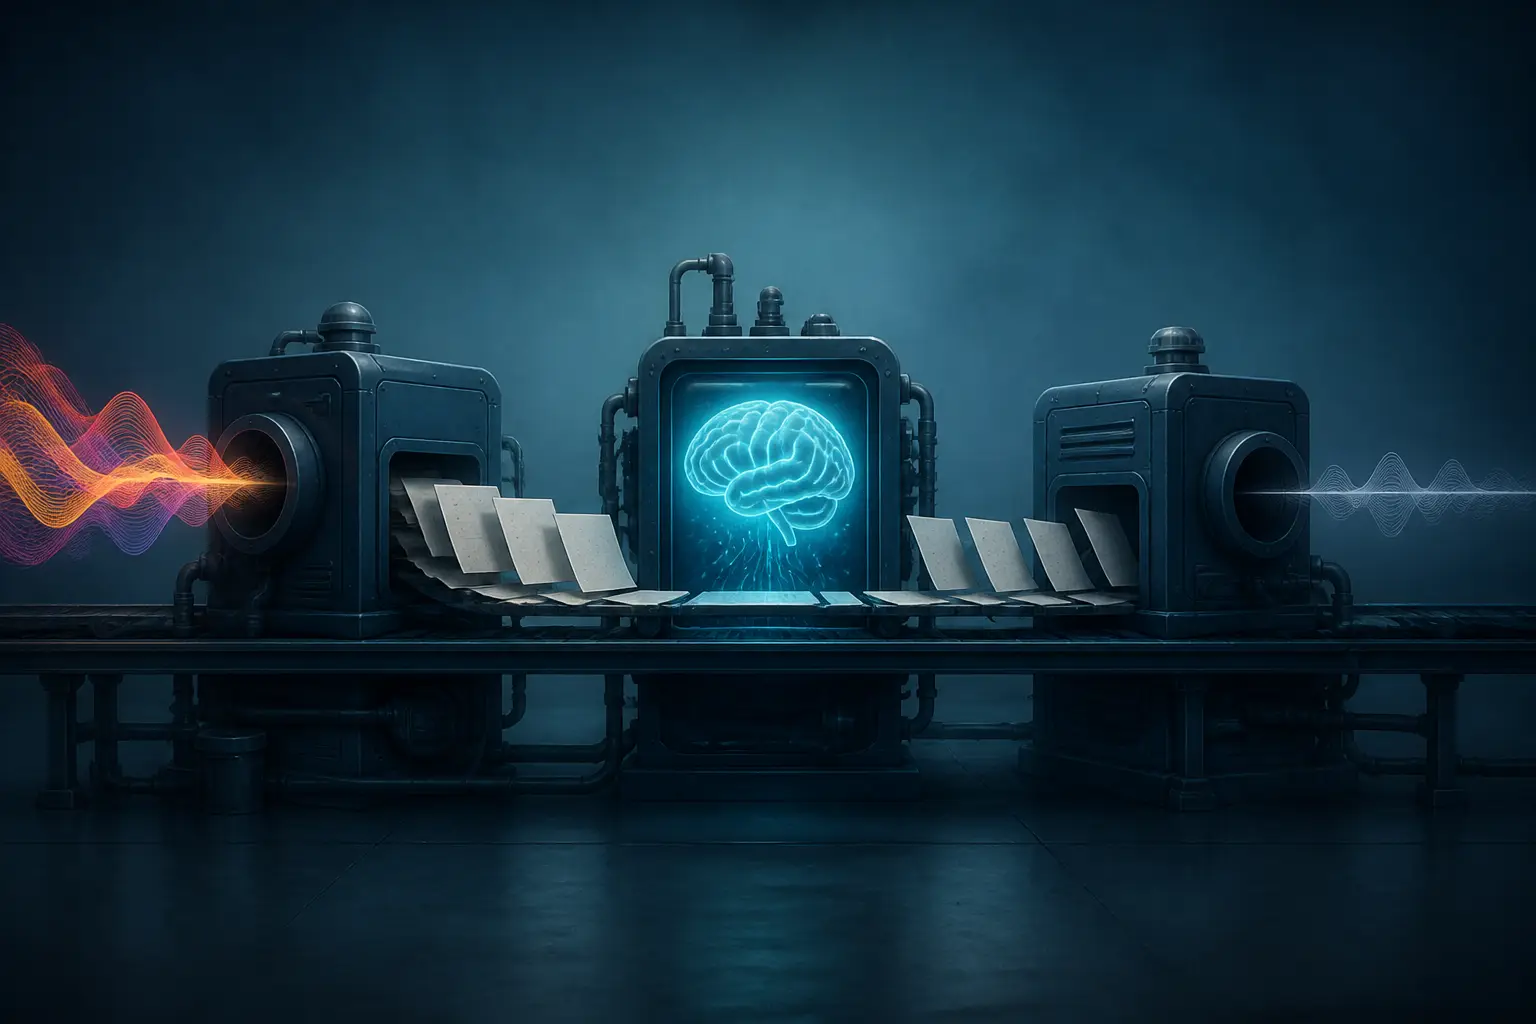
Pasé dos años construyendo asistentes de voz con la arquitectura clásica: voz a texto a la entrada, un modelo de lenguaje en medio y texto a voz a la salida. Cada optimización de latencia que lanzamos lo hacía más rápido y, de alguna forma, peor. La reciente ola de modelos de voz full-duplex (sistemas como Dessa, una vista previa de investigación de un pequeño laboratorio de Block entrenado desde cero solo con conversación humana sin procesar) por fin explica por qué. El problema nunca fue la velocidad. Era la arquitectura. Y la cantidad de folclore que circula sobre cómo la IA de voz «debería» funcionar es asombrosa. Así que hagamos lo mismo que con los mitos del motor de inferencia de DeepSeek: tomar las creencias comunes sobre la IA de voz conversacional y ponerlas a prueba frente a lo que demuestran estos nuevos modelos.
Mito 1: Los pipelines en cascada solo necesitan menor latencia
Es la creencia que más tiempo mantuve, y es la más equivocada. La arquitectura estándar (reconocimiento automático del habla o ASR, que alimenta un LLM, que alimenta la conversión de texto a voz o TTS) tiene un defecto fatal que ninguna cantidad de ingeniería puede arreglar: la primera etapa elimina la señal sobre la que funciona la conversación.
Cuando transcribes el habla, conservas las palabras y descartas todo lo demás. La vacilación. El sarcasmo. El suspiro antes de «bueno». La grieta en la voz que te dice que alguien está a punto de llorar. Tu etapa ASR convierte todo eso en una cadena como «estoy bien», y el LLM posterior no tiene forma de saber que el usuario está molesto. Podrías añadir un clasificador de emociones aparte, claro: ahora tienes un cuarto modelo, otros 100 ms de latencia y una etiqueta como sadness: 0.73 que el LLM sigue tratando como un token, no como un sentimiento. Es compresión con pérdida aplicada a la parte del canal que más significado transporta.
Hay un segundo problema, más sutil: la latencia en un pipeline es aditiva y secuencial. ASR no puede terminar hasta que dejas de hablar (o adivina un punto final), el LLM no puede empezar hasta que ASR termina, y el TTS no puede empezar hasta que el LLM emite tokens. Los humanos no funcionamos así. Empezamos a formular una respuesta mientras la otra persona todavía está a mitad de frase, por eso la pausa media entre turnos en una conversación natural ronda los 200 milisegundos, más rápido de lo que la mayoría de sistemas en cascada logran terminar siquiera su etapa de ASR. Un modelo full-duplex que procesa audio de entrada y de salida de forma continua, en una sola red, evita toda esa cola. Es la diferencia entre una carrera de relevos y dos personas simplemente hablando.
Veredicto: refutado. Ajustar la latencia de un pipeline en cascada es optimizar la variable equivocada. La arquitectura en sí es el cuello de botella.
Mito 2: El texto captura todo lo que importa en una conversación
Prueba este experimento, que tomé del texto del equipo de Dessa porque es la ilustración más clara que he visto. Di en voz alta esta frase siete veces, enfatizando una palabra distinta cada vez: «No dije que ella me robó el código CUDA». Siete cadenas de texto idénticas. Siete significados completamente distintos: negación de la acusación, insinuación de que fue otra persona, discusión sobre el verbo. Cualquier sistema basado en texto ve una sola entrada. Un modelo nativo del habla ve siete.
La prosodia (acento, tono, ritmo, velocidad) no es un adorno sobre el lenguaje. En la conversación hablada, es una gran parte del lenguaje. La risa en mitad de una frase señala algo distinto a la risa al final. Los backchannels («sí», «mhm», «entendido») no llevan contenido léxico alguno, y aun así una conversación sin ellos se siente como hablar con una pared. Si la representación interna de tu sistema es texto, ya perdiste. La información nunca entra en el modelo, así que ninguna astucia posterior la recupera. Es el teorema de Nyquist aplicado a la UX: si muestreas por debajo del ancho de banda de la señal, el aliasing es permanente.
Esto también tiene una dimensión de seguridad, y es el argumento que me resulta más convincente. Un asistente de voz que escucha «tengo mucho dolor» con un tono plano es sordo a la urgencia justo en la modalidad donde vive la urgencia. El equipo de Dessa lo plantea explícitamente: a medida que los sistemas de IA se vuelven más autónomos, ser ciego al contenido emocional del habla humana no es solo una carencia de UX, es un riesgo. Compres o no su modelo como solución, el diagnóstico es correcto.
Veredicto: refutado, y nunca estuvo cerca. El texto es una proyección del habla y, como toda proyección, pierde una dimensión.
Mito 3: Los turnos de conversación son solo un problema de detección de actividad de voz
Pregunta a la mayoría de ingenieros cómo sabe un asistente de voz cuándo hablar y dirán «endpointing»: un módulo VAD espera N milisegundos de silencio y luego cede el turno. Por eso cada asistente de voz que has usado o te interrumpe a mitad de pensamiento o se queda en un silencio angustioso después de que terminas. El silencio es un pésimo indicador de «te toca». Los humanos hacemos pausas a mitad de frase para pensar, dejamos la frase en el aire para invitar a responder, aceleramos cuando queremos conservar la palabra y bajamos el ritmo cuando la cedemos. Los turnos se negocian de forma continua mediante prosodia, gramática y contexto: se predicen, no se detectan.
Los modelos full-duplex tratan esto como un problema de modelado de primera clase. Como escuchan y hablan a la vez, pueden aprender la distribución real del tiempo conversacional humano: cuándo emitir un backchannel, cuándo entrar para completar la frase estancada de alguien (una demo de Dessa tiene al modelo aportando el título de una película que la persona no recuerda) y cuándo callarse. La interrupción no es un error que haya que suprimir; es una señal que hay que modelar. Ese cambio de enfoque es la verdadera aportación aquí, más que cualquier demo concreta.
Pero aquí voy a discrepar del bombo, porque los comentaristas de Hacker News tienen un argumento legítimo: varias de estas demos parecen demasiado entusiastas. Cuando el modelo se ríe antes de que la persona termine una frase, o arrolla con un monólogo, parece un modelo que aprendió «interrumpir = natural» demasiado bien. El turno predictivo bien hecho es invisible. Hecho al 80 %, resulta más molesto que una pausa educada de medio segundo, porque una mala interrupción se siente grosera de una forma que una respuesta lenta no. El valle inquietante del tiempo conversacional es real, y nadie lo ha cruzado del todo.
Veredicto: refutado a medias. Los turnos son genuinamente un problema de aprendizaje, no de umbrales, pero los modelos actuales demuestran más que el enfoque es correcto que que el problema esté resuelto.
Mito 4: Necesitas datos de texto a escala de internet para aprender un idioma
Suena obvio (los LLM consumen billones de tokens, luego el lenguaje necesita billones de tokens) hasta que recuerdas que cada humano que ha existido aprendió a hablar con unos pocos años de exposición al audio y cero texto. Los bebés son la prueba de que el requisito de datos es mucho menor de lo que asume el manual de los LLM. Dessa es la versión mecánica de ese experimento: entrenado desde cero, sin pesos preentrenados, sin texto alguno, solo con conversación humana grabada. Y según afirma el equipo, aprendió el idioma con cientos de veces menos palabras que un corpus típico de LLM.
Antes de coronar al audio como la mejor señal de entrenamiento, algunas advertencias honestas. Primero, una palabra hablada ocupa miles de veces más bytes que su forma escrita, y el habla nunca se repite: la misma frase dicha dos veces son datos distintos. Así que «menos palabras» no significa «menos bytes»; significa menos palabras, lo que es una afirmación sobre cuánta información transporta el habla por unidad léxica, no sobre la eficiencia de datos en el sentido de almacenamiento. Segundo, los corpus de los LLM no son solo lenguaje: son código, matemáticas, LaTeX, todo el registro escrito del conocimiento humano. Un modelo solo de habla sabe sorprendentemente mucho para su dieta de entrenamiento, pero nadie le va a pedir que revise tu pull request. Esto encaja con un patrón más amplio que ya hemos cubierto: los benchmarks y las demos capturan una porción fina de lo que exige el trabajo real, y el encanto conversacional es un eje de capacidad distinto al de la profundidad de razonamiento.
Lo que el resultado sí establece es genuinamente interesante para la investigación: la estructura del lenguaje se puede aprender solo a partir de la acústica, lo que nos dice algo real sobre cuánto del «lenguaje» vive en las convenciones del texto frente al propio habla. También abre preguntas prácticas: ¿pueden los modelos nativos del habla aprender idiomas con pocos recursos donde existe audio pero no texto transcrito? Es un hilo que vale la pena seguir, sobre todo dado lo mucho que el trabajo con idiomas de bajos recursos sufre por la falta de corpus de texto.
Veredicto: mayormente refutado para el lenguaje hablado, con un asterisco del tamaño de un centro de datos. El aprendizaje solo a partir del habla funciona; simplemente optimiza algo distinto que el aprendizaje solo a partir del texto.
Mito 5: Una voz realista significa un sistema inteligente, o seguro
Este es el mito que debería preocuparte, y la sección de comentarios lo vio enseguida: «suplantación: para eso sirve esto». Duro, pero direccionalmente correcto. Fluidez e inteligencia son ortogonales, y la fluidez del habla es la más persuasiva de las dos. Un modelo que suelta un «dios mío» ante tu historia de aniversario con un tono emocionado perfecto está haciendo algo técnicamente notable, pero nada de eso implica que razone bien, que sepa datos con fiabilidad o que no vaya a inventar cosas con seguridad y con voz cálida y empática. Si acaso, la entrega expresiva enmascara el razonamiento superficial: estamos programados para confiar en hablantes seguros y emocionalmente sintonizados. Esa es toda la base del engaño.
El modelo de amenaza se escribe solo. Clonación de voz, más capacidad conversacional full-duplex, más un identificador de llamadas falsificado, es un kit de fraude que anula el instinto en el que confía la mayoría de la gente: «sabría si no fuera él». Una mitigación que comentó alguien merece adoptarse: una pregunta de desafío sobre un recuerdo compartido para cualquier llamada sospechosa de alguien que conoces. Suena paranoico. Pronto será práctica habitual. Para crédito del equipo, están invitando explícitamente a investigadores de seguridad a poner a prueba el modelo antes de un lanzamiento más amplio, algo que pocos laboratorios hacen. Pero la tecnología es de doble uso en el sentido más literal, y ningún encuadre cambia eso.
También hay una historia de costes oculta aquí que juega a favor, y en el buen sentido. Se afirma que la inferencia corre más rápido que tiempo real en un MacBook Pro con M4 Max, y que el entrenamiento cupo en un único sistema NVIDIA GB200 NVL72. Si esas cifras se sostienen, es notable: una IA conversacional con sensación de frontera que no está bloqueada tras un clúster hiperescala. La inferencia local importa por la privacidad (tu voz nunca sale del dispositivo), por la latencia (sin salto de red en mitad de un flujo dúplex) y por quién puede construir sobre esta tecnología. La tendencia de eficiencia en modelos pequeños y capaces es una que ya señalamos con los LLM de nivel flash: lo interesante de la inferencia está cada vez más en el extremo de «se ejecuta en hardware que tú posees».
Veredicto: refutado, y es el mito más peligroso de la lista. Trata el realismo vocal como una propiedad de la interfaz, no como una señal de capacidad o de confianza, y ajusta tus hábitos de seguridad personal en consecuencia.
Qué cambia realmente esto
Quitando el marketing de «lo más auténtico jamás construido» (el título fue moderado en Hacker News por algo), lo que queda sigue siendo significativo: un modelo de voz de extremo a extremo es algo categóricamente distinto a un pipeline, y las diferencias se acumulan. La emoción se mantiene en el bucle. El tiempo se convierte en comportamiento aprendido en lugar de un umbral ajustado a mano. Las interrupciones se convierten en datos. Nada de eso se logra haciendo el ASR 50 ms más rápido.
Mi opinión pragmática, como alguien que lanzó la arquitectura antigua: los pipelines en cascada no están muertos. Para interfaces de voz transaccionales (consultar un saldo, reservar una cita, controlar un dispositivo) están bien, son depurables y cada etapa se puede reemplazar de forma independiente. Los intermedios de texto te dan registro, redacción de datos sensibles y aplicación de políticas gratis, lo que importa muchísimo en producción. Pero para cualquier caso donde la conversación es el producto (tutoría, compañía, herramientas de accesibilidad, práctica de negociación), el pipeline es un callejón sin salida, y el audio de extremo a extremo es la única arquitectura que puede sentirse natural. Elige según si tus usuarios hablan con la máquina o a través de ella.
Las preguntas abiertas son las divertidas. ¿Qué tan bien funciona el aprendizaje en contexto cuando el contexto es audio? ¿Pueden estos modelos mantener un estado conversacional largo sin la muleta de una transcripción de texto? ¿Hace la fluidez emocional que los fallos sean más dañinos porque los usuarios confían en la entrega? Y la incómoda: una vez que este nivel de suplantación funcione localmente en un portátil, ¿en qué consistirá verificar la identidad humana? Los laboratorios que respondan a esas preguntas con honestidad importarán más que los que tengan el reel de demos más pulido.
La voz es la interfaz más antigua que tienen los humanos. Llevamos cuarenta años forzándola a través de un agujero con forma de texto y preguntándonos por qué se sentía mal. Resulta que el agujero era el problema.


