Full-Duplex-Sprachmodelle: 5 Mythen der Voice AI im Test
Full-Duplex-Sprachmodelle wie Dessa zeigen, warum ASR-LLM-TTS-Pipelines nie natürlich klingen. Wir testen fünf Mythen über Voice AI.
 Sarah Chen
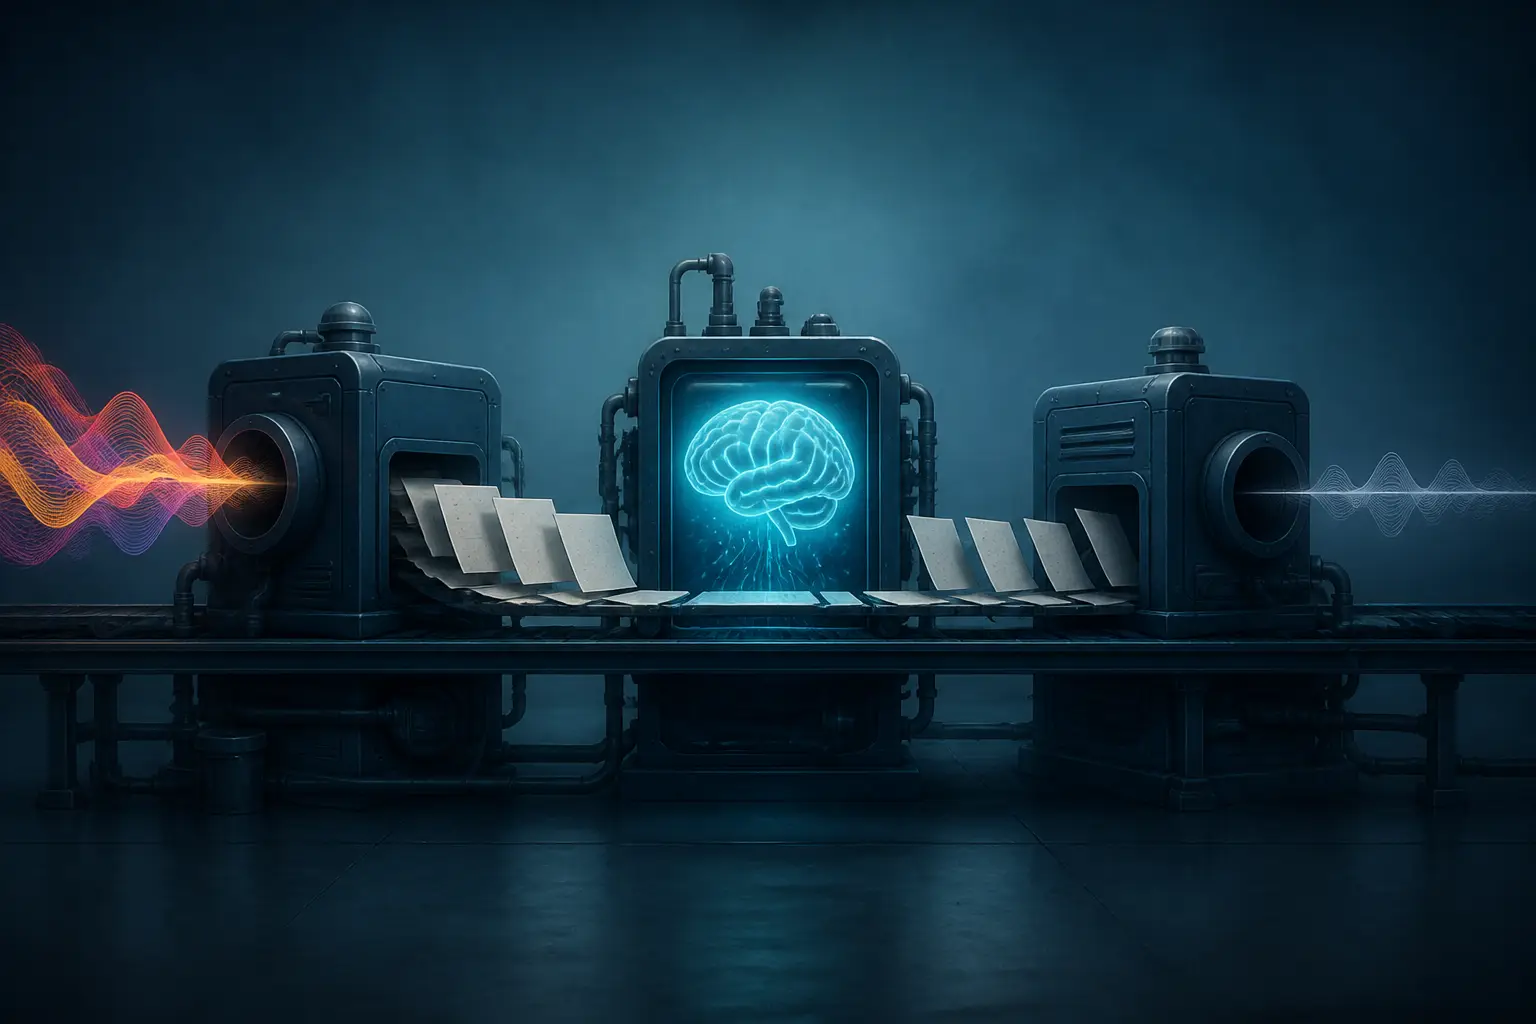
Ich habe zwei Jahre lang Sprachassistenten im klassischen Stack gebaut: Sprache-zu-Text vorne, ein Sprachmodell in der Mitte, Text-zu-Sprache hinten. Jede Latenz-Optimierung, die wir ausgeliefert haben, machte das System schneller und irgendwie schlechter. Die jüngste Welle an Full-Duplex-Sprachmodellen – Systeme wie Dessa, eine Research-Preview eines kleinen Labors bei Block, das komplett von Grund auf nur auf rohen menschlichen Gesprächen trainiert wurde – erklärt endlich, warum. Das Problem war nie die Geschwindigkeit. Es war die Architektur. Und das Maß an Folklore darüber, wie Voice AI „eigentlich“ funktionieren sollte, ist erstaunlich. Also machen wir das, was wir bei den Mythen rund um die Inference-Engine von DeepSeek gemacht haben: Wir nehmen die gängigen Annahmen über Konversations-Sprach-KI und testen sie gegen das, was diese neuen Modelle tatsächlich zeigen.
Mythos 1: Kaskadierte Pipelines brauchen einfach nur geringere Latenz
Das ist die Annahme, an der ich am längsten festgehalten habe, und sie ist am falschesten. Die Standardarchitektur – automatische Spracherkennung (ASR), die ein LLM speist, das wiederum Text-zu-Sprache (TTS) füttert – hat einen fatalen Fehler, den kein noch so cleveres Engineering beheben kann: die erste Stufe löscht das Signal, auf dem das Gespräch basiert.
Wenn du Sprache transkribierst, behältst du die Wörter und verwirfst alles andere. Das Zögern. Den Sarkasmus. Das Seufzen vor einem „ist schon gut“. Den Riss in der Stimme, der verrät, dass jemand gleich weint. Deine ASR-Stufe macht daraus einen String wie „mir geht’s gut“, und das nachgelagerte LLM hat buchstäblich keine Möglichkeit zu erkennen, dass der Nutzer aufgebracht ist. Du kannst einen separaten Emotionsklassifikator dranhängen, klar – jetzt hast du ein viertes Modell, weitere 100 ms Latenz und ein Label wie sadness: 0.73, das das LLM trotzdem nur als Token behandelt, nicht als Gefühl. Das ist verlustbehaftete Kompression, angewendet auf genau den Teil des Kanals, der die meiste Bedeutung trägt.
Es gibt noch ein zweites, subtileres Problem: Latenz in einer Pipeline ist additiv und sequenziell. ASR kann nicht fertig werden, bevor du aufhörst zu sprechen (oder es rät einen Endpunkt), das LLM kann nicht starten, bevor ASR fertig ist, und TTS kann nicht beginnen, bevor das LLM Tokens ausgibt. Menschen funktionieren nicht so. Wir fangen an, eine Antwort zu formulieren, während das Gegenüber noch mitten im Satz ist – deshalb liegt die durchschnittliche Pause zwischen Sprecherwechseln in natürlichen Gesprächen bei etwa 200 Millisekunden, schneller als die meisten kaskadierten Systeme überhaupt mit ihrer ASR-Stufe fertig werden. Ein Full-Duplex-Modell, das Audio-Eingang und Audio-Ausgang kontinuierlich in einem einzigen Netz verarbeitet, umgeht die ganze Warteschlange. Das ist der Unterschied zwischen einem Staffellauf und zwei Leuten, die einfach miteinander reden.
Urteil: widerlegt. Latenz-Tuning einer kaskadierten Pipeline heißt, die falsche Variable zu optimieren. Die Architektur selbst ist der Engpass.
Mythos 2: Text erfasst alles, was in einem Gespräch zählt
Probier dieses Experiment, das ich mir aus dem Writeup des Dessa-Teams geborgt habe, weil es die sauberste Illustration ist, die ich gesehen habe. Sprich diesen Satz siebenmal laut aus und betone jedes Mal ein anderes Wort: „Ich habe nicht gesagt, dass sie meinen CUDA-Code gestohlen hat.“ Sieben identische Textstrings. Sieben völlig unterschiedliche Bedeutungen – Leugnung der Anschuldigung, Andeutung auf jemand anderen, Haarspalterei über das Verb. Jedes textbasierte System sieht eine Eingabe. Ein sprachnativ arbeitendes Modell sieht sieben.
Prosodie – Betonung, Tonhöhe, Rhythmus, Tempo – ist kein Schmuck über der Sprache. Im gesprochenen Gespräch ist sie ein großer Teil der Sprache selbst. Lachen mitten im Satz signalisiert etwas anderes als Lachen danach. Rückmeldungen („ja“, „mhm“, „verstehe“) tragen gar keinen lexikalischen Inhalt, und dennoch fühlt sich ein Gespräch ohne sie an, als würde man gegen eine Wand reden. Wenn die interne Repräsentation deines Systems Text ist, hast du schon verloren. Die Information gelangt nie ins Modell, also kann keine nachgelagerte Cleverness sie zurückholen. Das ist das Nyquist-Theorem, angewendet auf UX: Wenn du unterhalb der Bandbreite des Signals abtastest, entsteht Aliasing – und das ist dauerhaft.
Das hat auch eine reale Sicherheitsdimension, und das ist das Argument, das ich am überzeugendsten finde. Ein Sprachassistent, der „Ich habe so starke Schmerzen“ mit flacher Affektlage hört, ist taub für Dringlichkeit genau in dem Medium, in dem Dringlichkeit lebt. Das Dessa-Team rahmt das ausdrücklich so: Je autonomer KI-Systeme werden, desto mehr ist Blindheit gegenüber dem emotionalen Gehalt menschlicher Sprache nicht nur eine UX-Lücke, sondern ein Risiko. Ob man ihr Modell als Lösung akzeptiert oder nicht – die Diagnose stimmt.
Urteil: widerlegt, und es war nie knapp. Text ist eine Projektion von Sprache, und wie jede Projektion verliert er eine Dimension.
Mythos 3: Turn-Taking ist nur ein Problem der Sprachaktivitätserkennung
Frag die meisten Ingenieure, wie ein Sprachassistent weiß, wann er sprechen soll, und sie sagen „Endpointing“ – ein VAD-Modul wartet N Millisekunden Stille ab und übergibt dann. Deshalb unterbrechen dich Sprachassistenten immer entweder mitten im Gedanken oder sitzen nach deinem Satz in quälender Stille da. Stille ist ein furchtbarer Ersatz für „du bist dran“. Menschen pausieren mitten im Satz zum Nachdenken, lassen Sätze einladend ausklingen, werden schneller, wenn sie das Wort behalten wollen, und langsamer, wenn sie es abgeben. Turn-Taking wird kontinuierlich über Prosodie, Grammatik und Kontext ausgehandelt – es wird vorhergesagt, nicht erkannt.
Full-Duplex-Modelle behandeln das als zentrales Modellierungsproblem. Weil sie gleichzeitig zuhören und sprechen, können sie die tatsächliche Verteilung menschlichen Gesprächstimings lernen: wann sie Rückmeldungen geben, wann sie einspringen, um einen stockenden Satz zu vervollständigen (eine Dessa-Demo lässt das Modell einen Filmtitel liefern, den der Mensch gerade nicht findet), und wann sie den Mund halten. Unterbrechung ist kein Fehlerzustand, der unterdrückt werden muss, sondern ein Signal, das modelliert werden sollte. Diese Neuinterpretation ist der eigentliche Beitrag hier, mehr als jede einzelne Demo.
Aber hier halte ich dem Hype etwas entgegen, denn die Kommentatoren auf Hacker News haben einen berechtigten Punkt: Mehrere dieser Demos wirken übereifrig. Wenn das Modell lacht, bevor der Mensch den Satz beendet, oder sich in einen Monolog hineinwalzt, wirkt es wie ein Modell, das gelernt hat, „Unterbrechen = natürlich“ ein bisschen zu gut. Perfekt gemachtes prädiktives Turn-Taking ist unsichtbar. Bei 80 % Trefferquote nervt es mehr als eine höfliche halbe Sekunde Verzögerung, denn eine schlechte Unterbrechung wirkt unhöflich, eine langsame Antwort nicht. Das Uncanny Valley für das Timing von Gesprächen ist real, und bisher hat es niemand ganz überwunden.
Urteil: halb widerlegt. Turn-Taking ist tatsächlich ein Lernproblem und kein Schwellenwertproblem – aber die aktuellen Modelle beweisen eher, dass der Ansatz richtig ist, als dass das Problem gelöst ist.
Mythos 4: Um Sprache zu lernen, braucht man Text in Internetgröße
Das klingt offensichtlich – LLMs verarbeiten Billionen Tokens, also braucht Sprache Billionen Tokens –, bis du dich erinnerst, dass jeder Mensch, der je gelebt hat, das Sprechen aus ein paar Jahren Audio-Exposition ohne jeden Text gelernt hat. Babys sind der Existenzbeweis dafür, dass der Datenbedarf viel geringer ist, als das LLM-Playbook annimmt. Dessa ist das maschinelle Gegenstück zu diesem Experiment: von Grund auf trainiert, ohne vortrainierte Gewichte, ganz ohne Text, rein auf aufgezeichneten menschlichen Gesprächen. Laut den Angaben des Teams hat es Sprache aus hunderte Male weniger Wörtern gelernt als ein typisches LLM-Korpus.
Bevor wir Audio zum überlegenen Trainingssignal krönen, ein paar ehrliche Einschränkungen. Erstens kostet ein gesprochenes Wort tausendfach mehr Bytes als seine Textform, und Sprache wiederholt sich nie – derselbe Satz zweimal gesagt sind verschiedene Daten. „Weniger Wörter“ bedeutet also nicht „weniger Bytes“; es bedeutet weniger Wörter, was eine Aussage darüber ist, wie viel Information Sprache pro lexikalischer Einheit trägt, nicht über Dateneffizienz im Speichersinn. Zweitens sind LLM-Korpora nicht nur Sprache – sie bestehen aus Code, Mathematik, LaTeX, dem gesamten schriftlichen Wissensbestand der Menschheit. Ein reines Sprachmodell weiß für seine Trainingskost erstaunlich viel, aber niemand wird es bitten, deinen Pull Request zu reviewen. Das reiht sich in ein größeres Muster ein, über das wir schon berichtet haben: Benchmarks und Demos erfassen nur einen dünnen Ausschnitt dessen, was echte Arbeit verlangt, und gesprächige Charme-Fähigkeit ist eine andere Achse als Reasoning-Tiefe.
Was das Ergebnis tatsächlich belegt, ist für die Forschung wirklich interessant: Sprachstruktur ist allein aus Akustik lernbar. Das sagt etwas Reales darüber, wie viel von „Sprache“ in Textkonventionen steckt und wie viel in der gesprochenen Sprache selbst. Außerdem eröffnet es praktische Fragen – können sprachnative Modelle Sprachen mit wenig Ressourcen erlernen, für die es Audio, aber keinen transkribierten Text gibt? Das ist ein Faden, an dem es sich zu ziehen lohnt, gerade weil so viel Arbeit an Sprachen mit wenig Ressourcen an fehlenden Textkorpora scheitert.
Urteil: für gesprochene Sprache größtenteils widerlegt, mit einer Einschränkung von der Größe eines Rechenzentrums. Lernen allein aus Sprache funktioniert; es optimiert nur auf etwas anderes als Lernen allein aus Text.
Mythos 5: Eine realistische Stimme bedeutet ein kluges – oder sicheres – System
Das ist der Mythos, der dir Sorgen machen sollte, und der Kommentarbereich hat ihn sofort erkannt: „Identitätsbetrug – dafür ist das gebaut.“ Hart, aber in der Richtung korrekt. Sprachliche Flüssigkeit und Intelligenz sind voneinander unabhängig, und Sprachflüssigkeit ist die überzeugendere der beiden. Ein Modell, das bei deiner Jubiläumsgeschichte mit perfekt getimtem Schluchzen „oh mein Gott“ haucht, leistet technisch Bemerkenswertes, aber daraus folgt nicht, dass es gut argumentiert, Fakten zuverlässig kennt oder nicht mit warmer, einfühlsamer Stimme selbstbewusst Dinge erfindet. Im Gegenteil: Ausdrucksstarkes Sprechen verdeckt oft flaches Denken – wir sind darauf gepolt, selbstbewussten, emotional eingestimmten Sprechern zu vertrauen. Darauf beruht die ganze Masche von Betrügern.
Das Bedrohungsmodell schreibt sich praktisch von selbst. Stimmklonen plus volle Full-Duplex-Gesprächsfähigkeit plus gefälschte Anrufer-ID ergibt einen Betrugsbaukasten, der genau den Instinkt aushebelt, auf den sich die meisten Menschen verlassen: „Ich würde merken, wenn er es nicht ist.“ Eine Schutzmaßnahme eines Kommentators ist es wert, übernommen zu werden: eine Rückfrage zu einer gemeinsamen Erinnerung bei jedem verdächtigen Anruf von jemandem, den du kennst. Das wirkt paranoid. Es wird aber zur Standardpraxis werden. Dem Team ist zugutezuschreiben, dass es Sicherheitsforscher ausdrücklich einlädt, das Modell vor einer breiteren Veröffentlichung zu prüfen – mehr, als die meisten Labore tun. Doch die Technologie selbst ist im wörtlichsten Sinne Dual Use, und keine noch so gute Rahmung ändert daran etwas.
Es gibt außerdem eine Kostengeschichte, die in die andere Richtung wirkt, und zwar im positiven Sinne. Die Behauptung lautet, Inferenz laufe auf einem MacBook Pro mit M4 Max schneller als Echtzeit, und das Training sei auf einem einzigen NVIDIA GB200 NVL72-System gelaufen. Wenn diese Zahlen stimmen, ist das bemerkenswert: Konversations-KI, die sich nach Grenzmodell anfühlt und nicht hinter einem Hyperscale-Cluster verschlossen bleibt. Lokale Inferenz ist wichtig für den Datenschutz (deine Stimme verlässt das Gerät nie), für die Latenz (kein Netzwerk-Hop mitten im Duplex-Stream) und dafür, wer auf dieser Technik aufbauen kann. Den Effizienztrend bei kleinen, leistungsfähigen Modellen haben wir schon einmal bei LLMs der Flash-Klasse thematisiert – die spannende Entwicklung bei der Inferenz findet zunehmend am Ende des Spektrums statt, wo die Modelle auf Hardware laufen, die dir gehört.
Urteil: widerlegt, und es ist der gefährlichste Mythos der Liste. Behandle stimmliche Realistik als UI-Eigenschaft, nicht als Fähigkeits- oder Vertrauenssignal – und passe deine persönlichen Sicherheitsgewohnheiten entsprechend an.
Was sich dadurch tatsächlich ändert
Zieh das Marketing von „authentischsten jemals gebauten“ ab (der Titel wurde aus gutem Grund auf Hacker News moderiert), und was übrig bleibt, ist trotzdem bedeutend: Ein durchgängiges Sprachmodell ist eine kategorisch andere Sache als eine Pipeline, und die Unterschiede summieren sich. Emotion bleibt im Regelkreis. Timing wird zu gelerntem Verhalten statt zu einem von Hand eingestellten Schwellenwert. Unterbrechungen werden zu Daten. Nichts davon ist erreichbar, indem man ASR um 50 ms schneller macht.
Meine pragmatische Sicht als jemand, der die alte Architektur ausgeliefert hat: Kaskadierte Pipelines sind nicht tot. Für transaktionale Sprachschnittstellen – Kontostand prüfen, Termin buchen, ein Gerät steuern – sind sie in Ordnung, sie sind debugbar, und jede Stufe lässt sich unabhängig austauschen. Text als Zwischenstufe liefert dir Logging, Schwärzung und Richtliniendurchsetzung gratis, was im Produktivbetrieb enorm wichtig ist. Aber überall dort, wo das Gespräch selbst das Produkt ist – Nachhilfe, Begleitung, Barrierefreiheits-Tools, Verhandlungstraining –, ist die Pipeline eine Sackgasse, und End-to-End-Audio ist die einzige Architektur, die sich jemals natürlich anfühlen kann. Entscheide danach, ob deine Nutzer mit der Maschine sprechen oder durch sie hindurch.
Die offenen Fragen sind die spannenden. Wie gut funktioniert In-Context-Learning, wenn der Kontext Audio ist? Können diese Modelle langen Gesprächszustand halten, ohne die Krücke eines Textprotokolls? Macht emotionale Flüssigkeit Fehler gefährlicher, weil Nutzer der Vortragsweise vertrauen? Und die unbequeme: Sobald diese Qualität von Identitätsimitation lokal auf einem Laptop läuft, wie sieht dann überhaupt noch die Verifizierung menschlicher Identität aus? Die Labore, die diese Fragen ehrlich beantworten, werden mehr zählen als jene mit dem schickesten Demo-Reel.
Stimme ist die älteste Schnittstelle, die Menschen haben. Wir haben vierzig Jahre damit verbracht, sie durch ein textförmiges Loch zu zwängen und uns zu wundern, warum sich das falsch anfühlte. Es stellt sich heraus: Das Loch war das Problem.


