오프라인 우선 AI: 네트워크 없이 도는 LLM 만들기
양자화 모델, 큐레이션된 문서, 검색을 묶어 네트워크 없이도 동작하는 오프라인 우선 AI 구조와 비용을 살펴봅니다.
 Elena Vasquez
정전된 지 아홉 시간이 지났고, 휴대폰 망은 과부하 상태입니다. 차고 냉동고에는 토요일에 산 고기가 가득 들어 있죠. 이걸 먹어도 될까요? 평소라면 챗봇에 물어봤을 겁니다. 지금은 인터넷이 가장 먼저 고장 난 것이죠. 이런 상황이 바로 오프라인 우선(offline-first) AI 도구들의 설계 출발점입니다. 어시스턴트와 참고 자료 라이브러리가 노트북 안에서만 돌아갑니다. 모델, 문서 코퍼스, 검색 인덱스까지 모두 로컬에서 실행되기 때문에 랜선을 뽑아도 "이 물 어떻게 정수하지?" 같은 질문이 똑같이 동작합니다. 저는 이걸 생존 장비라기보다 아키텍처 실험으로 더 흥미롭게 봅니다. 네트워크를 걷어내면 클라우드 AI가 그냥 넘어가던 설계 결정들을 강제로 내려야 하는데, 그 결정들은 비상용 키트 밖에서도 꽤 쓸모가 있습니다. 자기 하드웨어에서 대규모 언어 모델을 돌리는 것을 생각해 보셨다면, 오프라인 어시스턴트의 제약이 바로 그 문제의 가장 날카로운 지점입니다.
오프라인 우선 AI가 실제로 갖춰야 할 것
클라우드 어시스턴트는 얇습니다. 클라이언트가 텍스트를 보내면 데이터센터가 토큰을 돌려주죠. 오프라인 어시스턴트는 이 전체 스택을 일반 소비자용 하드웨어 위에 그대로 복제해야 하고, 그러려면 큰 것 세 가지를 실어 두고 서로 맞물려 돌아가게 해야 합니다. 첫째는 추론 엔진입니다. 실제로는 llama.cpp나 그 파생 버전을 씁니다. Apple Silicon, 일반 x86 CPU, 소비자용 GPU에서 의존성 트리 하나로 돌아가기 때문입니다. Mac 앱은 이걸 번들로 넣고, Windows 빌드는 설치 과정에서 내려받습니다. 어느 쪽이든 사용자 기기에 이미 있다고 가정하면 안 됩니다. 첫 실행 때 조용히 직접 설치해야 합니다. 둘째는 모델입니다. 여기가 가장 흥미로운 부분이고 뒤에서 다시 다루겠습니다. 적절한 모델을 고르는 것이 이 설계의 핵심 문제이기 때문입니다. 셋째는 라이브러리입니다. 이 분야의 한 오프라인 어시스턴트는 위키백과 문서 약 93만 건(가장 많이 읽힌 부분집합), MedlinePlus와 WikiMed 같은 의학 자료, FEMA와 CDC의 재난 대응 지침, 군 생존 매뉴얼, wikiHow, iFixit 수리 가이드, 집수리와 아마추어 무선 같은 주제의 Stack Exchange Q&A 덤프를 함께 싣습니다. 전부 일반 텍스트이고, 라이선스는 문서마다 보존해서 표시합니다. 전체 다운로드는 약 9GB이고 설치하면 19GB로 불어납니다. 위키백과와 iFixit을 뺀 슬림 버전은 1.3GB입니다. 어떤 자료를 살릴지 고른 것은 엔지니어링만큼이나 큐레이션 작업이기도 합니다. 이 모든 것이 5분짜리 클릭 세 번짜리 설치 과정에 들어가야 하고, 다운로드는 최대 두 시간 반이 걸릴 수 있습니다. 마지막 숫자는 생각보다 중요합니다. 다운로드 창은 무언가를 받을 수 있는 유일한 기회이고, 그 뒤로는 기회가 다시 오지 않으니까요. 이건 재부팅도 못 하고 접근도 할 수 없는 소프트웨어에 적용하는 것과 같은 원칙입니다. 다만 접근 불가능한 환경이 폭풍에 불 꺼진 부엌이라는 점만 다릅니다.
모델 티어링 문제: 앱 하나, 여러 개의 뇌
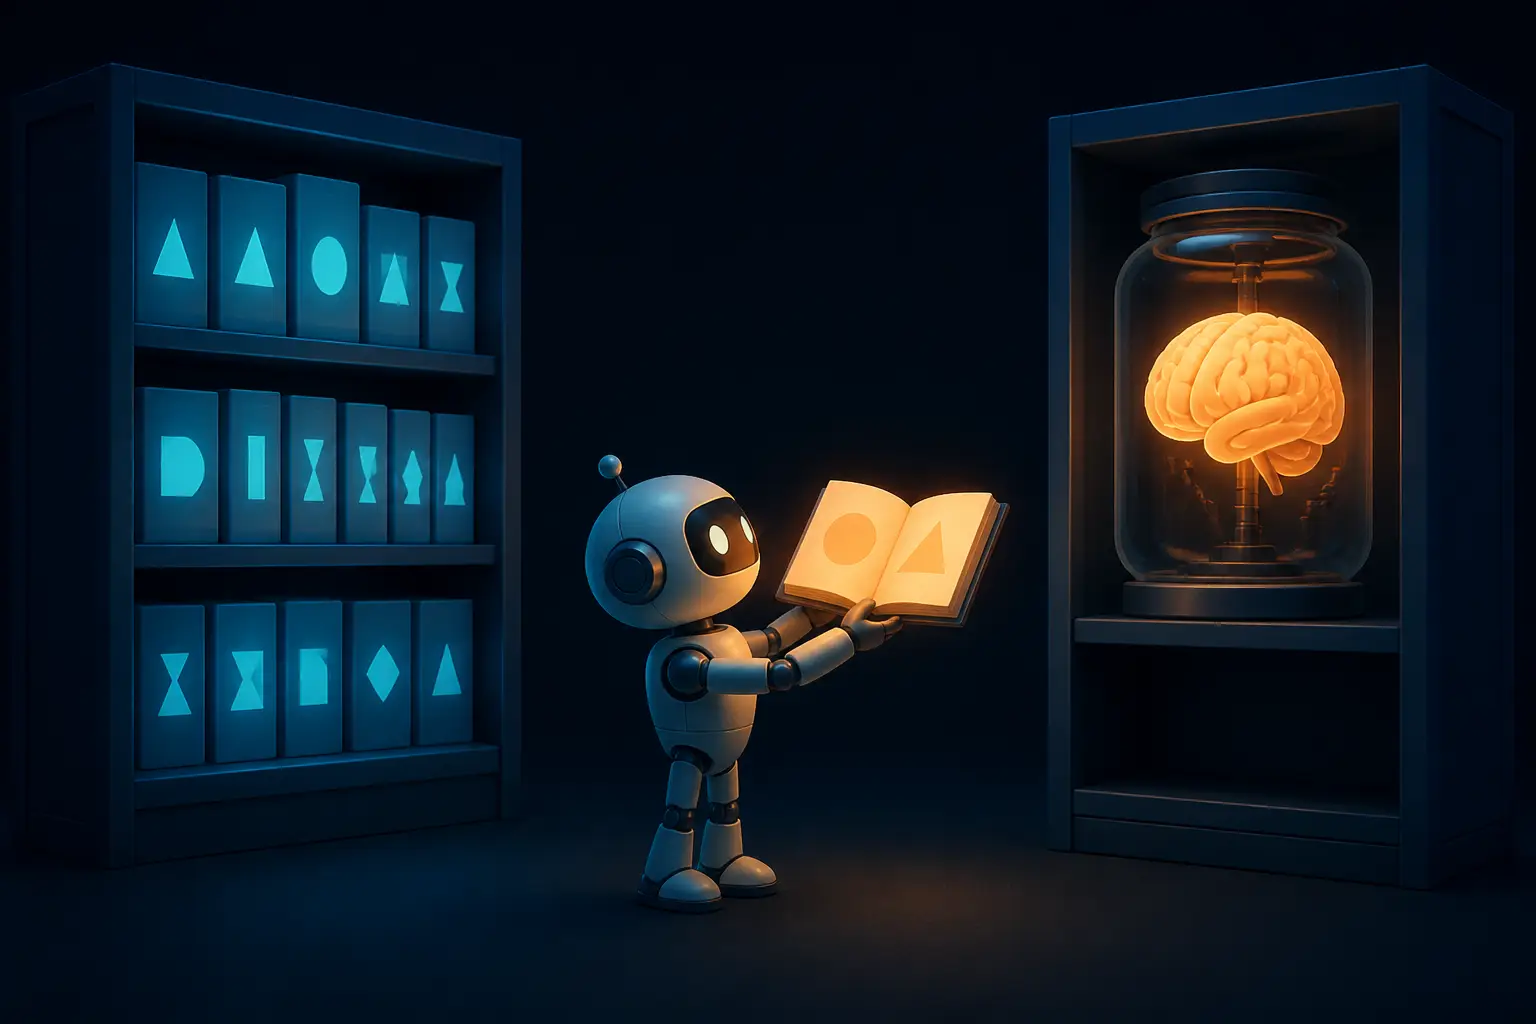
클라우드 소프트웨어는 절대 마주치지 않는 결정이 하나 있습니다. 사용자가 어떤 하드웨어를 갖고 있는지 모르고, RAM을 확인해서 더 큰 클러스터로 보낼 수도 없습니다. 그런데 이 답에 따라 다운로드 크기와 이후 모든 답변의 품질이 결정됩니다. 이 분야 도구들의 해법은 하드웨어를 탐지해 티어를 나누는 방식입니다. 처음 실행하면 앱이 시스템 메모리를 확인하고 들어갈 수 있는 모델을 고릅니다. - 128GB 이상: 플래그십급 대형 모델(한 빌드는 NVIDIA Nemotron 3.5 Super를 사용하며 디스크에서 약 80GB), 프로젝트가 만든 정정·응급처치 블라인드 채점 테스트에서 22문항 중 21점 - 32~96GB: 약 270억 파라미터급 중형 모델(약 18GB), 역시 21점 - Windows 32GB: 속도에 맞춰 튜닝한 약 25GB 모델, 19점 - 16~31GB: 80억 파라미터급 모델(약 6GB), 14점 마지막 줄을 한 번 더 읽어 보세요. 대부분의 사람들이 실제로 가진 기기, 즉 16GB 노트북은 공식 지침의 핵심을 약 3분의 1 가까이 놓치는 뇌를 받습니다. "실온에 여섯 시간 방치된 닭고기는 먹지 마세요" 같은 핵심이 질문인 경우에요. 이것이 오프라인 우선 AI의 불편한 산수입니다. 양자화와 소형 모델은 실제로 많이 좋아졌습니다. 잘 튜닝된 80억 파라미터 모델도 괜찮은 글쓰기 도우미이고 쓸만한 검색 인터페이스입니다. 하지만 품질 곡선은 배포 제약에 맞춰 구부러지지 않습니다. 클라우드 앱이 더 똑똑한 모델을 원하면 설정 플래그 하나를 뒤집으면 됩니다. 오프라인 앱이 같은 것을 원하면 사용자가 3년 전에 더 큰 노트북을 샀어야 합니다. 곡선을 배포하는 셈이고, 곡선이 여러분을 배포합니다. 이 도구들이 택한 현실적인 완화책은 작은 모델을 코퍼스의 권위자가 아니라 코퍼스로 가는 인터페이스로 취급하는 것입니다. 80억 파라미터 티어는 가끔 틀린다는 것을 설계자들이 알고 있기 때문에, 모든 답변에는 어떤 문서를 읽었는지와 해당 구절이 하이라이트되어 나옵니다.
검색은 기능이 아니라 신뢰의 층이다
요즘 검색 증강 생성(RAG) 시스템은 대부분 출처를 보여 줍니다. 클라우드에서는 체크박스 기능이고 투명성을 흉내 내는 연출에 가깝죠. 오프라인에서는 검색이 하중을 지탱하는 구조가 됩니다. 그럴듯하게 들리는 환각과 실제 응급 상황에서 사용자가 그대로 따라 하는 행동 사이에 남은 유일한 장벽이기 때문입니다. 그렇게 나온 설계는 이렇습니다. 모델이 평문 라이브러리를 검색하고, 상위 구절을 읽은 뒤 자기가 읽은 것을 인용하는 답을 씁니다. 사용자가 직접 찾아보라고 하면, 이미 기억에서 답을 했더라도 다시 검색합니다. 그리고 UI는 각 답변이 어떤 모드에서 나왔는지 알려 줍니다. 기억에서 나왔는지, 열어본 문서에서 나왔는지, 열어보지 않은 검색 결과에서 나왔는지 구분합니다. 이 마지막 구분이 미묘하지만 중요합니다. "일치하는 조각을 찾았다"와 "문서를 읽었다"는 신뢰도가 다른 서로 다른 주장이고, 인터페이스도 그렇게 취급합니다. 제가 특히 좋아하는 실패 모드 처리도 있습니다. 모델이 검색은 했는데 최종 답을 쓰지 않고 끝나는 경우가 있습니다. 작은 모델에서 실제로 자주 일어나는 일입니다. 이때 앱은 찾은 문서 중 최선의 것들을 모델에 강제로 먹여서 한 번 더 시도하게 합니다. 사용자에게는 아무것도 안 보여 주지 않는 대신에요. 오프라인에서는 더 큰 모델로 넘어가거나 재시도 큐에 넣을 수 없습니다. 재시도를 에이전트 루프 안에 직접 넣어야 합니다. 이것은 사람들이 LLM 에이전트는 분산 시스템처럼 동작한다고 말할 때 가리키는 작은 예입니다. 어디서든 부분 실패가 일어나고, 오케스트레이션 계층의 역할은 그 실패를 견딜 수 있게 만드는 것입니다. 그대로 가져다 쓸 만한 설계 선택이 하나 더 있습니다. 추론 예산입니다. 앱은 답하기 전에 모델이 생각할 수 있는 토큰 수를 꺼짐, 1,000, 4,000, 16,000, 무제한 중에서 고르게 합니다. 한도에 닿으면 생각을 끊고 지금까지 얻은 것으로 답합니다. 배터리로 돌 때 맴도는 모델은 틀릴 뿐 아니라 전력을 낭비합니다. 하드 상한은 끝없는 연산 문제를 유한한 문제로 바꿔 줍니다. 콘센트가 이론적인 상황에서 필요한 바로 그 감각이죠.
회의론자들의 지적은 맞다 (단, 절반만)
이 장르에 대한 가장 날카로운 비판은 이겁니다. LLM을 빼고 검색 가능한 아카이브를 그냥 배포하면 안 되나? Kiwix는 수년 동안 정확히 그렇게 해 왔습니다. 위키백과와 의학 자료를 압축하고 색인해서 오프라인 검색으로 제공합니다. 환각 위험이 없고, 감자 한 알짜리 컴퓨터에서도 돌아갑니다. 큐레이션된 텍스트 데이터셋이라면 검색 엔진이 오히려 더 믿을 만한 도구일 수 있습니다. 한 테스터는 오프라인 어시스턴트에게 활 드릴 만드는 법을 물었습니다. 부품은 맞췄지만 동작은 틀렸습니다. 모델은 활은 아예 무시하고 손바닥 사이에서 spindle을 굴리는 방식을 설명했고, 마찰 불에서는 나오지 않는 "불씨를 부채질하라"는 말까지 했습니다. 검색 엔진은 아무것도 생성하지 않기 때문에 이런 실수를 할 수 없습니다. 하지만 저는 이 비판이 이런 시스템에서 LLM이 실제로 하는 일을 놓치고 있다고 봅니다. 그리고 이 설계를 가장 강하게 옹호하는 방법은 그 역할을 재정의하는 것입니다. 모델을 신탁이 아니라 검색 지능으로 쓰는 것이죠. 키워드 검색은 용어를 모를 때 실패합니다. 가진 것이 진단명이 아니라 증상이고, 부품 이름이 아니라 고장 난 상태일 때요. 시맨틱 검색은 "의미상 가까운" 것은 찾아 주지만 "기전이나 인과로 연결된" 것은 잘 못 찾습니다. 바로 생성 모델이 메우는 틈입니다. "잎 가장자리가 노랗게 변하는 작물"이라는 질문을 받으면 키워드로는 절대 찾지 못했을 다섯 가지 확인 경로를 만들어 낼 수 있습니다. 모델의 역할은 올바른 페이지로 데려가는 것이고, 페이지의 역할은 옳은 내용을 담는 것입니다. 다른 비판도 있습니다. "종말이 오면 LLM 대신 그냥 기술을 배우면 된다." 인생 조언으로는 맞지만 소프트웨어 비판으로는 쓸모가 없습니다. 누구의 응급처치 지식도 소아 화상, 정수의 화학, 발전기 수리를 전부 담고 있지 않습니다. 책은 이 모든 것을 다룹니다. 논쟁은 인터페이스에 관한 것뿐입니다. 회의론자들이 확실히 맞는 지점은 22문항 중 14점짜리 티어입니다. 인터페이스 계층이 3분의 1 정도 틀리고 모든 답변에 "출처를 확인하세요"라는 면책 문구가 붙어 있다면, 어느 시점에서는 정직한 제품이 검색창이 달린 아카이브일 수 있습니다. LLM은 Ctrl+F보다 비전문가를 올바른 구절로 더 빨리 데려갈 때만 자리를 얻습니다. 이것은 기분의 문제가 아니라 사용자에 대한 경험적 질문입니다.
최소 오프라인 우선 AI 스택
직접 이런 것을 만들어 보고 싶다면 해 보세요. 주말 프로젝트로 정말 배울 것이 많습니다. 뼈대는 예상보다 작습니다. 흥미로운 부분은 코드가 아니라 선택에 있습니다. 검색 우선 로컬 어시스턴트를 Python으로 만들면 대략 이런 모습입니다:
import subprocess
from pathlib import Path
CORPUS_DIR = Path("./library")          # plain-text articles, one file each
MODEL = "./models/granite-8b-q4.gguf"   # quantized to fit 16 GB RAM
def search_corpus(query: str, k: int = 5) -> list[dict]:
"""Dumb but honest: rank articles by keyword overlap.
Swap in BM25 or embeddings later; the interface is the point."""
terms = set(query.lower().split())
hits = []
for f in CORPUS_DIR.rglob("*.txt"):
text = f.read_text(errors="ignore")
score = sum(text.lower().count(t) for t in terms)
if score:
hits.append({"path": f.name, "score": score, "text": text[:3000]})
return sorted(hits, key=lambda h: -h["score"])[:k]
def answer(question: str) -> str:
sources = search_corpus(question)
context = "\n\n".join(
f"[SOURCE {i}: {s['path']}]\n{s['text']}"
for i, s in enumerate(sources, 1)
)
prompt = (
"Answer ONLY from the sources below. Cite them as [SOURCE n]. "
"If they don't cover it, say so.\n\n"
f"{context}\n\nQuestion: {question}\nAnswer:"
)
out = subprocess.run(
["llama-cli", "-m", MODEL, "-p", prompt,
"-n", "512", "--ctx-size", "8192"],
capture_output=True, text=True,
)
citations = "\n".join(f"[{i}] {s['path']}" for i, s in enumerate(sources, 1))
return out.stdout + "\n\n--- Sources ---\n" + citations
print(answer("how long is food safe in a fridge without power"))
이 코드가 장난감이 아니라 제품처럼 느껴지게 만드는 요소는 그 마흔 줄 안에 박힌 제약들에 있습니다. 프롬프트는 출처 밖의 내용에 답하는 것을 금지하고, 인용은 기계적으로 덧붙입니다. 모델이 인용 형식을 맡기지 않습니다. 실제로 한 버그에서는 모델이 자기 검색 명령어를 나열한 "Sources:" 줄을 지어냈습니다. 생성 길이도 상한을 둡니다. 프로덕션에 필요하지만 여기에는 없는 것들도 있습니다. 시맨틱 검색용 임베딩 인덱스, 추론 토큰 예산, 모델 파일을 고르기 위한 메모리 탐지, UI에 표시할 파일별 라이선스 메타데이터입니다. 여기 없는 것에도 주목하세요. 네트워크 호출도, API 키도, 텔레메트리도 없습니다. 모델 파일과 코퍼스가 디스크에 있으면, 이 프로그램은 물리적으로 질문을 유출할 수 없습니다. 프라이버시는 정책이 아니라 의존성 그래프의 결과가 됩니다.
집까지 따라오는 제약들
오프라인 우선으로 만들면 몇 가지 비자명한 제약이 아키텍처의 영구 거주자가 됩니다. **저장 공간과 설치 기회는 한 번뿐입니다.** 전체 라이브러리는 설치 중 약 27GB의 여유 공간이 필요하고, 나중에 19GB로 줄어듭니다. 모든 것은 최초 다운로드 때 도착해야 합니다. 허리케인 한가운데서 빠진 의학 자료를 지연 로딩할 수는 없습니다. 이 때문에 공격적인 큐레이션이 불가피합니다. 93만 건이면 많아 보이지만, 위키백과에 문서가 수백만 건 있다는 것을 떠올리면 누군가 열람량 순위를 매기고 꼬리를 잘라 냈다는 뜻입니다. **전력은 일급 자원입니다.** MacBook Pro에서 측정한 결과, 답변 한 번에 약 100W를 질문당 5~40초 소모합니다. 배터리를 가득 채우면 약 100~300번 답할 수 있습니다. 그러면 긴 사고 사슬은 단지 느린 것이 아니라 연료에 관한 결정이 됩니다. 추론 예산과 소형 모델 티어는 최적화가 아니라 제품 그 자체가 됩니다. **업데이트 채널이 생명선입니다.** 앱은 로컬 상태를 깨뜨리지 않고 모델, 라이브러리, 바이너리를 한 번의 클릭으로 업데이트해야 합니다. 다음에 사용자가 대역폭을 확보하는 시점이 몇 달 뒤일 수도 있기 때문입니다. 백그라운드 리소스 관리도 새로운 의미를 갖습니다. 한 릴리스의 수정으로 Cmd+Q가 드디어 추론 엔진을 완전히 멈추게 되었는데, 이전에는 창을 닫은 뒤에도 수 기가바이트짜리 모델이 메모리에 계속 남아 있었습니다. 배터리 상태에서 이것은 메모리 누수가 아니라 발열과 시간의 누수입니다. **사용자 파일도 신뢰 경계 안으로 들어옵니다.** 사용자가 발전기 매뉴얼이나 가족 비상 계획 같은 자기 PDF를 끌어다 놓을 수 있게 하면, 검색 파이프라인은 스캔된 PDF, 이상한 인코딩, 거대한 파일처럼 적대적으로 지저분한 입력을 처리해야 합니다. 오프라인에서는 이 중 어떤 것도 클라우드 파서에 떠넘길 수 없습니다.
재난 상황을 넘어서 이 패턴이 중요한 이유
프라이버시는 정책 약속이 아니라 의존성 그래프의 결과가 됩니다. 네트워크 호출이 없는 프로그램은 아무것도 유출할 수 없습니다. 영원히.
재난이라는 틀이 헤드라인을 차지하지만, 이야기의 핵심은 아키텍처에 있습니다. 같은 스택, 즉 로컬 추론, 큐레이션된 코퍼스, 인용을 동반한 검색, 하드 연산 예산은 법적으로 건물 밖으로 나갈 수 없는 환자 데이터를 다루는 병원, 에어갭 장비가 있는 공장 바닥, 검색 로그가 곧 위험이 되는 나라의 기자, 메가바이트 단위로 과금되는 위성 인터넷을 쓰는 연구선에 모두 필요합니다. 논의에 참여한 한 실무자는 정확히 이런 방식을 설명했습니다. 휴대폰 신호가 없는 땅에 직접 큐레이션한 라이브러리와 로컬 모델을 두고, 떠날 때마다 갱신했습니다. 광섬유가 연결된 뒤에도 일상의 클라우드 AI 사용 대부분을 점차 대체했다고 합니다. 제가 거는 쪽은 그 궤적입니다. 양자화된 80억 파라미터 로컬 모델과 최전선 API 모델 사이의 격차는 실제로 있지만, 검색에 닻을 둔 작업, 즉 "알맞은 구절을 찾아서 충실하게 요약해 줘" 같은 작업에서는 로컬 옵션이 충분한 경우가 많습니다. 그리고 충분함, 0에 가까운 한계 비용, 보장된 프라이버시의 조합은 설득력 있는 패키지입니다. 최전선 모델은 계속 좋아지고, 양자화도 함께 좋아지며, 소형 모델은 조금 늦게 같은 확장의 파도를 탑니다. 그 곡선의 효율 쪽을 추적하고 계시다면, 진짜 추론 효율 이야기는 플래시급 모델에 있습니다. 이 분야에서 무언가를 설계하신다면 제 조언은 이렇습니다. 패턴을 가져가고 프레퍼 미학은 가져가지 마세요. 가차 없이 큐레이션하세요. 신뢰하는 문서 200개가 읽어 보지도 않은 93만 개보다 낫습니다. 인용은 기계적으로 만들고 모델이 생성하게 하지 마세요. 생각에 하드 예산을 주세요. 그리고 모델이 신탁인지 검색 인터페이스인지 명시적으로 결정하세요. 검증을 견디는 도구는 후자가 되기에 충분히 정직한 도구들입니다.
정리
오프라인 우선 AI는 종말에서 살아남는 법에 관한 것이 아닙니다. 더 큰 모델, 클라우드 폴백, 항상 켜진 네트워크, 무제한 전력 같은 모든 탈출구가 용접으로 막혔을 때 아키텍처가 어떤 모습인지 발견하는 일입니다. 남는 것은 큐레이션된 코퍼스, 통제할 수 없는 하드웨어에 맞춘 양자화 모델, 신뢰를 실어 나르는 검색, 우아하게 실패하도록 만든 에이전트 루프입니다. 이것들은 온라인에서도 좋은 원칙임이 드러납니다. 폭풍이 그저 더 빨리 배우게 할 뿐입니다.


