IA offline: construir un LLM que funciona sin internet
Cómo la IA offline empaqueta modelos cuantizados, corpus curados y recuperación para que un asistente siga funcionando sin red, y qué cuesta.
 Elena Vasquez
Se lleva nueve horas sin luz, la red móvil está saturada y el congelador de tu garaje está lleno de carne que compraste el sábado. ¿Sigue siendo seguro comerla? Normalmente le preguntarías a un chatbot. Ahora mismo, lo primero que se ha roto es internet. Ese escenario es el punto de partida de una categoría creciente de herramientas de IA offline-first: un asistente y una biblioteca de referencia que viven por completo en tu portátil. El modelo, el corpus, el índice de búsqueda… todo se ejecuta en local, así que preguntar «cómo potabilizo esta agua» funciona exactamente igual con el cable de red desenchufado. Me resulta más interesante como ejercicio de arquitectura que como equipo para preppers. Quitar la red obliga a tomar un conjunto de decisiones de ingeniería que la IA alojada en la nube puede ignorar, y esas decisiones resultan útiles mucho más allá de los kits de emergencia. Si alguna vez has pensado en ejecutar modelos de lenguaje grandes en tu propio hardware, las restricciones de un asistente offline son la punta afilada de ese problema.
Lo que la IA offline-first necesita incluir de verdad
Un asistente en la nube es ligero: tu cliente envía texto y un centro de datos devuelve tokens. Un asistente offline tiene que replicar toda esa pila en hardware de consumo, lo que implica incluir tres piezas grandes y mantenerlas en armonía. Primero, el motor de inferencia. En la práctica, esto significa llama.cpp o alguno de sus derivados, porque funciona en Apple Silicon, en CPU x86 normales y en GPU de consumo con un único árbol de dependencias. La app de Mac lo incluye; la versión de Windows lo descarga durante la instalación. En cualquier caso, no puedes dar por hecho que esté en la máquina del usuario: lo instalas tú mismo, en silencio, durante el primer arranque. Segundo, el modelo. Aquí es donde se pone interesante, y volveré sobre ello, porque elegir el modelo adecuado es el problema de diseño central. Tercero, la biblioteca. Un asistente offline de este tipo incluye unos 930.000 artículos de Wikipedia (el subconjunto más leído), referencias médicas como MedlinePlus y WikiMed, guías de emergencia de FEMA y CDC, manuales de supervivencia militar, wikiHow, guías de reparación de iFixit y volcados de preguntas y respuestas de Stack Exchange (Q&A) sobre temas como reparaciones del hogar y radioaficionados. Todo en texto plano, con las licencias conservadas y mostradas por artículo. La descarga completa pesa unos 9 GB y ocupa 19 GB instalada; una versión ligera sin Wikipedia ni iFixit ocupa 1,3 GB. Es tanto un acto de curación como de ingeniería: alguien decidió qué fuentes sobreviven al recorte. Todo tiene que caber en una instalación de tres pasos que lleva cinco minutos de clics y hasta dos horas y media de descarga. Ese último número importa más de lo que parece: la ventana de descarga es tu única oportunidad de traer cualquier cosa, para siempre. Es la misma disciplina que aplicarías a software al que no puedes reiniciar ni alcanzar, solo que el entorno inaccesible es una cocina a oscuras por la tormenta.
El problema de los niveles de modelo: una app, muchos cerebros
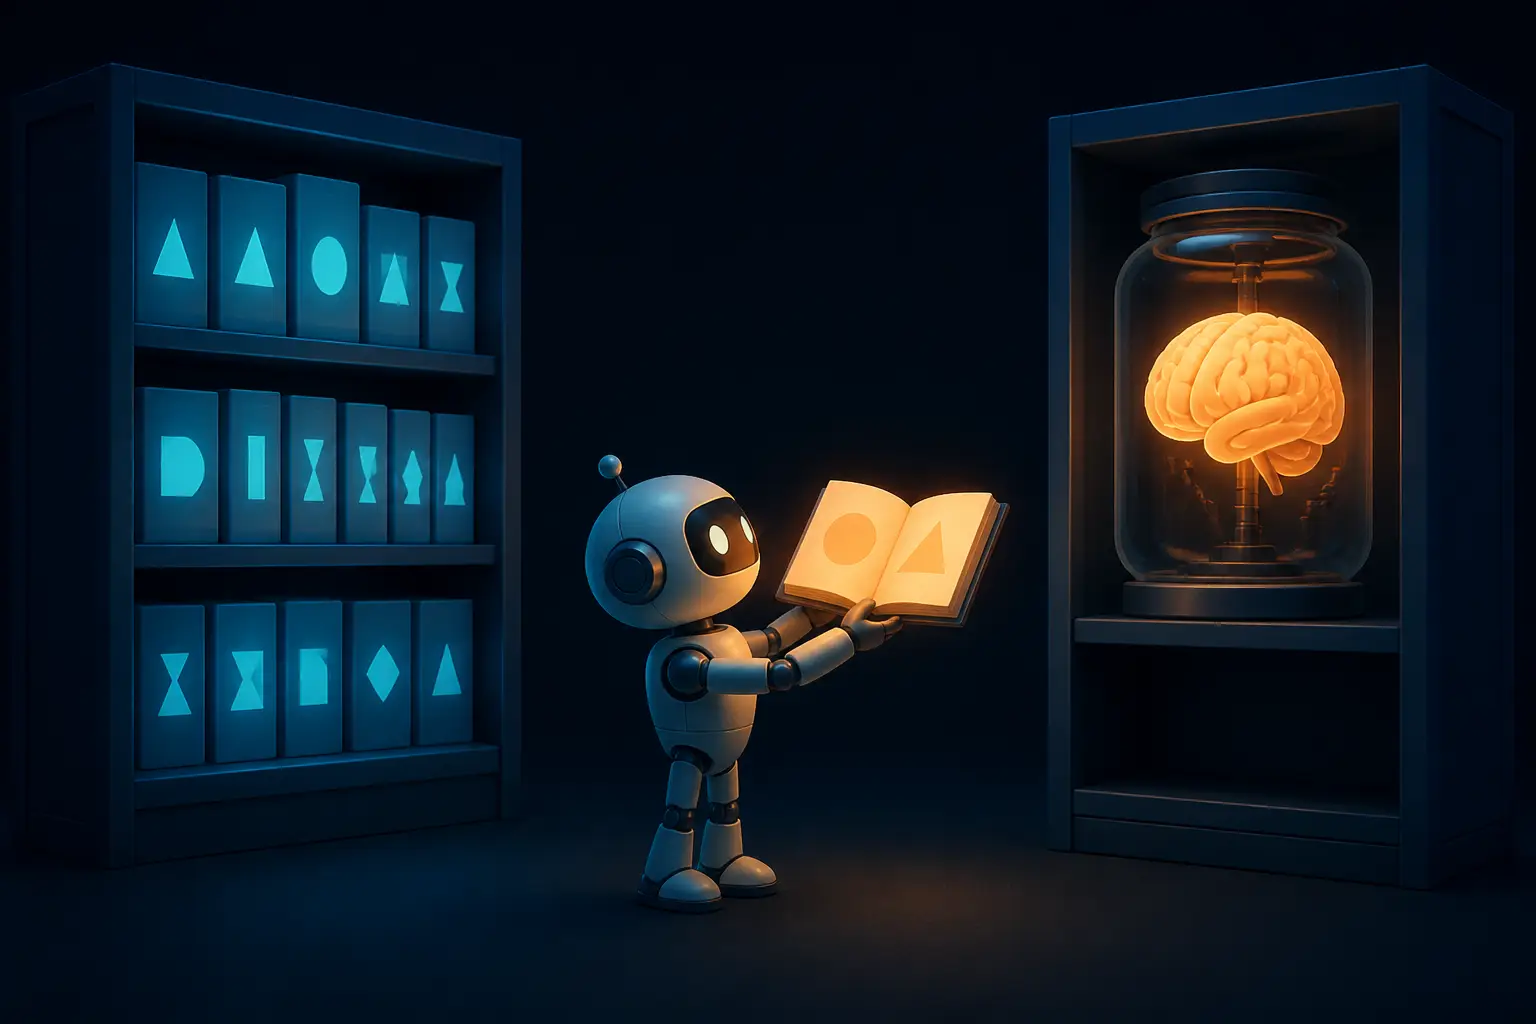
Aquí está la decisión que el software en la nube nunca enfrenta: no sabes qué hardware tiene tu usuario, no puedes sondear su RAM y enviarlo a un clúster más grande, y la respuesta cambia tanto el tamaño de la descarga como la calidad de cada respuesta a partir de entonces. La solución en esta categoría de herramientas es un sistema de niveles según el hardware detectado. En el primer arranque, la app comprueba la memoria del sistema y elige un modelo que quepa: - 128 GB o más: un modelo grande de gama alta (una versión usa NVIDIA Nemotron 3.5 Super, unos 80 GB en disco), con 21 de 22 en el test a ciegas del proyecto sobre preguntas de apagones y primeros auxilios. - 32–96 GB: un modelo de tamaño medio de unos 27B parámetros (~18 GB), también con 21 de 22. - 32 GB en Windows: un modelo de ~25 GB optimizado para velocidad, con 19 de 22. - 16–31 GB: un modelo de clase 8B (~6 GB), con 14 de 22. Lee otra vez esa última fila. La máquina que tiene la mayoría de la gente (un portátil de 16 GB) recibe un cerebro que falla en la idea principal de las guías oficiales alrededor de un tercio de las veces, en preguntas donde la idea principal es cosas como «no comas el pollo que ha estado seis horas a temperatura ambiente». Esta es la aritmética incómoda de la IA offline-first. La cuantización y los modelos pequeños han mejorado de verdad: un modelo 8B bien afinado es un buen asistente de escritura y una interfaz de búsqueda decente. Pero la curva de calidad no se doblega para encajar en tus restricciones de despliegue. Cuando una app en la nube quiere un modelo más listo, cambia un flag de configuración. Cuando una app offline lo quiere, necesita que el usuario haya comprado un portátil más grande hace tres años. Tú envías la curva, y la curva te envía a ti. La mitigación honesta es la que adoptan estas herramientas: tratar el modelo pequeño como una interfaz hacia el corpus, no como una autoridad sobre él. Cada respuesta enumera exactamente qué artículos se leyeron, con el pasaje resaltado, porque los diseñadores saben que el nivel 8B a veces se equivocará.
La recuperación como capa de confianza, no como funcionalidad
Hoy en día, todos los sistemas de generación aumentada por recuperación (RAG) muestran sus fuentes; en la nube es una casilla de verificación, una especie de teatro de transparencia. Offline, la recuperación soporta toda la carga. Es lo único que se interpone entre una alucinación con apariencia plausible y un usuario que actúa sobre ella en una emergencia real. El diseño que surge se ve así: el modelo busca en la biblioteca de texto plano, lee los pasajes más relevantes y escribe una respuesta que cita lo que leyó. Si el usuario le pide que busque algo, lo hace aunque ya hubiera respondido de memoria, y la interfaz indica de qué modo proviene cada respuesta: memoria, artículos que abrió o resultados de búsqueda que nunca abrió. Esa última distinción es sutil e importante. «Encontré fragmentos coincidentes» y «leí el artículo» son afirmaciones distintas con fiabilidad distinta, y la interfaz las trata así. Hay también un detalle sobre modos de fallo que me encanta: cuando el modelo fue a buscar pero nunca escribió una respuesta final (algo real que hacen los modelos pequeños), la app le vuelve a inyectar a la fuerza los mejores artículos que encontró y le pide que lo intente una vez más, en lugar de mostrarle al usuario nada. Offline no puedes recurrir a un modelo más grande ni a una cola de reintentos. Construyes el reintento dentro del bucle del agente. Es un ejemplo compacto de lo que se quiere decir cuando se afirma que los agentes de LLM se comportan como sistemas distribuidos: fallos parciales por todas partes, y la capa de orquestación tiene que hacer que el fallo sea sobrevivible. Una elección arquitectónica más que vale la pena copiar: el presupuesto de razonamiento. La app expone cuántos tokens puede pensar el modelo antes de responder (desactivado, 1.000, 4.000, 16.000 o sin límite) y, al llegar al límite, el razonamiento se corta y el modelo responde con lo que tenga. Con batería, un modelo que da vueltas en círculos no solo se equivoca: drena energía. Un tope duro convierte un problema de cómputo sin límite en uno acotado, que es exactamente el instinto que quieres cuando el enchufe de la pared es teórico.
Los escépticos tienen razón (sobre la mitad equivocada)
La crítica más afilada a todo este género: ¿por qué no prescindir del LLM y enviar un archivo con buscador? Kiwix lleva años haciendo exactamente eso: Wikipedia y referencias médicas, comprimidas, indexadas, con búsqueda offline, sin riesgo de alucinación, y funciona en un ordenador muy modesto. Y para un conjunto de datos de texto curado, un motor de búsqueda es quizá la herramienta más fiable. Un tester le preguntó al asistente offline cómo construir un arco de fricción y obtuvo bien las piezas pero mal el movimiento: el modelo describió girar el huso entre las manos, ignorando por completo el arco, y mencionó «avivar las chispas», algo que un fuego por fricción no produce. Un buscador no puede cometer ese error porque no genera nada. Pero creo que esta crítica pasa por alto para qué sirve realmente el LLM en estos sistemas, y la mejor defensa del diseño es reposicionarlo: usar el modelo como inteligencia de búsqueda, no como oráculo. La búsqueda por palabras clave falla cuando no conoces el vocabulario: cuando lo que tienes son síntomas, no un diagnóstico; una cosa rota, no el nombre de una pieza. La recuperación semántica ayuda con lo «cercano en significado», pero no con lo «conectado por mecanismo o causa», que es justo el hueco que cubre un modelo generativo: puede tomar «cultivos que amarillean por los bordes de las hojas» y producir las cinco rutas de lectura que una palabra clave nunca habría encontrado. El trabajo del modelo es llevarte a las páginas correctas. El trabajo de las páginas es ser correctas. La otra crítica, «si necesitas un LLM durante el apocalipsis, aprende las habilidades», es razonable como consejo de vida y inútil como crítica de software. Nadie tiene conocimientos de primeros auxilios que cubran quemaduras pediátricas, química de potabilización y reparación de generadores. Los libros lo cubren todo; el debate solo trata de la interfaz. Donde los escépticos aciertan de lleno es en el nivel de 14 de 22. Si la capa de interfaz se equivoca un tercio de las veces y cada respuesta lleva un aviso de «revisa las fuentes», en algún momento el producto honesto es el archivo con un cuadro de búsqueda. El LLM solo se gana su lugar en la medida en que demuestre que lleva a los no expertos al pasaje correcto más rápido que Ctrl+F. Eso es una pregunta empírica sobre tus usuarios, no una sensación.
Una pila mínima de IA offline-first
Si quisieras construir tu propia versión de esto (y deberías, es un proyecto de fin de semana muy instructivo), el esqueleto es más pequeño de lo que esperas. Lo interesante son las decisiones, no el código. Un asistente local con recuperación primero en Python se parece, a grandes rasgos, a esto:
import subprocess
from pathlib import Path
CORPUS_DIR = Path("./library")          # plain-text articles, one file each
MODEL = "./models/granite-8b-q4.gguf"   # quantized to fit 16 GB RAM
def search_corpus(query: str, k: int = 5) -> list[dict]:
"""Dumb but honest: rank articles by keyword overlap.
Swap in BM25 or embeddings later; the interface is the point."""
terms = set(query.lower().split())
hits = []
for f in CORPUS_DIR.rglob("*.txt"):
text = f.read_text(errors="ignore")
score = sum(text.lower().count(t) for t in terms)
if score:
hits.append({"path": f.name, "score": score, "text": text[:3000]})
return sorted(hits, key=lambda h: -h["score"])[:k]
def answer(question: str) -> str:
sources = search_corpus(question)
context = "\n\n".join(
f"[SOURCE {i}: {s['path']}]\n{s['text']}"
for i, s in enumerate(sources, 1)
)
prompt = (
"Answer ONLY from the sources below. Cite them as [SOURCE n]. "
"If they don't cover it, say so.\n\n"
f"{context}\n\nQuestion: {question}\nAnswer:"
)
out = subprocess.run(
["llama-cli", "-m", MODEL, "-p", prompt,
"-n", "512", "--ctx-size", "8192"],
capture_output=True, text=True,
)
citations = "\n".join(f"[{i}] {s['path']}" for i, s in enumerate(sources, 1))
return out.stdout + "\n\n--- Sources ---\n" + citations
print(answer("how long is food safe in a fridge without power"))
Todo lo que hace que esto parezca un producto y no un juguete está en las restricciones incorporadas en esas cuarenta líneas: el prompt prohíbe responder fuera de las fuentes, las citas se añaden de forma mecánica (nunca confiando en que el modelo las formatee: un error real hizo que los modelos inventaran una línea «Fuentes:» que enumeraba sus propios comandos de búsqueda), y la longitud de la generación está limitada. Lo que falta aquí pero es necesario en producción: un índice de embeddings para la búsqueda semántica, un presupuesto de tokens de razonamiento, sondeo de memoria para elegir el archivo del modelo y metadatos de licencia por archivo para que la interfaz los muestre. Fíjate en lo que no hay: ninguna llamada de red, ninguna clave de API, ninguna telemetría. Una vez que el archivo del modelo y el corpus existen en disco, este programa es físicamente incapaz de filtrar una pregunta. La privacidad deja de ser una política y se convierte en una consecuencia del grafo de dependencias.
Las restricciones que vuelven contigo a casa
Si construyes offline-first, unas cuantas restricciones poco obvias se convierten en residentes permanentes de tu arquitectura. **El almacenamiento y las ventanas de instalación son de un solo intento.** La biblioteca completa necesita unos 27 GB libres durante la instalación antes de asentarse en 19 GB, y todo tiene que llegar durante la descarga inicial. No hay carga diferida de una referencia médica que falte en mitad de un huracán. Esto te empuja hacia una curación agresiva: 930.000 artículos suena a mucho hasta que recuerdas que Wikipedia tiene millones; alguien ordenó por lectura y recortó la cola. **La energía es un recurso de primera clase.** Medido en un MacBook Pro, responder consume unos 100 W durante 5 a 40 segundos por pregunta; una batería llena da para unas 100 a 300 respuestas. De pronto, una cadena de razonamiento larga no solo es lenta: es una decisión sobre combustible. Los presupuestos de razonamiento y los niveles de modelo pequeños dejan de ser optimizaciones y se convierten en el producto. **Tu canal de actualización es tu salvavidas.** La app tiene que actualizar modelos, biblioteca y binario de un clic sin romper el estado local, porque la próxima vez que el usuario tenga ancho de banda puede estar a meses de distancia. Y la disciplina con los recursos en segundo plano importa de una forma nueva: una corrección en una versión hizo que Cmd+Q detuviera de verdad el motor de inferencia, que había mantenido un modelo de varios gigabytes residente en memoria después de cerrar la ventana. Con batería, eso no es una fuga de memoria, es una fuga de calor y de horas. **Los archivos del usuario entran en el límite de confianza.** Permitir que los usuarios suelten sus propios PDF (un manual de generador, un plan familiar de emergencia) significa que tu canal de recuperación ahora maneja entradas adversarialmente desordenadas: PDF escaneados, codificaciones raras, archivos enormes. Offline, no puedes delegar nada de eso en un analizador en la nube.
Por qué este patrón importa más allá de las emergencias
La privacidad deja de ser una promesa de política y se convierte en una consecuencia del grafo de dependencias. Un programa sin llamadas de red no puede filtrar nada, nunca.
El encuadre de emergencia es el que acapara los titulares, pero la historia es la arquitectura. La misma pila (inferencia local, corpus curado, recuperación con citas, presupuestos de cómputo estrictos) es lo que quieres para una clínica con datos de pacientes que legalmente no pueden salir del edificio, una planta de fábrica con máquinas aisladas de la red, un periodista en un país donde un registro de consultas es un riesgo, o un barco de investigación con internet por satélite facturado por megabyte. Un profesional de la discusión describió exactamente esto: una biblioteca curada a mano más modelos locales en una propiedad sin cobertura móvil, actualizada antes de cada viaje, que poco a poco sustituyó la mayor parte de su uso diario de IA en la nube incluso con fibra disponible. Esa es la trayectoria por la que apostaría. La distancia entre un modelo local 8B cuantizado y un modelo de API de vanguardia es real pero lo bastante estrecha como para que, en tareas ancladas en recuperación («encuentra el pasaje correcto y resúmelo fielmente»), la opción local suela ser suficiente, y suficiencia más coste marginal cero más privacidad garantizada es un paquete muy atractivo. Los modelos de vanguardia siguen mejorando, pero también la cuantización, y los modelos pequeños montan la misma ola de escalado con un retraso. Si sigues el extremo de eficiencia de esa curva, los modelos de nivel flash son donde está la verdadera historia de eficiencia de inferencia. Mi consejo si diseñas algo en este terreno: copia el patrón, no la estética de preppers. Cura sin piedad: una biblioteca de 200 documentos en los que confías vale más que 930.000 que no has leído. Haz que las citas sean mecánicas, nunca generadas por el modelo. Dale al modelo un presupuesto duro para pensar. Y decide explícitamente si tu modelo es un oráculo o una interfaz de búsqueda. Las herramientas que sobreviven al escrutinio son las bastante honestas como para ser lo segundo.
Conclusión
La IA offline-first no trata de sobrevivir al apocalipsis. Trata de descubrir cómo es tu arquitectura cuando todas las salidas de emergencia (un modelo más grande, un respaldo en la nube, una red siempre activa, energía ilimitada) están selladas. Lo que queda es un corpus curado, un modelo cuantizado dimensionado para hardware que no controlas, una recuperación que carga con la confianza y un bucle de agente diseñado para fallar con elegancia. Esas disciplinas resultan ser buenas también en línea. La tormenta solo te obliga a aprenderlas más rápido.


