IA offline-first: costruire un LLM che funziona senza rete
Come l'IA offline-first impacchetta modelli quantizzati, corpus curati e retrieval per restare operativa senza rete, e cosa costa davvero.
 Elena Vasquez
Da nove ore manca la corrente, la rete cellulare è intasata e il congelatore in garage è pieno di carne comprata sabato. È ancora sicura da mangiare? Di solito chiederesti a un chatbot. Adesso, però, la prima cosa a rompersi è proprio internet. Questo scenario è il brief di progetto per una classe sempre più ampia di strumenti AI offline-first: un assistente e una biblioteca di riferimento che vivono interamente sul tuo laptop. Il modello, il corpus, l'indice di ricerca sono tutti in esecuzione in locale, quindi chiedere «come purifico quest'acqua» funziona esattamente allo stesso modo anche con il cavo ethernet staccato. Lo trovo più interessante come esercizio di architettura che come attrezzatura da survivalista. Togliere la rete costringe a prendere decisioni ingegneristiche che l'AI in cloud può ignorare, e quelle decisioni si rivelano utili ben oltre i kit di emergenza. Se ti sei già posto il problema di far girare large language model sul tuo hardware, i vincoli di un assistente offline ne sono la punta più affilata.
Cosa deve davvero includere un'AI offline-first
Un assistente in cloud è leggero: il tuo client invia testo, un data center rimanda token. Un assistente offline deve replicare l'intero stack su hardware di consumo, il che significa spedire tre componenti grossi e farli andare d'accordo. Primo, il motore di inferenza. In pratica si tratta di llama.cpp o di una delle sue derivate, perché gira su Apple Silicon, CPU x86 standard e GPU consumer con un unico albero di dipendenze. L'app per Mac lo include; la build per Windows lo scarica durante il setup. In ogni caso non puoi dare per scontato che sia presente sulla macchina dell'utente: lo installi tu, in silenzio, al primo avvio. Secondo, il modello. Qui le cose si fanno interessanti, e ci torno, perché scegliere il modello giusto è il problema di progettazione centrale. Terzo, la biblioteca. Un assistente offline in questo settore include circa 930.000 articoli di Wikipedia (il sottoinsieme più letto), riferimenti medici come MedlinePlus e WikiMed, linee guida d'emergenza di FEMA e CDC, manuali di sopravvivenza militari, wikiHow, guide di riparazione di iFixit e dump di Q&A di Stack Exchange su temi come riparazioni domestiche e radioamatori. Tutto è testo semplice, con le licenze conservate e mostrate per ogni articolo. Il download completo pesa circa 9 GB e arriva a 19 GB installato; una versione ridotta senza Wikipedia e iFixit è da 1,3 GB. È tanto un atto di curatela quanto di ingegneria: qualcuno ha deciso quali fonti sopravvivono al taglio. Tutto deve stare in una procedura di setup in tre passaggi che richiede cinque minuti di clic e fino a due ore e mezza di download. Quest'ultimo numero conta più di quanto sembri: la finestra di download è l'unica occasione per scaricare qualcosa, mai più. È la stessa disciplina che applicheresti a software che non puoi riavviare né raggiungere, solo che l'ambiente irraggiungibile è una cucina buia per la tempesta.
Il problema della scelta del modello: un'app, tanti cervelli
Ecco la decisione che il software in cloud non affronta mai: non sai che hardware ha l'utente, non puoi sondarne la RAM e instradarlo verso un cluster più grande, e la risposta cambia sia la dimensione del download sia la qualità di ogni risposta da lì in poi. La soluzione adottata da questa categoria di strumenti è una scelta di tier basata sull'hardware. Al primo avvio, l'app controlla la memoria di sistema e sceglie un modello che ci sta: - 128 GB o più: un modello di classe ammiraglia (una build usa NVIDIA Nemotron 3.5 Super, circa 80 GB su disco), con 21 risposte giuste su 22 nel test alla cieca del progetto su domande di blackout e primo soccorso. - 32–96 GB: un modello di medie dimensioni da circa 27B parametri (circa 18 GB), anch'esso 21 su 22. - 32 GB su Windows: un modello da circa 25 GB ottimizzato per la velocità, 19 su 22. - 16–31 GB: un modello di classe 8B (circa 6 GB), 14 su 22. Rileggi l'ultima riga. La macchina che possiede la maggior parte della gente, un laptop da 16 GB, ottiene un cervello che manca il punto principale delle indicazioni ufficiali circa un terzo delle volte, su domande in cui il punto principale è cose come «non mangiare il pollo che è stato a temperatura ambiente per sei ore». Questa è l'aritmetica scomoda dell'AI offline-first. Quantizzazione e modelli piccoli sono migliorati davvero: un modello 8B ben tarato è un buon assistente di scrittura e un'interfaccia di ricerca decente. Ma la curva di qualità non si piega per adattarsi ai vincoli del tuo deployment. Quando un'app in cloud vuole un modello più intelligente, cambia un flag di configurazione. Quando lo vuole un'app offline, serve che l'utente abbia comprato un laptop più grosso tre anni fa. La curva la spedisci tu, e la curva spedisce te. La mitigazione onesta è quella che questi strumenti adottano: trattare il modello piccolo come un'interfaccia verso il corpus, non come un'autorità su di esso. Ogni risposta elenca esattamente quali articoli sono stati letti, con il passaggio evidenziato, perché i progettisti sanno che il tier 8B a volte sbaglierà.
Il retrieval come livello di fiducia, non come funzionalità
Ogni sistema di retrieval-augmented generation oggi mostra le fonti; in cloud è una casella da spuntare, un po' di teatro della trasparenza. Offline, il retrieval è portante. È l'unica cosa che separa un'allucinazione dall'aspetto plausibile da un utente che agisce su di essa in una vera emergenza. Il design che ne esce è questo: il modello cerca nella biblioteca in testo semplice, legge i passaggi più pertinenti e scrive una risposta che cita ciò che ha letto. Se l'utente gli chiede di cercare qualcosa, cerca anche se aveva già risposto dalla memoria, e l'interfaccia indica da quale modalità arriva ogni risposta: memoria, articoli aperti o risultati di ricerca mai aperti. L'ultima distinzione è sottile e importante. «Ho trovato snippet corrispondenti» e «ho letto l'articolo» sono affermazioni diverse con affidabilità diverse, e l'interfaccia le tratta così. C'è anche un dettaglio sul failure mode che adoro: quando il modello è andato a cercare ma non ha mai scritto una risposta finale, cosa che i modelli piccoli fanno davvero, l'app ora gli dà in pasto forzatamente i migliori articoli trovati e gli fa riprovare una volta, invece di mostrare all'utente il nulla. Offline non puoi ripiegare su un modello più grande o su una coda di retry. Il retry lo costruisci dentro il loop dell'agente. È un esempio compatto di ciò che si intende quando si dice che gli agenti LLM si comportano come sistemi distribuiti: fallimenti parziali ovunque, e il compito del livello di orchestrazione è rendere il fallimento sopportabile. Un'altra scelta architetturale da copiare: il budget di ragionamento. L'app espone quanti token il modello può usare per pensare prima di rispondere (disattivato, 1.000, 4.000, 16.000 o illimitato), e al limite il ragionamento viene tagliato e il modello risponde con quello che ha. A batteria, un modello che gira in tondo non è solo sbagliato, è uno spreco di energia. Un tetto rigido trasforma un problema di calcolo illimitato in uno limitato, che è esattamente l'istinto giusto quando la presa di corrente è teorica.
Gli scettici hanno un punto (sulla metà sbagliata)
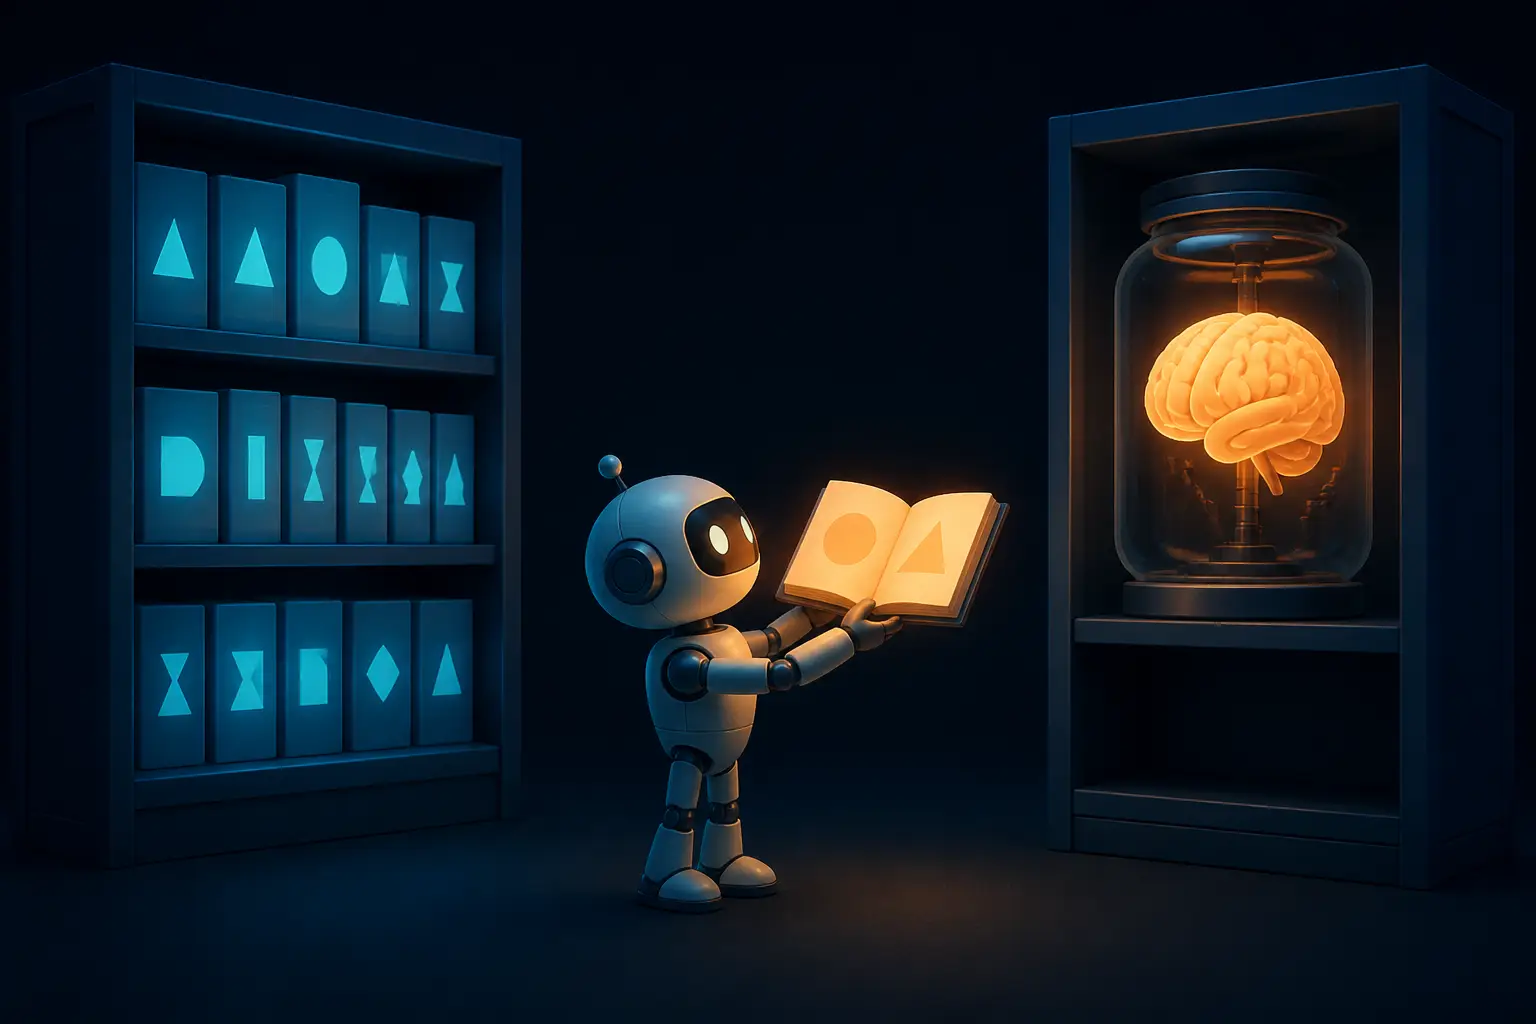
La critica più dura a questo intero genere: perché non saltare l'LLM e distribuire un archivio ricercabile? Kiwix lo fa da anni con Wikipedia e riferimenti medici, compressi, indicizzati, ricercabili offline, senza rischio di allucinazioni, e gira anche su un computer da quattro soldi. Per un dataset di testo curato, un motore di ricerca è probabilmente lo strumento più affidabile. Un tester ha chiesto all'assistente offline come costruire un archetto per il fuoco per attrito e ha ottenuto le parti giuste ma il movimento sbagliato: il modello descriveva il far rotolare il fuso tra le mani, ignorando del tutto l'archetto, e parlava di «soffiare sulle scintille», cosa che un fuoco per attrito non produce. Un motore di ricerca non può fare questo errore perché non genera nulla. Ma credo che questa critica manchi cosa serve davvero l'LLM in questi sistemi, e la difesa più forte del design è riposizionarlo: usare il modello come intelligenza di ricerca, non come oracolo. La ricerca per parole chiave fallisce quando non conosci il vocabolario: quando hai sintomi e non una diagnosi, una cosa rotta e non il nome di un pezzo. Il retrieval semantico aiuta con il «vicino per significato», ma non con il «collegato per meccanismo o causa», che è esattamente il vuoto che un modello generativo colma: può prendere «foglie che ingialliscono ai bordi» e produrre i cinque percorsi di lettura che una parola chiave non avrebbe mai trovato. Il compito del modello è portarti alle pagine giuste. Il compito delle pagine è essere giuste. L'altra critica, «se durante l'apocalisse ti serve un LLM, impara semplicemente le competenze», è giusta come consiglio di vita e inutile come critica al software. Nessuno ha le conoscenze di primo soccorso che coprono ustioni pediatriche, chimica della purificazione dell'acqua e riparazione di generatori. I libri coprono tutto; l'argomento riguarda solo l'interfaccia. Dove gli scettici centrano davvero il bersaglio è il tier 14-su-22. Se il livello dell'interfaccia sbaglia un terzo delle volte e ogni risposta porta un disclaimer «controlla le fonti», a un certo punto il prodotto onesto è l'archivio con una casella di ricerca. L'LLM si guadagna il suo posto solo nella misura in cui dimostrabilmente porta i non esperti al passaggio giusto più in fretta di quanto faccia Ctrl+F. È una domanda empirica sui tuoi utenti, non una sensazione.
Uno stack minimo per un'AI offline-first
Se volessi costruire una tua versione di questo (e dovresti, è un progetto per un weekend davvero istruttivo), lo scheletro è più piccolo di quanto pensi. Le parti interessanti sono le scelte, non il codice. Un assistente locale basato prima sul retrieval in Python assomiglia più o meno a questo:
import subprocess
from pathlib import Path
CORPUS_DIR = Path("./library")          # plain-text articles, one file each
MODEL = "./models/granite-8b-q4.gguf"   # quantized to fit 16 GB RAM
def search_corpus(query: str, k: int = 5) -> list[dict]:
"""Dumb but honest: rank articles by keyword overlap.
Swap in BM25 or embeddings later; the interface is the point."""
terms = set(query.lower().split())
hits = []
for f in CORPUS_DIR.rglob("*.txt"):
text = f.read_text(errors="ignore")
score = sum(text.lower().count(t) for t in terms)
if score:
hits.append({"path": f.name, "score": score, "text": text[:3000]})
return sorted(hits, key=lambda h: -h["score"])[:k]
def answer(question: str) -> str:
sources = search_corpus(question)
context = "\n\n".join(
f"[SOURCE {i}: {s['path']}]\n{s['text']}"
for i, s in enumerate(sources, 1)
)
prompt = (
"Answer ONLY from the sources below. Cite them as [SOURCE n]. "
"If they don't cover it, say so.\n\n"
f"{context}\n\nQuestion: {question}\nAnswer:"
)
out = subprocess.run(
["llama-cli", "-m", MODEL, "-p", prompt,
"-n", "512", "--ctx-size", "8192"],
capture_output=True, text=True,
)
citations = "\n".join(f"[{i}] {s['path']}" for i, s in enumerate(sources, 1))
return out.stdout + "\n\n--- Sources ---\n" + citations
print(answer("how long is food safe in a fridge without power"))
Tutto ciò che fa sembrare questo un prodotto e non un giocattolo sta nei vincoli incorporati in quelle quaranta righe: il prompt vieta di rispondere al di fuori delle fonti, le citazioni vengono aggiunte in modo meccanico (senza mai fidarsi che il modello le formatti; un bug reale riguardava modelli che inventavano una riga «Sources:» con l'elenco dei propri comandi di ricerca), e la lunghezza della generazione è limitata. Manca qui ma è necessario in produzione: un indice di embedding per la ricerca semantica, un budget di token di ragionamento, il sondaggio della memoria per scegliere il file del modello e i metadati di licenza per ogni file, così l'interfaccia può mostrarli. Nota cosa non c'è: nessuna chiamata di rete, nessuna API key, nessuna telemetria. Una volta che il file del modello e il corpus esistono su disco, questo programma è fisicamente incapace di far trapelare una domanda. La privacy smette di essere una policy e diventa una conseguenza del grafo delle dipendenze.
I vincoli che ti seguono a casa
Se costruisci offline-first, alcuni vincoli non ovvi diventano residenti permanenti della tua architettura. **Storage e finestre di installazione sono una tantum.** La biblioteca completa richiede circa 27 GB di spazio libero durante l'installazione prima di assestarsi a 19 GB, e tutto deve arrivare durante il download iniziale. Non esiste un caricamento pigro di un riferimento medico mancante durante un uragano. Questo ti spinge verso una curatela aggressiva: 930.000 articoli sembrano tanti finché non ricordi che Wikipedia ne ha milioni; qualcuno ha ordinato per numero di lettori e tagliato la coda. **L'energia è una risorsa di primo livello.** Misurato su un MacBook Pro, rispondere assorbe circa 100 W per 5–40 secondi a domanda: una batteria piena compra circa 100–300 risposte. Di colpo il chain-of-thought lungo non è solo lento, è una decisione sul carburante. I budget di ragionamento e i tier di modelli piccoli smettono di essere ottimizzazioni e diventano il prodotto. **Il tuo canale di aggiornamento è la tua ancora di salvezza.** L'app deve aggiornare modelli, biblioteca e binario con un clic senza rompere lo stato locale, perché la prossima volta che l'utente avrà banda potrebbero passare mesi. E la disciplina sulle risorse in background conta in un modo nuovo: un fix in una release ha fatto sì che Cmd+Q fermasse davvero il motore di inferenza, che aveva tenuto un modello da diversi gigabyte residente in memoria dopo la chiusura della finestra. A batteria non è un memory leak, è una perdita di calore e di ore. **I file dell'utente entrano nel confine di fiducia.** Lasciare che gli utenti caricino i propri PDF (il manuale di un generatore, un piano di emergenza familiare) significa che la tua pipeline di retrieval gestisce input avversariamente disordinati: PDF scansionati, codifiche strane, file enormi. Offline non puoi delegare nulla di tutto questo a un parser in cloud.
Perché questo schema conta oltre le emergenze
La privacy smette di essere una promessa di policy e diventa una conseguenza del grafo delle dipendenze. Un programma senza chiamate di rete non può far trapelare nulla, mai.
La cornice dell'emergenza fa i titoli, ma l'architettura è la storia. Lo stesso stack (inferenza locale, corpus curato, retrieval con citazioni, budget di calcolo rigidi) è ciò che serve a una clinica con dati di pazienti che per legge non possono uscire dall'edificio, a una linea di produzione con macchine air-gapped, a un giornalista in un paese dove un log delle query è una responsabilità, o a una nave di ricerca con internet satellitare fatturato a megabyte. Un professionista nella discussione ha descritto esattamente questo: una biblioteca curata a mano più modelli locali in una proprietà senza copertura cellulare, aggiornata prima di ogni viaggio, che sta gradualmente sostituendo la maggior parte del suo uso quotidiano di AI in cloud anche quando c'è la fibra. È la traiettoria su cui scommetterei. Il divario tra un modello locale 8B quantizzato e un modello API di frontiera è reale ma abbastanza stretto da rendere, per compiti ancorati al retrieval («trovami il passaggio giusto e riassumilo fedelmente»), l'opzione locale spesso sufficiente, e la sufficienza più costo marginale zero più privacy garantita è un pacchetto convincente. I modelli di frontiera continuano a migliorare, ma anche la quantizzazione migliora, e i modelli piccoli cavalcano la stessa onda di scaling con un ritardo. Se segui il lato dell'efficienza di questa curva, i modelli di classe flash sono dove sta la vera storia dell'efficienza dell'inferenza. Il mio consiglio se stai progettando qualcosa in questo spazio: copia lo schema, non l'estetica da survivalista. Cura senza pietà: una biblioteca di 200 documenti di cui ti fidi batte 930.000 che non hai letto. Rendi le citazioni meccaniche, mai generate dal modello. Dai al modello un budget rigido per pensare. E decidi esplicitamente se il tuo modello è un oracolo o un'interfaccia di ricerca. Gli strumenti che reggono allo scrutinio sono quelli abbastanza onesti da essere il secondo.
Il punto di arrivo
L'AI offline-first non riguarda la sopravvivenza all'apocalisse. Riguarda scoprire com'è fatta la tua architettura quando ogni via di fuga (un modello più grande, un fallback in cloud, una rete sempre accesa, energia illimitata) è saldata. Ciò che resta è un corpus curato, un modello quantizzato dimensionato su hardware che non controlli, un retrieval che porta la fiducia e un loop di agente progettato per fallire con grazia. Si rivelano buone discipline anche online. La tempesta ti costringe solo a impararle più in fretta.


