IA hors ligne : un LLM qui marche sans connexion
Comment l'IA hors ligne embarque modèles quantifiés, corpus sélectionnés et recherche documentaire pour fonctionner sans réseau, et à quel prix.
 Elena Vasquez
Le courant est coupé depuis neuf heures, le réseau cellulaire est saturé, et le congélateur de votre garage est plein de viande achetée samedi. Est-ce encore sans danger à manger ? Normalement, vous demanderiez à un chatbot. Là, c'est Internet qui a lâché en premier. Ce scénario est le cahier des charges d'une catégorie grandissante d'outils d'IA hors ligne : un assistant et une bibliothèque de référence qui vivent entièrement sur votre ordinateur portable. Le modèle, le corpus, l'index de recherche, tout tourne localement, donc poser la question « comment purifier cette eau » fonctionne exactement de la même façon avec le câble Ethernet débranché. Je trouve ça plus intéressant comme exercice d'architecture que comme équipement de survivaliste. Retirer le réseau force à prendre un ensemble de décisions d'ingénierie que l'IA dans le cloud peut ignorer, et ces décisions s'avèrent utiles bien au-delà des kits d'urgence. Si vous avez réfléchi à faire tourner de grands modèles de langage sur votre propre matériel, les contraintes d'un assistant hors ligne en sont la partie la plus tranchante.
Ce que l'IA hors ligne doit vraiment embarquer
Un assistant dans le cloud est léger : votre client envoie du texte, un data center renvoie des tokens. Un assistant hors ligne doit reproduire toute cette pile sur du matériel grand public, ce qui implique de livrer trois gros composants et de les faire tenir ensemble. D'abord, le moteur d'inférence. En pratique, c'est llama.cpp ou l'un de ses dérivés, parce qu'il tourne sur Apple Silicon, sur des CPU x86 classiques et sur des GPU grand public, avec une seule arborescence de dépendances. L'app Mac l'embarque ; la version Windows le télécharge pendant l'installation. Dans tous les cas, on ne peut pas supposer qu'il est présent sur la machine : on l'installe soi-même, discrètement, au premier lancement. Ensuite, le modèle. C'est là que ça devient intéressant, j'y reviendrai, car choisir le bon modèle est le problème de conception central. Enfin, la bibliothèque. Un assistant hors ligne de cette catégorie embarque environ 930 000 articles Wikipédia (le sous-ensemble le plus consulté), des références médicales comme MedlinePlus et WikiMed, des consignes d'urgence de la FEMA et du CDC, des manuels de survie militaires, wikiHow, des guides de réparation iFixit et des exports de Q&R Stack Exchange sur des sujets comme le bricolage domestique ou la radio amateur. Tout est en texte brut, avec les licences conservées et affichées pour chaque article. Le téléchargement complet pèse environ 9 Go et grimpe à 19 Go une fois installé ; une version allégée sans Wikipédia ni iFixit fait 1,3 Go. C'est un acte de conservation autant que d'ingénierie : quelqu'un a décidé quelles sources survivraient au tri. Le tout doit tenir dans une installation en trois étapes qui prend cinq minutes de clics et jusqu'à deux heures et demie de téléchargement. Ce dernier chiffre compte plus qu'il n'y paraît : la fenêtre de téléchargement est votre seule chance de récupérer quoi que ce soit, jamais plus. C'est la même rigueur qu'on applique aux logiciels qu'on ne peut ni redémarrer ni joindre, sauf que l'environnement inaccessible est une cuisine plongée dans le noir après l'orage.
Le problème du choix de modèle : une app, plusieurs cerveaux
Voici la décision que les logiciels dans le cloud n'ont jamais à prendre : vous ne savez pas quel matériel possède votre utilisateur, vous ne pouvez pas sonder sa RAM pour l'orienter vers un cluster plus gros, et la réponse change à la fois la taille du téléchargement et la qualité de chaque réponse, pour toujours. La solution, dans cette catégorie d'outils, est un système de paliers basé sur la détection du matériel. Au premier lancement, l'app vérifie la mémoire système et choisit un modèle compatible : - 128 Go ou plus : un grand modèle de type flagship (une version utilise NVIDIA Nemotron 3.5 Super, environ 80 Go sur le disque), qui obtient 21 sur 22 au test à correction aveugle du projet sur les questions de coupure et de premiers secours. - 32 à 96 Go : un modèle de taille moyenne d'environ 27 milliards de paramètres (~18 Go), également à 21 sur 22. - 32 Go sous Windows : un modèle d'environ 25 Go optimisé pour la vitesse, 19 sur 22. - 16 à 31 Go : un modèle de classe 8B (~6 Go), 14 sur 22. Relisez la dernière ligne. La machine que possède réellement la plupart des gens, un portable à 16 Go, obtient un cerveau qui rate l'essentiel des consignes officielles environ un tiers du temps, sur des questions dont l'essentiel tient à des choses comme « ne mangez pas le poulet resté six heures à température ambiante ». C'est l'arithmétique inconfortable de l'IA hors ligne. La quantification et les petits modèles se sont nettement améliorés : un modèle 8B bien réglé fait un bon assistant d'écriture et une interface de recherche correcte. Mais la courbe de qualité ne se plie pas à vos contraintes de déploiement. Quand une app cloud veut un modèle plus intelligent, elle bascule un paramètre. Quand une app hors ligne en veut un, il faut que l'utilisateur ait acheté un portable plus costaud il y a trois ans. Vous livrez la courbe, et la courbe vous livre. La mitigation honnête, celle qu'adoptent ces outils, consiste à traiter le petit modèle comme une interface vers le corpus, et non comme une autorité sur celui-ci. Chaque réponse liste exactement les articles lus, avec le passage surligné, parce que les concepteurs savent que le palier 8B se trompera parfois.
La recherche comme couche de confiance, pas comme fonctionnalité
Tous les systèmes de génération augmentée par récupération affichent désormais leurs sources ; dans le cloud, c'est une case à cocher, un peu de transparence de façade. Hors ligne, la recherche porte la charge. C'est la seule chose qui sépare une hallucination plausible d'un utilisateur qui agit dessus en pleine urgence. La conception qui en résulte ressemble à ceci : le modèle parcourt la bibliothèque en texte brut, lit les passages les plus pertinents et rédige une réponse qui cite ce qu'il a lu. Si l'utilisateur lui demande de chercher quelque chose, il effectue une recherche même s'il avait déjà répondu de mémoire, et l'interface indique d'où vient chaque réponse : mémoire, articles ouverts, ou résultats de recherche jamais ouverts. Cette dernière distinction est subtile et importante. « J'ai trouvé des extraits correspondants » et « j'ai lu l'article » sont deux affirmations différentes, avec des fiabilités différentes, et l'interface les traite comme telles. Il y a aussi un détail sur les modes de défaillance que j'adore : quand le modèle est parti chercher sans jamais écrire de réponse finale, chose réelle que font les petits modèles, l'app lui réinjecte de force les meilleurs articles trouvés et lui fait réessayer une fois, au lieu de ne rien montrer à l'utilisateur. Hors ligne, on ne peut pas se replier sur un modèle plus gros ni sur une file de relance. On intègre la relance dans la boucle de l'agent. C'est un exemple compact de ce qu'on veut dire quand on affirme que les agents LLM se comportent comme des systèmes distribués : des défaillances partielles partout, et la couche d'orchestration doit rendre la panne survivable. Un autre choix d'architecture qui mérite d'être copié : le budget de raisonnement. L'app expose le nombre de tokens que le modèle peut réfléchir avant de répondre (désactivé, 1 000, 4 000, 16 000 ou illimité), et à la limite, la réflexion est coupée et le modèle répond avec ce qu'il a. Sur batterie, un modèle qui tourne en rond n'est pas seulement faux, c'est une source de consommation. Un plafond strict transforme un problème de calcul sans borne en problème borné, exactement le bon réflexe quand la prise murale n'est qu'une théorie.
Les sceptiques ont raison (sur la mauvaise moitié)
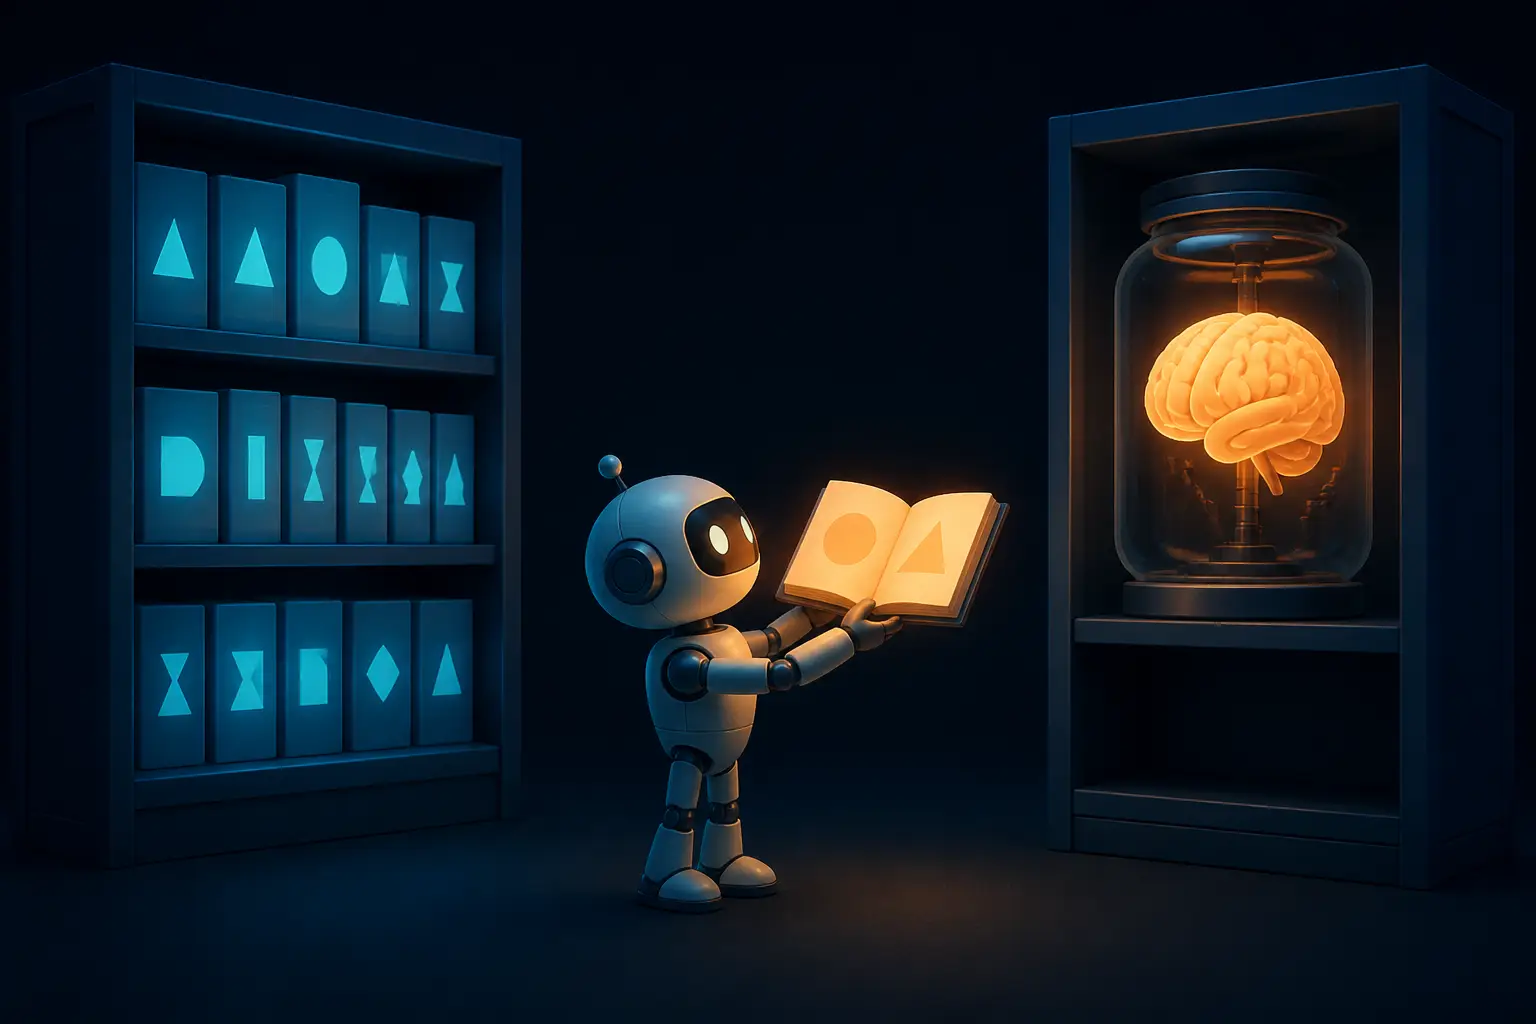
La critique la plus vive de ce genre entier : pourquoi ne pas se passer du LLM et livrer simplement une archive consultable ? Kiwix le fait depuis des années : Wikipédia et les références médicales, compressées, indexées, consultables hors ligne, sans risque d'hallucination, et qui tourne sur une patate. Et pour un jeu de données de texte organisé, un moteur de recherche est sans doute l'outil le plus fiable. Un testeur a demandé à l'assistant hors ligne comment fabriquer un foret à archet : il a obtenu les bonnes pièces mais le mauvais geste. Le modèle décrivait de faire rouler l'axe entre les paumes, en ignorant complètement l'archet, et mentionnait de « souffler sur les étincelles », ce que la friction ne produit pas. Un moteur de recherche ne peut pas commettre cette erreur, parce qu'il ne génère rien. Mais je pense que cette critique manque ce à quoi sert vraiment le LLM dans ces systèmes, et la meilleure défense de la conception consiste à le repositionner : utiliser le modèle comme une intelligence de recherche, pas comme un oracle. La recherche par mots-clés échoue quand on ne connaît pas le vocabulaire, quand on a des symptômes et non un diagnostic, un objet cassé et non un nom de pièce. La recherche sémantique aide pour le « proche en sens », mais pas pour le « relié par un mécanisme ou une cause », précisément le fossé que comble un modèle génératif : il peut prendre « les feuilles des cultures jaunissent sur les bords » et produire les cinq pistes de lecture qu'un mot-clé n'aurait jamais trouvées. Le travail du modèle est de vous mener aux bonnes pages. Le travail des pages est d'être justes. L'autre critique, « si vous avez besoin d'un LLM pendant l'apocalypse, apprenez simplement les compétences », est juste comme conseil de vie et inutile comme critique logicielle. Personne ne connaît par cœur les premiers secours pédiatriques, la chimie de la purification de l'eau et la réparation d'un groupe électrogène. Les livres couvrent tout cela ; la question ne porte que sur l'interface. Là où les sceptiques marquent un coup net, c'est avec le palier 14 sur 22. Si la couche d'interface se trompe un tiers du temps et que chaque réponse porte un avertissement « vérifiez les sources », il arrive un moment où le produit honnête est l'archive avec une barre de recherche. Le LLM ne mérite sa place que s'il fait démontrablement trouver le bon passage plus vite que Ctrl+F à des non-experts. C'est une question empirique sur vos utilisateurs, pas une impression.
Une pile minimale d'IA hors ligne
Si vous voulez construire votre propre version de ceci (et vous devriez, c'est un projet de week-end vraiment instructif), le squelette est plus petit qu'on ne le croit. Les parties intéressantes sont les choix, pas le code. Un assistant local centré sur la recherche, en Python, ressemble à peu près à ceci :
import subprocess
from pathlib import Path
CORPUS_DIR = Path("./library")          # plain-text articles, one file each
MODEL = "./models/granite-8b-q4.gguf"   # quantized to fit 16 GB RAM
def search_corpus(query: str, k: int = 5) -> list[dict]:
"""Dumb but honest: rank articles by keyword overlap.
Swap in BM25 or embeddings later; the interface is the point."""
terms = set(query.lower().split())
hits = []
for f in CORPUS_DIR.rglob("*.txt"):
text = f.read_text(errors="ignore")
score = sum(text.lower().count(t) for t in terms)
if score:
hits.append({"path": f.name, "score": score, "text": text[:3000]})
return sorted(hits, key=lambda h: -h["score"])[:k]
def answer(question: str) -> str:
sources = search_corpus(question)
context = "\n\n".join(
f"[SOURCE {i}: {s['path']}]\n{s['text']}"
for i, s in enumerate(sources, 1)
)
prompt = (
"Answer ONLY from the sources below. Cite them as [SOURCE n]. "
"If they don't cover it, say so.\n\n"
f"{context}\n\nQuestion: {question}\nAnswer:"
)
out = subprocess.run(
["llama-cli", "-m", MODEL, "-p", prompt,
"-n", "512", "--ctx-size", "8192"],
capture_output=True, text=True,
)
citations = "\n".join(f"[{i}] {s['path']}" for i, s in enumerate(sources, 1))
return out.stdout + "\n\n--- Sources ---\n" + citations
print(answer("how long is food safe in a fridge without power"))
Tout ce qui fait qu'on ressent cela comme un produit plutôt qu'un jouet tient aux contraintes intégrées dans ces quarante lignes : le prompt interdit de répondre en dehors des sources, les citations sont ajoutées mécaniquement (on ne fait jamais confiance au modèle pour les formater, un bug réel ayant consisté en des modèles inventant une ligne « Sources : » listant leurs propres commandes de recherche), et la longueur de génération est plafonnée. Manquent ici, mais nécessaires en production : un index d'embeddings pour la recherche sémantique, un budget de tokens de raisonnement, la détection de la mémoire pour choisir le fichier modèle, et des métadonnées de licence par fichier pour que l'interface puisse les afficher. Remarquez ce qui n'est pas là : aucun appel réseau, aucune clé d'API, aucune télémétrie. Une fois le fichier modèle et le corpus présents sur le disque, ce programme est physiquement incapable de divulguer une question. La confidentialité cesse d'être une politique pour devenir une conséquence du graphe de dépendances.
Les contraintes qui vous suivent à la maison
Concevoir hors ligne d'emblée fait de quelques contraintes non évidentes des résidentes permanentes de votre architecture. **Le stockage et les fenêtres d'installation sont à usage unique.** La bibliothèque complète nécessite environ 27 Go d'espace libre pendant l'installation avant de redescendre à 19 Go, et tout doit arriver pendant le téléchargement initial. Impossible de charger à la volée une référence médicale manquante pendant un ouragan. Cela pousse vers une sélection agressive : 930 000 articles semblent beaucoup, jusqu'à ce qu'on se rappelle que Wikipédia en compte des millions ; quelqu'un a classé par fréquentation et coupé la queue de distribution. **L'énergie est une ressource de premier ordre.** Mesuré sur un MacBook Pro, répondre consomme environ 100 W pendant 5 à 40 secondes par question ; une batterie pleine permet entre 100 et 300 réponses environ. Soudain, une longue chaîne de raisonnement n'est pas seulement lente, c'est une décision de carburant. Les budgets de raisonnement et les paliers de petits modèles cessent d'être des optimisations pour devenir le produit. **Votre canal de mise à jour est votre bouée de sauvetage.** L'app doit mettre à jour modèles, bibliothèque et binaire en un clic sans casser l'état local, car la prochaine fois que l'utilisateur disposera de bande passante pourrait être dans des mois. Et la discipline des ressources en arrière-plan prend une nouvelle dimension : un correctif dans une version a fait en sorte que Cmd+Q arrête réellement le moteur d'inférence, qui gardait en mémoire un modèle de plusieurs gigaoctets après la fermeture de la fenêtre. Sur batterie, ce n'est pas une fuite mémoire, c'est une fuite de chaleur et d'heures. **Les fichiers utilisateur rejoignent la frontière de confiance.** Permettre aux utilisateurs de déposer leurs propres PDF (un manuel de groupe électrogène, un plan familial d'urgence) signifie que votre pipeline de recherche doit gérer des entrées très désordonnées : PDF scannés, encodages bizarres, fichiers énormes. Hors ligne, impossible de déléguer tout cela à un analyseur dans le cloud.
Pourquoi ce schéma compte au-delà des urgences
La confidentialité cesse d'être une promesse de politique pour devenir une conséquence du graphe de dépendances. Un programme sans appel réseau ne peut rien divulguer, jamais.
Le cadrage urgence attire les gros titres, mais c'est l'architecture qui fait l'histoire. La même pile (inférence locale, corpus organisé, recherche avec citations, budgets de calcul stricts) est exactement ce qu'il faut à une clinique dont les données patients ne peuvent légalement pas quitter le bâtiment, à un atelier avec des machines isolées du réseau, à un journaliste dans un pays où un journal de requêtes est un risque, ou à un navire de recherche dont la connexion satellite est facturée au mégaoctet. Un praticien dans la discussion a décrit exactement cela : une bibliothèque organisée à la main et des modèles locaux sur une propriété sans réseau cellulaire, rafraîchis avant chaque déplacement, remplaçant peu à peu l'essentiel de leur usage quotidien de l'IA dans le cloud, même quand la fibre est disponible. C'est la trajectoire sur laquelle je parierais. L'écart entre un modèle local 8B quantifié et un modèle d'API de pointe est réel mais assez étroit pour que, sur les tâches ancrées dans la recherche (« trouve-moi le bon passage et résume-le fidèlement »), l'option locale suffise souvent, et la suffisance combinée à un coût marginal nul et une confidentialité garantie forme un ensemble convaincant. Les modèles de pointe continuent de progresser, mais la quantification aussi, et les petits modèles suivent la même vague d'échelle avec un décalage. Si vous suivez le versant efficacité de cette courbe, les modèles de type flash sont là où se joue la vraie histoire de l'efficacité d'inférence. Mon conseil si vous concevez quoi que ce soit dans cet espace : copiez le schéma, pas l'esthétique survivaliste. Sélectionnez sans pitié. Une bibliothèque de 200 documents en lesquels vous avez confiance vaut mieux que 930 000 que vous n'avez pas lus. Rendez les citations mécaniques, jamais générées par le modèle. Donnez au modèle un budget strict pour réfléchir. Et décidez explicitement si votre modèle est un oracle ou une interface de recherche. Les outils qui résistent à l'examen sont ceux qui ont l'honnêteté d'être le second.
En résumé
L'IA hors ligne ne consiste pas à survivre à l'apocalypse. Il s'agit de découvrir à quoi ressemble votre architecture quand toutes les issues de secours (un modèle plus gros, un repli dans le cloud, un réseau toujours disponible, une énergie illimitée) sont condamnées. Ce qui reste : un corpus organisé, un modèle quantifié dimensionné pour un matériel que vous ne contrôlez pas, une recherche qui porte la confiance, et une boucle d'agent conçue pour échouer en douceur. Ces disciplines s'avèrent aussi utiles en ligne. L'orage vous force simplement à les apprendre plus vite.


