AI Offline-First: Membangun LLM yang Jalan Tanpa Internet
Cara kerja AI offline-first: mengemas model terkuantisasi, korpus terkurasi, dan retrieval agar asisten tetap bekerja tanpa jaringan, beserta biayanya.
 Elena Vasquez
Listrik sudah mati sembilan jam, jaringan seluler padat, dan freezer di garasi penuh daging yang kamu beli hari Sabtu. Masih aman dimakan? Biasanya kamu tinggal tanya chatbot. Sekarang, internet justru yang lebih dulu tumbang. Skenario itu adalah brief desain untuk kelas alat AI offline-first yang makin banyak: asisten dan perpustakaan referensi yang sepenuhnya hidup di laptop kamu. Modelnya, korpusnya, index pencariannya, semuanya jalan lokal, jadi bertanya "cara memurnikan air ini gimana" tetap bekerja walaupun kabel ethernet dicabut. Menurut saya ini lebih menarik sebagai latihan arsitektur ketimbang sebagai perlengkapan prepper. Menghilangkan jaringan memaksa serangkaian keputusan rekayasa yang bisa diabaikan oleh AI berbasis cloud, dan keputusan-keputusan itu ternyata berguna jauh melampaui kit darurat. Kalau kamu pernah memikirkan menjalankan large language model di perangkat keras sendiri, batasan asisten offline adalah ujung tajam dari masalah itu.
Apa yang Sebenarnya Harus Dikirim oleh AI Offline-First
Asisten cloud itu tipis: klien kamu mengirim teks, data center mengembalikan token. Asisten offline harus mereplikasi seluruh tumpukan itu di hardware konsumen, yang berarti mengirim tiga komponen besar dan menjaganya tetap harmonis. Pertama, inference engine. Dalam praktiknya ini berarti llama.cpp atau turunannya, karena jalan di Apple Silicon, CPU x86 biasa, dan GPU konsumen dengan satu dependency tree. Aplikasi Mac sudah membundelnya; build Windows mengunduhnya saat setup. Apa pun caranya, kamu tidak bisa berasumsi itu sudah ada di mesin pengguna. Kamu yang memasangnya, diam-diam, saat pertama kali dijalankan. Kedua, modelnya. Di sinilah menariknya, dan saya akan kembali ke sini, karena memilih model yang tepat adalah masalah desain utama. Ketiga, perpustakaannya. Salah satu asisten offline di bidang ini membawa sekitar 930.000 artikel Wikipedia (subset yang paling banyak dibaca), referensi medis seperti MedlinePlus dan WikiMed, panduan darurat FEMA dan CDC, buku panduan bertahan hidup militer, wikiHow, panduan perbaikan iFixit, dan dump Q&A Stack Exchange tentang topik seperti perbaikan rumah dan ham radio. Semuanya teks polos, dengan lisensi yang dipertahankan dan ditampilkan per artikel. Unduhan penuhnya sekitar 9 GB dan membengkak jadi 19 GB setelah terpasang; versi ramping tanpa Wikipedia dan iFixit berukuran 1,3 GB. Itu sama banyaknya tindakan kurasi seperti rekayasa, karena ada orang yang memutuskan sumber mana yang lolos seleksi. Semuanya harus muat dalam setup tiga langkah yang butuh lima menit klik dan sampai dua setengah jam unduhan. Angka terakhir itu lebih penting dari kelihatannya: jendela unduh adalah satu-satunya kesempatan kamu mengambil apa pun, selamanya. Disiplinnya sama seperti yang kamu terapkan pada software yang tidak bisa di-reboot atau dijangkau, bedanya lingkungan yang tak terjangkau ini adalah dapur yang gelap karena badai.
Masalah Tiering Model: Satu Aplikasi, Banyak Otak
Inilah keputusan yang tidak pernah dihadapi software cloud: kamu tidak tahu hardware pengguna, kamu tidak bisa memeriksa RAM mereka lalu mengarahkan ke cluster yang lebih besar, dan jawabannya mengubah ukuran unduhan sekaligus kualitas setiap jawaban selamanya. Solusi di kelas tools ini adalah tiering berbasis probe hardware. Saat pertama kali diluncurkan, aplikasi memeriksa memori sistem dan memilih model yang muat: - 128 GB atau lebih: model kelas flagship besar (salah satu build memakai NVIDIA Nemotron 3.5 Super, ~80 GB di disk), skor 21 dari 22 pada tes buta yang dinilai proyek soal blackout dan pertolongan pertama. - 32–96 GB: model menengah sekitar 27B parameter (~18 GB), juga 21 dari 22. - 32 GB di Windows: model ~25 GB yang di-tuning untuk kecepatan, 19 dari 22. - 16–31 GB: model kelas 8B (~6 GB), 14 dari 22. Baca lagi baris terakhir itu. Mesin yang paling banyak dimiliki orang, yaitu laptop 16 GB, mendapat otak yang meleset dari poin utama panduan resmi sekitar sepertiga waktu, pada pertanyaan yang poin utamanya seperti "jangan makan ayam yang sudah enam jam di suhu ruang". Ini aritmetika yang tidak nyaman dari AI offline-first. Kuantisasi dan model kecil memang sudah sangat bagus. Model 8B yang di-tuning dengan baik adalah asisten menulis yang oke dan antarmuka pencarian yang layak. Tapi kurva kualitasnya tidak mau menekuk demi menyesuaikan batasan deployment kamu. Saat aplikasi cloud butuh model yang lebih pintar, cukup balik sebuah flag konfigurasi. Saat aplikasi offline membutuhkannya, pengguna harus sudah membeli laptop yang lebih besar tiga tahun lalu. Kamu mengirim kurvanya, dan kurvanya yang mengirim kamu. Mitigasi yang jujur adalah yang diadopsi tools ini: perlakukan model kecil sebagai antarmuka ke korpus, bukan otoritas atasnya. Setiap jawaban mencantumkan persis artikel mana yang dibaca, dengan bagian yang disorot, karena desainernya tahu tier 8B kadang salah.
Retrieval sebagai Lapisan Kepercayaan, Bukan Fitur
Setiap sistem retrieval-augmented generation sekarang menampilkan sumber. Di cloud itu cuma kotak centang, sedikit teater transparansi. Secara offline, retrieval itu menanggung beban. Ia satu-satunya yang berdiri di antara halusinasi yang terdengar meyakinkan dan pengguna yang bertindak berdasarkan itu dalam keadaan darurat sungguhan. Desain yang muncul seperti ini: model mencari di perpustakaan teks polos, membaca passage teratas, dan menulis jawaban yang mengutip apa yang dibacanya. Kalau pengguna minta dicarikan sesuatu, model tetap mencari walaupun sudah menjawab dari memorinya. UI memberi tahu setiap jawaban berasal dari mode mana: memori, artikel yang dibuka, atau hasil pencarian yang tidak pernah dibuka. Pembedaan terakhir ini halus tapi penting. "Saya menemukan cuplikan yang cocok" dan "saya sudah membaca artikelnya" adalah klaim berbeda dengan keandalan berbeda, dan antarmukanya memperlakukannya demikian. Ada juga detail failure mode yang saya suka: ketika model sudah mencari tapi tidak pernah menulis jawaban akhir, hal nyata yang sering dilakukan model kecil, aplikasi sekarang memaksa memasukkan artikel terbaik yang ditemukan dan memintanya mencoba sekali lagi, alih-alih tidak menampilkan apa-apa ke pengguna. Secara offline, kamu tidak bisa jatuh ke model yang lebih besar atau antrean retry. Kamu membangun retry ke dalam agent loop. Ini contoh ringkas dari maksud orang saat bilang agen LLM berperilaku seperti distributed system: kegagalan parsial di mana-mana, dan tugas lapisan orkestrasi adalah membuat kegagalan itu bisa dilewati. Satu pilihan arsitektur lagi yang layak dicuri: reasoning budget. Aplikasi memperlihatkan berapa banyak token yang boleh dipikirkan model sebelum menjawab: mati, 1.000, 4.000, 16.000, atau tanpa batas. Saat batas tercapai, pemikiran dipotong dan model menjawab dari apa yang sudah dimilikinya. Saat pakai baterai, model yang berputar-putar bukan cuma salah, tapi juga menguras daya. Batas keras mengubah masalah komputasi tak terbatas menjadi terbatas, dan itulah insting yang kamu butuhkan saat colokan listrik hanya teori.
Para Skeptis Ada Benarnya (Soal Separuh yang Salah)
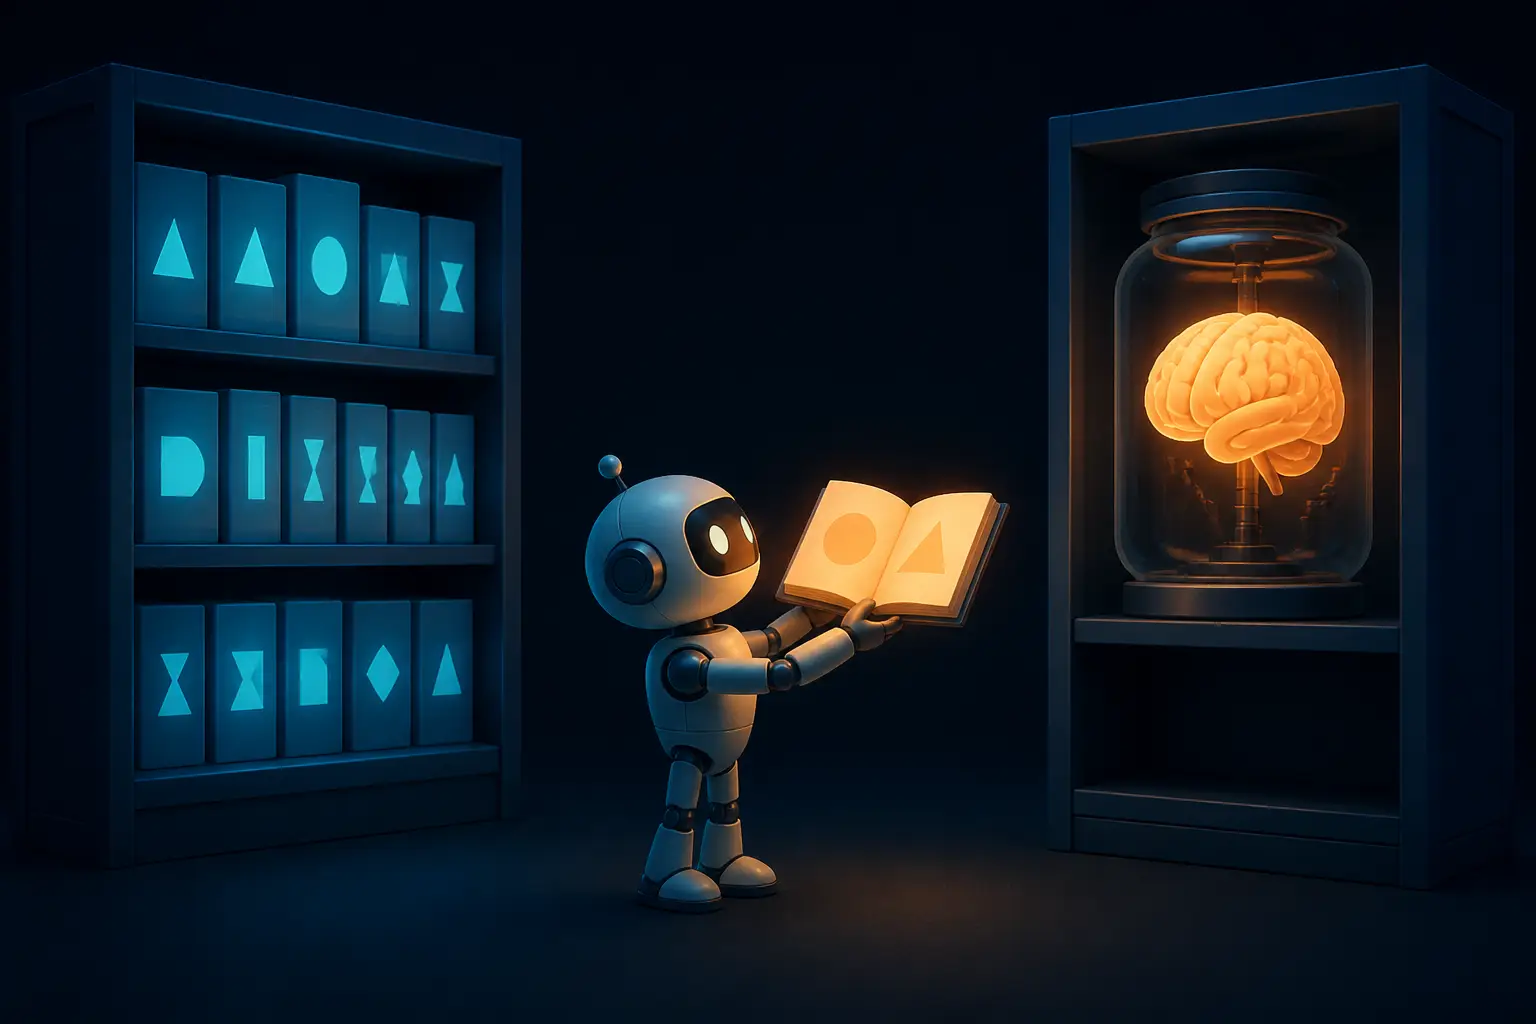
Kritik paling tajam untuk genre ini: kenapa tidak lewati LLM dan kirim saja arsip yang bisa dicari? Kiwix sudah melakukan itu bertahun-tahun: Wikipedia dan referensi medis, dikompres, diindeks, bisa dicari offline, tanpa risiko halusinasi, jalan di perangkat sekelas kentang. Dan untuk dataset teks terkurasi, mesin pencari bisa dibilang alat yang lebih andal. Seorang tester bertanya ke asisten offline cara membuat bow drill dan mendapat bagian-bagiannya dengan benar tapi gerakannya salah. Model menjelaskan memutar spindle di antara telapak tangan, mengabaikan busurnya sama sekali, dan menyebut "mengipasi percikan", yang tidak dihasilkan oleh friction fire. Mesin pencari tidak mungkin membuat kesalahan itu karena ia tidak menghasilkan apa pun. Tapi menurut saya kritik ini meleset dari tujuan sebenarnya LLM dalam sistem seperti ini, dan pembelaan terkuat untuk desainnya adalah memosisikan ulang modelnya: pakai model sebagai kecerdasan pencarian, bukan oracle. Pencarian kata kunci gagal saat kamu tidak tahu kosakatanya, saat yang kamu punya adalah gejala, bukan diagnosis, benda yang rusak, bukan nama suku cadang. Retrieval semantik membantu untuk "dekat secara makna", tapi tidak untuk "terhubung lewat mekanisme atau sebab-akibat". Itulah celah yang dijembatani model generatif: ia bisa mengambil "tanaman menguning di tepi daun" dan menghasilkan lima jalur bacaan yang tidak akan pernah ditemukan kata kunci. Tugas model adalah membawamu ke halaman yang tepat. Tugas halaman itu adalah benar. Kritik lain, "kalau butuh LLM saat kiamat, pelajari saja skill-nya", adil sebagai nasihat hidup dan tidak berguna sebagai kritik software. Pengetahuan pertolongan pertama siapa pun tidak mencakup luka bakar anak, kimia pemurnian air, dan perbaikan generator. Buku mencakup semuanya; argumennya hanya soal antarmuka. Di mana para skeptis benar-benar mengena adalah tier 14 dari 22. Kalau lapisan antarmuka salah sepertiga waktu dan setiap jawaban membawa disclaimer "cek sumbernya", pada titik tertentu produk yang jujur adalah arsip dengan kotak pencarian. LLM hanya layak dipertahankan sejauh ia terbukti membuat orang awam sampai ke passage yang tepat lebih cepat daripada Ctrl+F. Itu pertanyaan empiris tentang penggunamu, bukan soal perasaan.
Stack AI Offline-First yang Minimal
Kalau kamu ingin membangun versimu sendiri, dan sebaiknya begitu karena ini proyek akhir pekan yang sangat mendidik, kerangkanya lebih kecil dari yang kamu kira. Bagian yang menarik adalah pilihannya, bukan kodenya. Asisten lokal yang mengutamakan retrieval dengan Python kira-kira seperti ini:
import subprocess
from pathlib import Path
CORPUS_DIR = Path("./library")          # plain-text articles, one file each
MODEL = "./models/granite-8b-q4.gguf"   # quantized to fit 16 GB RAM
def search_corpus(query: str, k: int = 5) -> list[dict]:
"""Dumb but honest: rank articles by keyword overlap.
Swap in BM25 or embeddings later; the interface is the point."""
terms = set(query.lower().split())
hits = []
for f in CORPUS_DIR.rglob("*.txt"):
text = f.read_text(errors="ignore")
score = sum(text.lower().count(t) for t in terms)
if score:
hits.append({"path": f.name, "score": score, "text": text[:3000]})
return sorted(hits, key=lambda h: -h["score"])[:k]
def answer(question: str) -> str:
sources = search_corpus(question)
context = "\n\n".join(
f"[SOURCE {i}: {s['path']}]\n{s['text']}"
for i, s in enumerate(sources, 1)
)
prompt = (
"Answer ONLY from the sources below. Cite them as [SOURCE n]. "
"If they don't cover it, say so.\n\n"
f"{context}\n\nQuestion: {question}\nAnswer:"
)
out = subprocess.run(
["llama-cli", "-m", MODEL, "-p", prompt,
"-n", "512", "--ctx-size", "8192"],
capture_output=True, text=True,
)
citations = "\n".join(f"[{i}] {s['path']}" for i, s in enumerate(sources, 1))
return out.stdout + "\n\n--- Sources ---\n" + citations
print(answer("how long is food safe in a fridge without power"))
Semua yang membuat ini terasa seperti produk, bukan mainan, ada di batasan yang tertanam di empat puluh baris itu: prompt melarang menjawab di luar sumber, sitasi ditambahkan secara mekanis (tidak pernah mempercayai model untuk memformatnya; satu bug nyata melibatkan model yang mengarang baris "Sources:" berisi daftar perintah pencarian mereka sendiri), dan panjang generasi dibatasi. Yang tidak ada tapi wajib untuk produksi: index embedding untuk pencarian semantik, reasoning-token budget, probe memori untuk memilih file model, dan metadata lisensi per file agar UI bisa menampilkannya. Perhatikan apa yang tidak ada: tidak ada panggilan jaringan, tidak ada API key, tidak ada telemetri. Begitu file model dan korpus ada di disk, program ini secara fisik tidak bisa membocorkan pertanyaan apa pun. Privasi berhenti menjadi kebijakan dan menjadi konsekuensi dari dependency graph.
Batasan yang Ikut Pulang Bersamamu
Kalau membangun offline-first, beberapa batasan tak terduga akan menjadi penghuni tetap di arsitekturmu. **Penyimpanan dan jendela instalasi hanya sekali jalan.** Perpustakaan lengkap butuh sekitar 27 GB ruang kosong saat instalasi sebelum turun ke 19 GB, dan semuanya harus datang saat unduhan awal. Tidak ada lazy-loading referensi medis yang hilang saat badai. Ini mendorongmu ke kurasi yang agresif. 930.000 artikel terdengar banyak sampai kamu ingat Wikipedia punya jutaan; seseorang sudah meranking berdasarkan jumlah pembaca dan memotong ekornya. **Daya adalah sumber daya kelas satu.** Diukur di MacBook Pro, menjawab menarik sekitar 100 W selama 5 sampai 40 detik per pertanyaan, jadi baterai penuh hanya cukup untuk sekitar 100 sampai 300 jawaban. Tiba-tiba chain-of-thought panjang bukan cuma lambat, tapi keputusan bahan bakar. Reasoning budget dan tier model kecil berhenti menjadi optimasi dan menjadi produk itu sendiri. **Kanal update adalah jalur hidupmu.** Aplikasi harus memperbarui model, perpustakaan, dan binary dalam satu klik tanpa merusak state lokal, karena kapan pengguna punya bandwidth lagi mungkin masih berbulan-bulan lagi. Disiplin resource di latar belakang juga jadi penting dengan cara baru: perbaikan di satu rilis membuat Cmd+Q benar-benar menghentikan inference engine, yang sebelumnya menjaga model multi-gigabyte tetap di memori setelah jendela ditutup. Saat pakai baterai, itu bukan memory leak, melainkan kebocoran panas dan jam. **File pengguna masuk ke batas kepercayaan.** Membiarkan pengguna memasukkan PDF mereka sendiri, seperti manual generator atau rencana darurat keluarga, berarti pipeline retrieval-mu harus menangani input yang berantakan secara adversarial: PDF hasil scan, encoding aneh, file besar. Secara offline, kamu tidak bisa melemparkan satu pun dari itu ke parser cloud.
Mengapa Pola Ini Penting di Luar Keadaan Darurat
Privasi berhenti menjadi janji kebijakan dan menjadi konsekuensi dari dependency graph. Program tanpa panggilan jaringan tidak bisa membocorkan apa pun, selamanya.
Bingkai darurat yang dapat sorotan, tapi ceritanya sebenarnya ada di arsitekturnya. Tumpukan yang sama, yaitu inferensi lokal, korpus terkurasi, retrieval dengan sitasi, dan batas komputasi yang ketat, adalah yang kamu butuhkan untuk klinik dengan data pasien yang secara hukum tidak boleh keluar gedung, lantai pabrik dengan mesin air-gapped, jurnalis di negara tempat log kueri adalah liabilitas, atau kapal riset dengan internet satelit yang ditagih per megabyte. Salah satu praktisi dalam diskusi menggambarkan persis ini: perpustakaan yang dikurasi manual plus model lokal di properti tanpa sinyal seluler, diperbarui sebelum setiap perjalanan, perlahan menggantikan sebagian besar penggunaan AI cloud harian mereka, bahkan ketika serat optik tersedia. Itu lintasan yang akan saya pertaruhkan. Jarak antara LLM 8B terkuantisasi lokal dan model API frontier itu nyata tapi cukup sempit, sehingga untuk tugas yang berpijak pada retrieval, seperti "temukan passage yang tepat dan ringkas dengan setia", opsi lokal sering sudah cukup. Ditambah biaya marginal nol dan privasi terjamin, itu paket yang menarik. Model frontier terus membaik, tapi kuantisasi juga, dan model kecil menumpang gelombang skala yang sama dengan jeda. Kalau kamu mengikuti ujung efisiensi dari kurva itu, model kelas flash adalah tempat cerita efisiensi inferensi yang sesungguhnya. Nasihat saya kalau kamu mendesain sesuatu di bidang ini: curi polanya, bukan estetika prepper-nya. Kurasi dengan kejam. Perpustakaan 200 dokumen yang kamu percaya lebih baik dari 930.000 yang belum pernah kamu baca. Buat sitasi secara mekanis, jangan dihasilkan model. Beri model budget keras untuk berpikir. Dan putuskan secara eksplisit apakah modelmu oracle atau antarmuka pencarian. Tools yang bertahan dari pengawasan adalah yang cukup jujur untuk menjadi yang kedua.
Kesimpulan
AI offline-first bukan soal bertahan dari kiamat. Ini soal menemukan seperti apa arsitekturmu saat setiap jalan keluar, seperti model yang lebih besar, fallback cloud, jaringan yang selalu menyala, dan daya tak terbatas, dilas tertutup. Yang tersisa adalah korpus terkurasi, model terkuantisasi yang disesuaikan dengan hardware yang tidak kamu kendalikan, retrieval yang memikul kepercayaan, dan agent loop yang dibangun untuk gagal dengan anggun. Ternyata disiplin itu juga berguna saat online. Badai hanya membuatmu mempelajarinya lebih cepat.


