LLM: generar conjeturas frente a verificar pruebas
Los LLM ya generan conjeturas, no solo verifican pruebas. Cuándo gana cada uno en matemática y el bucle que vuelve seguras las pruebas de máquina.
 Elena Vasquez
Entre el segundo y el tercer café, muchos teóricos de la complejidad leyeron hace poco una frase que nunca esperaban leer: un algoritmo determinista que cuenta las asignaciones satisfactibles de una fórmula booleana arbitraria en un tiempo aproximado de 2^(n/√(log n)). Es subexponencial, en el sentido técnico preciso que refuta la Hipótesis del Tiempo Exponencial (ETH), una de las suposiciones que sostienen el campo. La afirmación no salió en arXiv de un grupo universitario. Vino de un laboratorio de IA, con la demostración desarrollada en colaboración con un modelo de lenguaje grande. Opines lo que opines del anuncio, marca el momento en que la generación de conjeturas, es decir, máquinas que proponen matemática nueva en lugar de limitarse a revisarla, dejó de ser una demo.
El laboratorio presentó tres resultados: la bomba de teoría de la complejidad que acabamos de describir, una supuesta demostración de la conjetura de Kakeya en todas las dimensiones y un resultado de física presentado como una completación unificada del Modelo Estándar, retenido a la espera de verificación formal. La reacción siguió un patrón conocido: asombro genuino por el contenido e irritación genuina por el envoltorio. Los críticos lo compararon con un fabricante de bicicletas que anuncia sus propias victorias en carreras de bicicletas. Es una comparación acertada, pero el contenido merece una mirada más pausada, porque dentro de este anuncio hay una lección real sobre las dos formas muy distintas en que los modelos de lenguaje tocan hoy las matemáticas, y sobre cuál de las dos deberías confiar de verdad.
Qué afirma realmente el anuncio de matemática con IA
Empecemos por el resultado de complejidad, que es el de más peso. La Hipótesis del Tiempo Exponencial dice, a grandes rasgos, que 3-SAT no puede resolverse en tiempo 2^o(n): ningún algoritmo puede ser subexponencial de forma significativa respecto al número de variables. Cientos de artículos de complejidad parametrizada y de grano fino se apoyan en la ETH para demostrar cotas inferiores. Es el tipo de suposición sobre la que apilas una carrera entera de teoremas del tipo «condicionado a la ETH». El nuevo preprint describe un algoritmo determinista de conteo para fórmulas k-CNF que usa espacio polinómico y corre en tiempo 2^(n/(log n)^(1/2+o(1))) multiplicado por un factor polinómico. Ese exponente es o(n), justo lo que la ETH prohíbe. El algoritmo sigue siendo brutalmente lento y nadie lo ejecutará nunca sobre una instancia real, pero asintóticamente es decisivo. Si la demostración se sostiene, una hipótesis que estructuró dos décadas de argumentos de cotas inferiores simplemente deja de existir.
La segunda afirmación apunta a la conjetura de Kakeya, un problema de teoría geométrica de la medida sobre los conjuntos más pequeños que contienen un segmento unitario orientado en todas las direcciones. El caso tridimensional cayó solo en 2025, con una célebre demostración de Hong Wang y Joshua Zahl que muchos vieron como el broche de una carrera. El anuncio afirma una demostración en todas las dimensiones, lo que absorbería por completo ese avance. El tercer resultado, de teoría cuántica de campos, es el más vago de los tres: se describe como una «completación unificada del Modelo Estándar», pero aún no se ha publicado y aparentemente espera una formalización verificada por máquina. Los físicos que leyeron los adelantos sospechan algo de la familia de construcciones tipo gran unificación, más que una teoría de todo literal, y la redacción merece cierto recelo justificado.
Hay dos cosas del lanzamiento que merecen reconocimiento. El laboratorio involucró a matemáticos y físicos en activo antes de hacer público el anuncio, una respuesta directa a la polémica que siguió a un anuncio matemático anterior, más torpe, tras el cual Terence Tao y otros pidieron públicamente exactamente este tipo de colaboración. Y el resultado de física se retuvo hasta que terminó su formalización, que es el orden correcto de prioridades. Pero quedan preguntas duras sin responder: nadie fuera del laboratorio conoce la factura de cómputo, no sabemos si esos mismos fondos destinados a investigadores humanos habrían producido los mismos teoremas, ni si un laboratorio con ánimo de lucro seguirá financiando trabajo guiado por la curiosidad cuando sus accionistas tengan voz. Además está el bucle incómodo que los críticos señalaron de inmediato: estos modelos se entrenan en parte con las preguntas, borradores y publicaciones en foros de la misma comunidad investigadora a la que ahora se le pide que aplauda el resultado.
Verificación de pruebas frente a generación de conjeturas: dos trabajos distintos
Si quitas el bombo, todo sistema de IA para matemáticas hace una de dos cosas. El primer trabajo es la verificación de pruebas: dado un argumento candidato, decidir si es válido. El segundo es la generación de conjeturas: dada un área de problemas, proponer qué vale la pena intentar, ya sea un lema, una construcción, un algoritmo o un contraejemplo. Suenan como dos mitades de una misma habilidad, pero no lo son. Son problemas computacionales distintos, con oráculos distintos, modos de fallo distintos y perfiles de confianza radicalmente diferentes. Confundirlos es la forma más segura de sobrevalorar un comunicado de prensa o de despreciar un progreso real.
La verificación tiene oráculo. Una prueba escrita en Lean compila contra el núcleo o no compila, y el núcleo no se deja impresionar por lo seguro que sonaba el autor. La verificación falla a gritos: un bloque de tácticas rechazado es inequívoco. La generación no tiene oráculo. Una conjetura propuesta puede ser verdadera, falsa, trivialmente verdadera o verdadera pero publicada en 1987 con otra notación. La generación falla en silencio, y sus fallos son sociales: un disparate con aspecto plausible o resultados reales disfrazados de novedad. Aquí la calidad se mide por la importancia y la originalidad, propiedades que define el buen gusto humano y no ningún criterio decidible.
¿Por qué la generación se volvió de pronto lo bastante buena como para importar? Porque los modelos de razonamiento actuales están entrenados para cadenas de pensamiento largas, no solo inducidas por el prompt. El aprendizaje por refuerzo con recompensas verificables, sobre todo en matemáticas y código, donde las respuestas se pueden comprobar mecánicamente, enseñó a estos sistemas a buscar en un espacio de pasos en lugar de autocompletar uno solo. Te propongo una analogía para tener en mente: el verificador de pruebas es un compilador y el generador de conjeturas es un diseñador. Ambos son valiosos. Jamás dejarías que el diseñador certificara su propio trabajo.
Una prueba que no puedes verificar es un sermón; una conjetura que no puedes contrastar es un rumor.
Dónde gana la verificación automatizada de pruebas
El verificador gana siempre que existe una verdad de referencia formal y el artefacto a revisar es demasiado largo o tedioso para que un humano lo audite línea a línea. Lean 4 y su biblioteca comunitaria Mathlib se han convertido en la arena de facto: escribes definiciones y pruebas en un lenguaje de programación, y un núcleo pequeño y auditable por separado decide si cada paso de inferencia es legal. La base de confianza es diminuta comparada con la montaña de matemática construida encima, y esa es exactamente la asimetría que quieres.
El bucle práctico funciona así: el modelo redacta pasos de prueba a nivel de tácticas, el núcleo acepta o rechaza cada uno y los mensajes de rechazo se devuelven como contexto para el siguiente intento. Es el único escenario donde restringir la salida del modelo a una gramática estricta rinde de inmediato: solo muestreas tácticas sintácticamente válidas, así que clases enteras de alucinaciones se vuelven imposibles por construcción. Un ejemplo mínimo, del tipo de lema que hoy un modelo despacha en segundos:
import Mathlib
-- The sum of two even natural numbers is even.
theorem even_add_even {a b : ℕ} (ha : Even a) (hb : Even b) : Even (a + b) := by
rcases ha with ⟨k, rfl⟩   -- a = k + k for some k
rcases hb with ⟨l, rfl⟩   -- b = l + l for some l
exact ⟨k + l, by ring⟩    -- witness k + l; ring closes the algebra
Fíjate en lo que muestra el ejemplo sobre la división del trabajo. El movimiento creativo es elegir el testigo k + l; el movimiento de verificación es que ring compruebe el álgebra. Humanos y modelos se defienden bien en lo primero. Solo el núcleo es fiable en lo segundo, y nunca se cansa, nunca hojea por encima ni califica a ojo. El elemento más creíble de todo el anuncio es precisamente esta puerta: la afirmación de que el artículo de física se retuvo hasta completar su formalización en Lean. Si ese relato es exacto, es el flujo de trabajo funcionando tal como debe: la máquina propone, la máquina dispone, y el comunicado de prensa espera su turno.
Dónde gana la generación de conjeturas
La generación gana siempre que el espacio de búsqueda es combinatorio y la evaluación es barata. FunSearch, de DeepMind, fijó la plantilla en 2023: un modelo de lenguaje propone hipótesis con forma de programa, un evaluador rápido las puntúa y un bucle evolutivo conserva las mejores. Así se obtuvieron nuevas construcciones para conjuntos de capas (cap sets) y heurísticas de empaquetado de contenedores mejores que décadas de ajuste manual. AlphaEvolve llevó la misma idea más lejos y, entre otros resultados, redujo en una multiplicación un algoritmo de multiplicación de matrices 4×4 que llevaba en pie desde la época de Strassen. Nadie afirma que estos sistemas entiendan geometría. No les hace falta. Necesitan proponer, y el evaluador tiene que ser honesto.
El algoritmo de la ETH encaja en este patrón casi sospechosamente bien. El espacio de «ideas algorítmicas» es enorme, y los investigadores humanos lo exploran con fuertes prejuicios, que es una forma educada de decir puntos ciegos. Una construcción que exige combinar un truco de representación concreto con una estructura de recursión concreta puede quedar sin explorar durante treinta años simplemente porque el camino de búsqueda de nadie pasó cerca. La búsqueda exhaustiva, sin prejuicios y algo tonta es justo lo que aportan las máquinas. La misma lógica impulsa los bucles de generar y refutar: propón una conjetura y, de inmediato, intenta matarla con una búsqueda computacional de contraejemplos en casos pequeños. La mayoría de las conjeturas mueren en minutos, y está bien: cada refutación afina la siguiente propuesta, y los supervivientes son los que merecen la tarde de un humano.
Hay también una asimetría psicológica que conviene respetar. La demostración tridimensional de Kakeya de Wang y Zahl costó años de esfuerzo concentrado en la cumbre del campo. Si una búsqueda asistida por modelos produjo de verdad un argumento para todas las dimensiones, casi seguro encontró una ruta distinta por el paisaje: no necesariamente más profunda, sino diferente. Lo diferente es justo para lo que sirve la búsqueda. El peligro no es que las máquinas generen conjeturas, sino que alguien publique una conjetura generada sin la maquinaria que la respalde. Y eso nos lleva a la parte de la cadena que realmente tienes que construir.
Cómo construir un bucle de verificación para pruebas generadas por IA
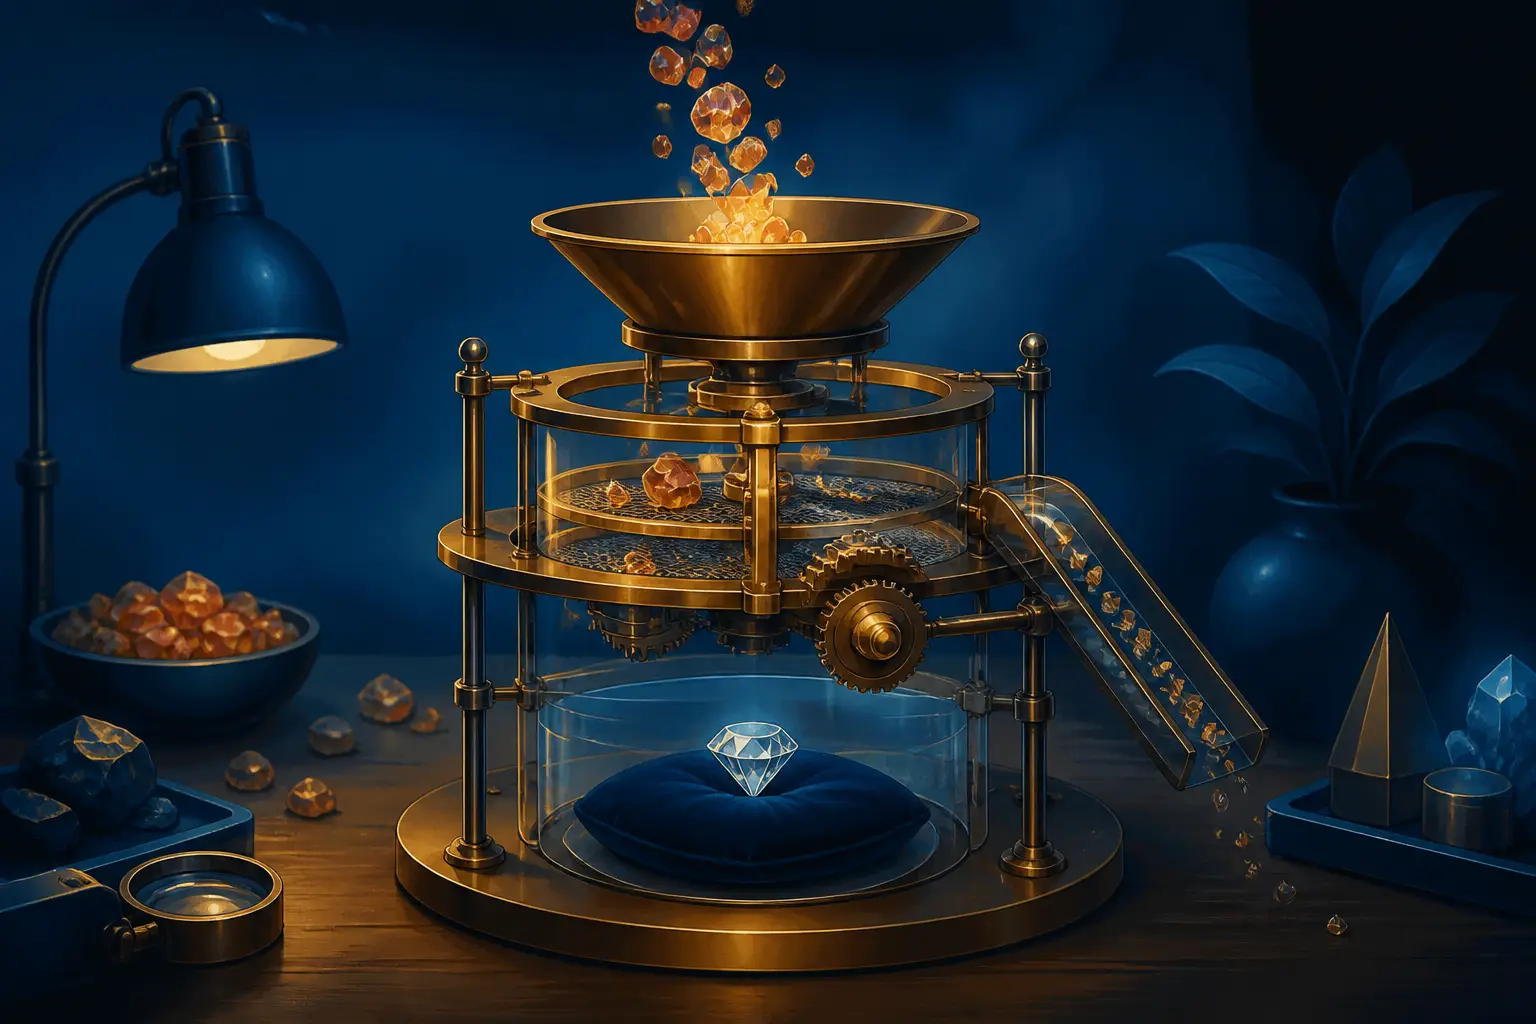
Si quieres los beneficios de la matemática generada por máquinas sin la vergüenza, el flujo de trabajo importa más que el modelo. Este es el pipeline que yo ejecutaría, en orden:
- Generar de forma amplia y barata. En esta etapa gana la diversidad a la profundidad: quieres cobertura del espacio de ideas, no un único intento muy pulido.
- Deduplicar contra la literatura. La recuperación sobre arXiv y MathOverflow atrapa el fallo más común: una conjetura «nueva» que es un resultado conocido con notación desconocida.
- Aplicar filtros empíricos baratos. Prueba casos pequeños numéricamente, busca contraejemplos computacionalmente y deja morir pronto las afirmaciones obviamente falsas.
- Formalizar los supervivientes. Lean, Isabelle o Rocq: elige tu asistente de pruebas, pero ten claro que este es el paso caro y que una prueba en lenguaje natural es un boceto, no un resultado.
- Revisión humana de novedad y enfoque. ¿Importa esto? ¿Es realmente el enunciado correcto? Los modelos optimizan lo demostrable; los humanos deciden qué merece la pena demostrar.
La colaboración anunciada siguió más o menos esta forma: los investigadores entraron antes de la publicación y, en la práctica, ocuparon el quinto paso. Es una mejora genuina frente al viejo método de soltar un preprint y dejar que las redes sociales lo arbitren. Pero fíjate en la asimetría del pipeline: los pasos uno a tres son baratos y escalan con el cómputo, el cuatro es el cuello de botella y el cinco no escala en absoluto. Si estás construyendo herramientas en este campo, invierte en el cuello de botella: mejor autoformalización, mejor retroalimentación de errores hacia el generador, y no en un generador más grande y más seguro de sí mismo.
Por qué los matemáticos humanos siguen controlando la corrección
Ningún verificador puede decirte que un teorema importa. La selección de problemas es gusto, y el gusto es una tecnología social construida durante décadas: seminarios, informes de revisores y el consenso lento sobre qué preguntas abren puertas y cuáles son callejones sin salida. El escepticismo de la comunidad investigadora ante los anuncios de los proveedores no es un simple afán de control: es un sistema inmunitario, y los sistemas inmunitarios a veces reaccionan de más precisamente porque no reaccionar a tiempo resulta fatal.
Luego está la procedencia. Estos modelos se entrenan con las preguntas, borradores y publicaciones de foros de la propia comunidad, lo que abre la incómoda posibilidad de que un «descubrimiento» celebrado sea una recombinación de cosas que escribieron sus futuros revisores. El temor a que tu propia herramienta te gane la carrera no es paranoia: es un problema de linaje de datos, y mientras los laboratorios no puedan demostrar ese linaje, los revisores humanos siguen siendo los únicos detectores de plagio que funcionan. Súmale la política del reconocimiento: quién recibe la invitación para verificar, cuyos nombres aparecen en el anuncio, las acusaciones de favoritismo. Así se ve por qué la puerta humana no puede eliminarse. Elegir a cinco científicos eminentes para bendecir un resultado es tanto un acto político como epistémico.
Una advertencia más para quien esté tentado de leer los rankings como prueba de capacidad investigadora: las medallas de oro en competiciones miden el rendimiento en problemas diseñados para resolverse en horas. La investigación tiene la distribución opuesta: problemas elegidos precisamente porque nadie sabe si son resolubles. Es la misma razón por la que los benchmarks no capturan la mayor parte del trabajo real en ingeniería de software: la métrica premia el problema moldeado, no el desordenado. Un modelo que resuelve problemas de olimpiada con soltura ha demostrado algo real. No ha demostrado criterio.
La recomendación: confía en el bucle, no en el modelo
Mi postura, dicha claramente: la generación de conjeturas es real, útil y solo va a mejorar; pero la generación de conjeturas no verificada no vale nada, y las pruebas en lenguaje natural sin respaldo formal deberían tratarse como marketing hasta que se demuestre lo contrario. La verificación gana siempre que el artefacto tiene que ser creído. La generación gana siempre que el cuello de botella es la imaginación y no el rigor. Los anuncios que importan son aquellos en los que ambas cosas están soldadas juntas.
Así que trata al modelo como a un colaborador junior muy prolífico, con energía infinita y sin criterio: todo lo que te entregue pasa por el asistente de pruebas antes de entrar en el artículo, y por una persona con buen gusto antes de llegar a la introducción. Si eres investigador, aprende bien un asistente de pruebas: la formalización es el cuello de botella, y quienes sepan manejarla van a estar muy ocupados. Si construyes herramientas, construye el bucle, no la demo. Y cuando llegue el próximo gran anuncio, sáltate el comunicado de prensa, abre el preprint y comprueba si existe el repositorio de Lean. Las afirmaciones que sobreviven son las que llegan ya verificadas por máquina.


