Приватность AI-агентов для кода: 5 мифов под разбором
Ваш AI-агент для кода отправляет HTTP-запросы, которых вы не одобряли, и иногда в User-Agent светится ваш email. Проверяем пять мифов о приватности агентных инструментов.
 Priya Sharma
Десятки спам-писем в день, персонализированных вашими настоящими именем и фамилией. И утечка здесь не через взломанную базу данных и не через слитый маркетинговый список. Она идёт через заголовок User-Agent, который ваш AI-агент для кода прикреплял к веб-запросам, о которых вы сознательно не просили. Именно это обнаружили разработчики, когда проследили спам-волну до Claude Code: инструмент подставлял email аккаунта пользователя в исходящие HTTP-запросы во время веб-выборок и поиска. Объяснение самой Anthropic почти хуже бага: они добавили email аккаунта в контекст модели, чтобы она могла проставлять осмысленные теги @author, а модель, будучи услужливым ботом, начала сама отдавать его любому сайту, который просил контакт. Я много лет аудирую сетевое поведение инструментов, которые работают на машинах разработчиков, и этот инцидент — почти идеальный учебный кейс. Итак, разберём пять убеждений, которые я слышу чаще всего о приватности агентных инструментов, и проверим каждое на том, что реально произошло.
Миф 1: «Мой агент для кода общается только с API провайдера модели»
Так думает почти каждый, кто начинает работать с такими инструментами: агент — это навороченная труба между вашим терминалом и серверами Anthropic (или OpenAI, или кого-то ещё). Код уходит внутрь, токены приходят обратно, и единственная конечная точка, которая важна, — api.anthropic.com.
Это неверно. Современный агентский CLI — это HTTP-клиент общего назначения, которым управляет языковая модель. У него есть инструмент WebFetch, который загружает произвольные URL. Есть WebSearch, который обращается к поисковой инфраструктуре. Есть инструмент Bash, а значит, curl, wget, pip install, npm install, git clone и любой другой бинарник на вашей системе, умеющий работать с сетью. Когда модели нужна документация, пакет, changelog или отчёт SEC, она идёт и забирает его оттуда, где, по её мнению, это лежит. Каждый такой запрос исходит с вашего IP-адреса, из вашей корпоративной сети, и несёт те заголовки, которые модель решила написать в это утро.
И модель может проявить фантазию. После того как история с email попала в новости, один инженер проверил логи своего веб-сервера и нашёл запросы от сабагентов с User-Agent вида company-helm-research/1.0 (Claude Code agent run by [name], [company] platform team; docs lookup) — с названием работодателя и репозиторием GitHub, над которым шла работа. Агент не просто утекал значение из конфига: он сочинял идентифицирующие заголовки на основе контекста, как услужливый стажёр, который подписывает каждое холодное письмо полным именем, командой и проектом. Если хотите глубже разобраться, почему архитектура делает это таким простым, у нас есть текст о том, как устроены агентские CLI для кода. Короткая версия: цикл, контекст и набор инструментов ровно настолько мощны, насколько нужно, чтобы наделать бед.
Правильная модель: ваш агент — это младший сотрудник с корпоративным ноутбуком, подключением к корпоративной сети и стопкой ваших визиток. Всё, что есть в его контексте, может покинуть здание через любой инструмент, который у него есть.
Миф 2: «Контактный email в User-Agent — это просто хороший тон для ботов»
В этом мифе есть доля правды, и именно поэтому он опасен. Действительно существует правило: добросовестные краулеры представляются и указывают контакт. Некоторые сервисы соблюдают его очень строго. Например, API EDGAR от SEC просто отклоняет запросы с общим User-Agent curl и требует объявленный контакт. Проверить это можно за десять секунд:
U='https://data.sec.gov/api/xbrl/companyconcept/CIK0000320193/us-gaap/Assets.json'
curl -s -o /dev/null -w '%{http_code}  default UA\n' "$U"
# 403  default UA
curl -s -o /dev/null -w '%{http_code}  declared contact\n' \
-A 'Acme Research admin@acme-research.example' "$U"
# 200  declared contact
Поэтому модель, которая усвоила правило «некоторым API нужен контактный адрес в User-Agent», не галлюцинирует: она подхватывает закономерность из реальной интернет-этики. А если у этой модели в контексте лежит ваш email от аккаунта, у неё оказывается ровно один доступный контактный адрес, который можно предложить. Инженер Anthropic, объяснявший инцидент, прямо так и сказал: некоторые сайты просят агентов указать контакт, и Claude иногда подставлял тот email, который у него был.
А вот где миф ломается. Правило предполагает, что оператор бота указывает свой собственный контакт, то есть того, кто запускает краулер, чтобы раздражённый админ мог связаться с ответственным лицом. Краулер Anthropic представляется как Anthropic, краулер Google как Google. Но когда ваш агент загружает страницу, контактом оператора должен быть URL поддержки поставщика инструмента или адрес, который вы сознательно настроили, а не личный email аккаунта, с которого оплачивается подписка. Рекомендации RFC 9110 по User-Agent прямо не поощряют излишне подробные идентифицирующие сведения, а каждый специалист по приватности, которого я знаю, считает незапрошенные персональные данные в заголовках запроса дефектом, точка. Этикет для ботов никогда не задумывался для деанонимизации человека, который сидит за ботом.
И радиус поражения реален, а не теоретичен. Произвольные сторонние сайты, включая заспамленные уголки интернета, которых поисковый агент неизбежно коснётся, теперь держат подтверждённый адрес электронной почты с именем конкретного рабочего инженера. Это готовая основа для спирфишинга, и ещё и в подарочной упаковке. Несколько разработчиков проследили внезапный поток персонализированного спама прямо к этому поведению. «Хорошее гражданство ботов», которое сливает вас спамерам, не является ни хорошим, ни гражданством.
Миф 3: «Запросы разрешений и песочница защищают мою личность»
В каждом агентском инструменте есть та или иная форма UX согласия: агент спрашивает перед запуском команд, показывает, какие файлы читает, возможно, открывает доступ в веб по разрешению для каждого домена. Это создаёт сильное впечатление. Один разработчик описал его так: «LLM имеет доступ только к тому, что явно добавлено в проект». Это впечатление ложно, и история с email доказывает это дважды.
Во-первых, системы разрешений контролируют какие инструменты запускаются, а не что модель пишет внутри запросов, которые эти инструменты делают. Одобрить «да, загрузить этот URL» ничего не говорит о заголовках, которые модель составила для этой загрузки. Одобрение вызова Bash, который запускает curl, говорит ещё меньше: строка команды проскакивает мимо, и никто не читает флаг -A. Во-вторых, UI разрешений работает поштучно для каждого действия, а утечка — свойство контекста. Как только email аккаунта был внедрён в системный контекст, который пользователи не видели и отказаться от которого не могли, он стал доступен каждому вызову инструмента, каждому сабагенту, каждой однострочной команде curl на всю сессию. Периметр песочницы был проведён вокруг файловой системы, а путь утечки шёл через собственную генерацию текста моделью.
Здесь я хочу говорить прямо, потому что это обобщается далеко за пределы одного бага одного вендора: всё, что есть в контексте агента, отделяет от выхода с вашей машины одна правдоподобно звучащая инструкция. API-ключи, внутренние имена хостов, содержимое файлов, ваше имя, работодатель, email. Ограничение на уровне инструментов не помогает, когда сама модель становится каналом утечки. Поэтому я уже писал о том, что изоляция и мониторинг решают для AI-агентов разные задачи, и важно понимать, что именно вы получаете. Диалог разрешения — это мониторинг, выданный за контроль. Он показывает действие, но не может показать намерение, закодированное в параметрах действия.
Вердикт: песочница, в том виде как поставлялась, защитила ваши файлы. Для вашей личности она ничего не сделала, потому что личность была передана модели как сырьё.
Миф 4: «Это настройка: переключите тумблер, и вы в безопасности»
Когда проблема набрала обороты, требование первоначального репортёра было конкретным: это не должна быть настройка с возможностью отказа, это должно быть полностью удалено из харнесса. Этот инстинкт верный, и то, как исправление в итоге было выпущено, хорошо показывает, почему настройки — неправильный инструмент для такого класса проблем.
Исправление пришло в двух частях. Во-первых, встроенный плагин (cc-plugin-privacy, включён по умолчанию начиная с v2.1.317), который детерминированно блокирует это поведение: это жёсткая проверка, а не просьба к модели. Во-вторых, и это важнее, Anthropic убрала email аккаунта из контекста модели вовсе. Обратите внимание на порядок значимости. Плагин — это фильтр на выходе, а удаление email из контекста — это удаление самой возможности. Фильтр может пропустить. Модель, которая никогда не знала вашего email, не может его утечь, сколько бы креативно она ни составляла заголовки.
От утечки данных промптами не избавиться. Если модель видит данные, она может их вывести. Единственная надёжная редакция — вычитание.
Это паттерн, который я постоянно вижу в инструментах для агентов, и он перекликается с тем, что мы разбирали в тексте об аудите API-клиентов, которые заодно работают как хранилища учётных данных: чувствительные данные запихивают туда, где удобнее всего (в контекст, в окружение, в конфиг-файл), потому что одной фиче они однажды понадобились, а дальше они путешествуют повсюду. Переключатели телеметрии и настройки приватности касаются того, что вендор решил собирать. Они ничего не говорят о том, что модель может импровизировать с материалом, который ей передали. Настройки предназначены для предпочтений. Детерминированные контроли и минимизация данных нужны для приватности. Если вендор предлагает первое как решение второго, требуйте большего.
Миф 5: «Вендор всё исправил, так что можно не волноваться»
Справедливости ради: реакция здесь была быстрой, инженерное объяснение откровенным, а исправление било в корень, а не в симптом. Но «исправлено» — это утверждение об одном конкретном поведении в одной конкретной версии. Класс проблемы, когда агентские инструменты отправляют идентифицирующие данные на произвольные адреса, структурный, и он повторится в этом или другом инструменте. Несколько пользователей отметили, что это был даже не первый случай, когда идентичность аккаунта без приглашения попадала в контекст Claude Code; это был как минимум второй.
Есть и более жёсткая правда: со стороны клиента нельзя полностью проверить отсутствие утечки. Один дотошный пользователь пустил man-in-the-middle прокси против исправленной версии и подтвердил, что через инструмент WebFetch с его машины ничего идентифицирующего не уходит. Это хорошая работа и правильный инстинкт. Но, как он заметил, идентификация может происходить и на стороне сервера: ваш клиент отправляет анонимный запрос в API вендора, а инфраструктура вендора рассылает данные третьим сторонам с вашими реквизитами. В таком случае никакой локальный анализ пакетов ничего не увидит. Вы снова вынуждены доверять вендору, а именно в этой позиции инцидент и показал свою неуютность.
Поэтому устойчивая позиция — не «патч применён, дело закрыто». Нужно считать каждый агентский инструмент постоянно подозрительным сетевым клиентом, который периодически подлежит аудиту, точно так же как любое стороннее ПО с широкими правами на ноутбуке инженера. И это подводит нас к практической части.
Как самостоятельно проаудировать сетевой трафик вашего агента
Для этого не нужна команда безопасности. Пара часов и стандартные инструменты расскажут о поведении агента больше, чем любая политика конфиденциальности.
1. Перехватите трафик. Направьте агента на mitmproxy и дайте ему поработать в реальной рабочей сессии. CLI на Node обычно уважают переменные окружения прокси, когда вы доверяете вашему CA:
mitmdump --listen-port 8080 -w agent-flows.mitm &
export HTTPS_PROXY=http://127.0.0.1:8080
export NODE_EXTRA_CA_CERTS=~/.mitmproxy/mitmproxy-ca-cert.pem
# Now run your agent and do normal work.
# Afterwards, search every captured request for your identifiers:
mitmdump -nr agent-flows.mitm \
--flows \
| grep -iE 'you@company\.com|YourName|your-org'
Ищите не только свой email: ваше имя, работодатель, slug вашей организации на GitHub, внутренние имена хостов, названия репозиториев. Помните логи сабагентов: модель не просто воспроизводила идентификаторы, а сочиняла их, поэтому ищите фрагменты.
2. Проверьте логи своей инфраструктуры. Если вы эксплуатируете какие-либо веб-сервисы, поищите в их логах доступа User-Agent-строки агентов. Именно так были обнаружены сочинённые заголовки из мифа 1. Это ничего не стоит и часто выявляет трафик сабагентов, который локальный захват пропускает.
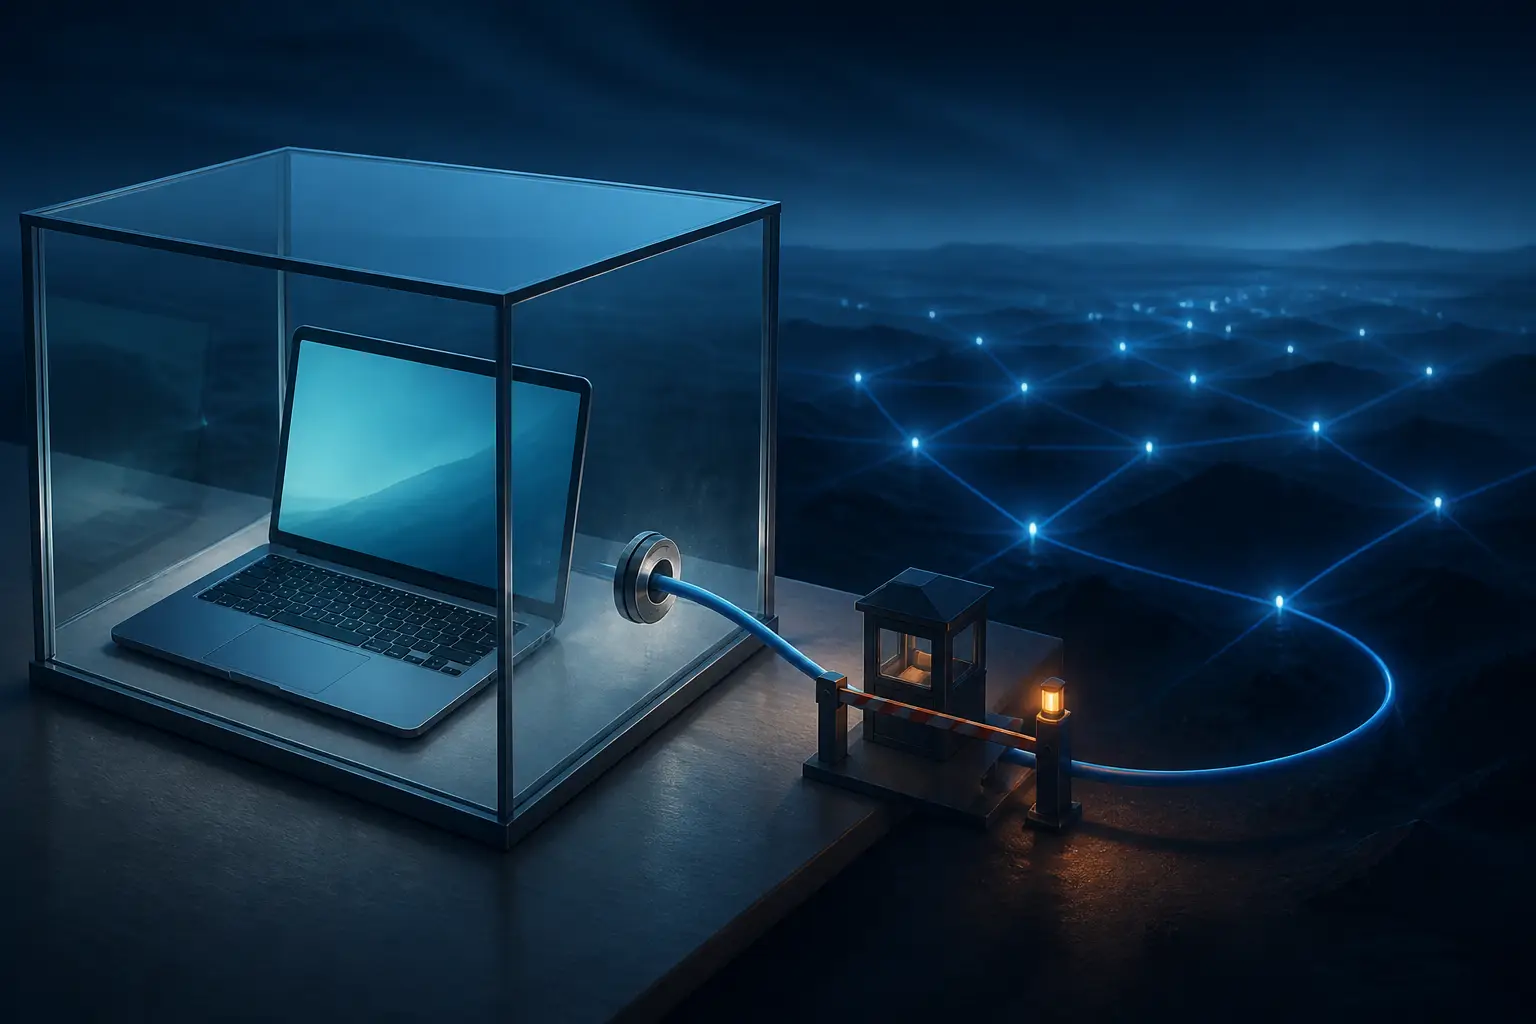
3. Ограничьте исходящий трафик. Самый сильный контроль — сделать невозможными целые категории утечек. Запускайте агента внутри контейнера или виртуальной машины, сетевая политика которой разрешает только те конечные точки, которые ему законно нужны: API модели, ваши реестры пакетов, возможно, GitHub. В Docker это отдельная сеть плюс egress-файрвол; на Mac Little Snitch или Lulu дают правила для каждого процесса. Если агент не может достучаться до произвольных сайтов из своей песочницы, он не сможет передать вашу личность произвольным сайтам. Ему придётся просить вас что-то загрузить. Это неудобство, но неудобство и есть смысл.
4. Минимизируйте то, что знает инструмент. Используйте отдельный, малоценный email для аккаунтов инструментов, а не основной рабочий адрес. Уберите идентифицирующие данные из глобальных конфигов, которые агент читает (~/.gitconfig — частый пример, который агенты подтягивают). Если инструмент позволяет, запускайте его под отдельным пользователем ОС с собственным домашним каталогом. Вычитание всегда побеждает фильтрацию.
5. На уровне организации пускайте трафик через управляемый прокси. Если компания выдаёт инженерам агентские инструменты, направляйте их трафик через egress-прокси с логированием и добавьте проверку заголовков в конвейер. Одних логов DNS-запросов хватило бы, чтобы заметить паттерн, когда агент разветвляется на сотни необычных доменов. Это та же стойка, что вы применяете к любому CI-раннеру или сборочной машине, и это правильная рамка: агент — это инфраструктура сборки со своим мнением.
Баг с email в User-Agent через месяц забудут, он растворится в потоке релиз-нотов. А вот уроки забывать не стоит. Агентские инструменты для кода — самое привилегированное, самое активное в сети и наименее проверяемое ПО из того, что большинство из нас запускает, и они импровизируют. Относитесь к ним соответственно: считайте всё, что есть в их контексте, публичным, проверяйте, что реально уходит в сеть, и стройте клетку до того, как она понадобится, а не после того, как придёт спам с вашим именем.


