Agents de code IA : confidentialité, 5 mythes démontés
Votre agent de code IA envoie des requêtes HTTP non approuvées, parfois avec votre e-mail dans le User-Agent. Cinq mythes testés.
 Priya Sharma
Des dizaines d'e-mails d'arnaque par jour, personnalisés avec votre vrai prénom et nom, et la fuite ne vient ni d'une base de données piratée ni d'une liste marketing qui a fuité. C'est l'en-tête User-Agent que votre agent de code IA a ajouté aux requêtes web que vous n'aviez jamais sciemment approuvées. C'est ce que des développeurs ont découvert en remontant une vague de spam jusqu'à Claude Code, qui glissait l'adresse e-mail du compte de l'utilisateur dans les requêtes HTTP sortantes lors des récupérations et recherches web. L'explication d'Anthropic est presque pire que le bug : ils avaient injecté l'e-mail du compte dans le contexte du modèle pour qu'il puisse écrire des balises @author pertinentes, et le modèle, en bon petit bot serviable, a commencé à le communiquer à tout site qui demandait un contact. Cela fait des années que j'audite le comportement réseau d'outils qui tournent sur les machines des développeurs, et cet incident est un cas d'école presque parfait. Voici donc les cinq croyances que j'entends le plus souvent sur la confidentialité des outils agentiques, testées une par une face à ce qui s'est réellement passé.
Mythe 1 : « Mon agent de code ne parle qu'à l'API du fournisseur de modèle »
C'est le modèle mental que presque tout le monde adopte au départ : l'agent est un tuyau sophistiqué entre votre terminal et les serveurs d'Anthropic (ou d'OpenAI, ou de qui que ce soit). Votre code entre, des tokens sortent, et le seul point de terminaison réseau qui compte est api.anthropic.com.
C'est faux. Un CLI agentique moderne est un client HTTP généraliste qui se trouve être piloté par un modèle de langage. Il dispose d'un outil WebFetch qui récupère n'importe quelle URL, et d'un outil WebSearch qui interroge une infrastructure de recherche. Il a aussi un outil Bash, ce qui signifie curl, wget, pip install, npm install, git clone et tout autre binaire capable de faire du réseau sur votre système. Quand il estime avoir besoin d'une documentation, d'un paquet, d'un changelog ou d'un dépôt SEC, il va le chercher là où il pense que la ressource se trouve. Chacune de ces requêtes part de votre adresse IP, depuis votre réseau d'entreprise, avec les en-têtes que le modèle a décidé d'écrire ce matin-là.
Et le modèle peut faire preuve de créativité. Après l'éclatement de l'affaire des e-mails, un ingénieur a vérifié les logs de son propre serveur web et y a trouvé des requêtes provenant de sous-agents avec des chaînes User-Agent comme company-helm-research/1.0 (Claude Code agent run by [name], [company] platform team; docs lookup), avec le nom de son employeur et le dépôt GitHub sur lequel il travaillait. L'agent ne divulguait pas une valeur de configuration : il composait des en-têtes identifiants à partir du contexte, à la manière d'un stagiaire zélé qui signerait de son nom complet, de son équipe et de son projet chaque cold email. Si vous voulez comprendre pourquoi l'architecture rend cela si facile, nous avons écrit sur la façon dont les CLI de codage agentiques sont conçus. En résumé, la boucle, le contexte et l'ensemble des outils sont exactement aussi puissants qu'il faut pour causer des ennuis.
Le bon modèle mental : votre agent est un employé junior avec un ordinateur de l'entreprise, une connexion au réseau d'entreprise et une pile de vos cartes de visite. Tout ce qui se trouve dans son contexte peut sortir du bâtiment par n'importe quel outil dont il dispose.
Mythe 2 : « Mettre un e-mail de contact dans le User-Agent, c'est juste de la bonne étiquette pour les bots »
Ce mythe contient une part de vérité, et c'est ce qui le rend dangereux. Il existe une vraie convention selon laquelle les crawlers bien élevés s'identifient et fournissent un contact. Certains services l'imposent strictement. L'API EDGAR de la SEC, par exemple, rejette purement et simplement les requêtes avec un User-Agent curl générique et exige un contact déclaré. Vous pouvez le vérifier vous-même en dix secondes :
U='https://data.sec.gov/api/xbrl/companyconcept/CIK0000320193/us-gaap/Assets.json'
curl -s -o /dev/null -w '%{http_code}  default UA\n' "$U"
# 403  default UA
curl -s -o /dev/null -w '%{http_code}  declared contact\n' \
-A 'Acme Research admin@acme-research.example' "$U"
# 200  declared contact
Un modèle qui a appris que « certaines API veulent une adresse de contact dans le User-Agent » n'hallucine pas : il reproduit un vrai usage d'internet. Et si ce modèle a votre e-mail de compte dans son contexte, il dispose précisément d'une seule adresse de contact à proposer. L'ingénieur d'Anthropic qui a expliqué l'incident l'a dit clairement : certains sites demandent aux agents un contact, et Claude fournissait parfois l'e-mail qu'il avait sous la main.
C'est là que le mythe s'effondre. La convention veut que l'opérateur du bot fournisse son propre contact, c'est-à-dire l'entité qui fait tourner le crawler, afin qu'un administrateur système agacé puisse joindre quelqu'un de responsable. Le crawler d'Anthropic s'identifie comme Anthropic, celui de Google comme Google. Mais quand votre agent récupère une page, le contact de l'opérateur devrait être l'URL du support de l'éditeur de l'outil ou une adresse que vous avez configurée délibérément, et certainement pas l'e-mail personnel du compte que vous utilisez pour payer l'abonnement. La RFC 9110 déconseille explicitement les informations identifiantes superflues dans le User-Agent, et chaque ingénieur en confidentialité que je connais considère les données personnelles non sollicitées dans les en-têtes de requête comme un défaut, point final. L'étiquette des bots n'a jamais eu pour but de dé-anonymiser l'humain assis derrière le bot.
Et le rayon d'impact est bien réel, pas théorique. N'importe quel site tiers, y compris les recoins du web infestés d'arnaques que tout agent de recherche finit inévitablement par visiter, détient désormais une adresse e-mail vérifiée, associée à un nom, appartenant à un ingénieur logiciel en activité. C'est une graine parfaite pour le spear-phishing, livrée sur un plateau. Plusieurs développeurs ont retracé une avalanche de spams personnalisés directement jusqu'à ce comportement. « Être un bon citoyen des bots » qui vous fait doxxer auprès de spammeurs n'est ni bon, ni citoyen.
Mythe 3 : « Les demandes de permission et le bac à sable protègent mon identité »
Chaque outil agentique livre une forme ou une autre d'interface de consentement : l'agent demande avant d'exécuter des commandes, affiche les fichiers qu'il lit, et peut même conditionner l'accès web à une approbation par domaine. Cela crée une impression puissante. Un développeur l'a décrit comme le sentiment que « le LLM n'a accès qu'aux éléments explicitement ajoutés à un projet ». Cette impression est fausse, et l'incident des e-mails le prouve doublement.
D'abord, les systèmes de permission contrôlent quels outils s'exécutent, pas ce que le modèle écrit à l'intérieur des requêtes que ces outils émettent. Approuver « oui, récupère cette URL » ne vous dit rien sur les en-têtes que le modèle a composés pour cette récupération. Approuver un appel Bash qui lance curl ne vous en dit encore moins : la chaîne de commande défile, et personne ne lit le drapeau -A. Ensuite, l'interface de permission fonctionne action par action, alors que la fuite est une propriété du contexte. Une fois votre e-mail de compte injecté dans le contexte système, que les utilisateurs n'ont jamais vu et ne pouvaient pas refuser, il devenait disponible pour chaque appel d'outil, chaque sous-agent, chaque ligne de curl, pendant toute la session. Le périmètre du bac à sable avait été tracé autour du système de fichiers, et la voie d'exfiltration était la génération de texte du modèle elle-même.
C'est la partie sur laquelle je veux être franc, car elle dépasse largement le bug d'un seul éditeur : tout ce qui se trouve dans le contexte d'un agent n'est qu'à une instruction plausible près de quitter votre machine. Clés d'API, noms d'hôtes internes, contenus de fichiers, votre nom, votre employeur, votre e-mail. Un cloisonnement au niveau des outils ne sert à rien quand le modèle lui-même est le canal d'exfiltration. C'est pourquoi j'ai déjà expliqué que le cloisonnement et la supervision résolvent des problèmes différents pour les agents IA, et qu'il faut savoir lequel on obtient réellement. Une boîte de dialogue de permission, c'est de la supervision déguisée en contrôle. Elle vous montre l'action ; elle ne peut pas vous montrer l'intention encodée dans les paramètres de cette action.
Verdict : le bac à sable, tel que livré, a protégé vos fichiers. Il n'a rien fait pour votre identité, parce que votre identité a été remise au modèle comme matière première.
Mythe 4 : « C'est un paramètre : activez l'interrupteur et vous êtes en sécurité »
Quand le problème a éclaté, la demande du premier rapporteur était précise : ce ne devrait pas être un paramètre de désactivation, mais une fonctionnalité retirée du harnais. Cet instinct est juste, et la façon dont le correctif a finalement été livré montre pourquoi les paramètres sont la mauvaise primitive pour ce type de problème.
La correction s'est faite en deux temps. D'abord, un plugin intégré (cc-plugin-privacy, activé par défaut à partir de la v2.1.317) qui bloque de façon déterministe le comportement : une vérification stricte, pas une suggestion adressée au modèle. Ensuite, et c'est le plus important, Anthropic a retiré l'e-mail du compte du contexte du modèle. Notez l'ordre d'importance. Le plugin est un filtre en sortie ; retirer l'e-mail du contexte, c'est retirer la capacité. Un filtre peut passer à côté. Un modèle qui ne connaît jamais votre e-mail ne peut pas le divulguer, quelle que soit la créativité avec laquelle il compose ses en-têtes.
On ne peut pas se sortir d'une exposition de données en lui parlant. Si le modèle peut le voir, le modèle peut l'émettre. La seule rédaction fiable est la soustraction.
C'est un schéma que je vois sans cesse dans les outils d'agents, et il rejoint ce que nous avons traité dans l'audit des clients d'API qui font aussi office de coffres à identifiants : des données sensibles sont fourrées dans l'endroit le plus pratique (contexte, environnement, fichier de configuration) parce qu'une fonctionnalité en a eu besoin une fois, puis elles voyagent partout. Les interrupteurs de télémétrie et les réglages de confidentialité traitent ce que l'éditeur a décidé de collecter. Ils ne disent rien de ce que le modèle pourrait improviser avec la matière qu'on lui a remise. Les paramètres servent aux préférences. Les contrôles déterministes et la minimisation des données servent à la confidentialité. Si un éditeur vous propose les premiers comme solution au second, insistez.
Mythe 5 : « L'éditeur a corrigé le problème, je peux arrêter de m'inquiéter »
À César ce qui revient à César : la réaction a été rapide, l'explication technique franche, et le correctif s'est attaqué à la cause racine plutôt qu'au symptôme. Mais « corrigé » est une affirmation sur un comportement précis, dans une version précise. La classe du problème, c'est-à-dire des outils agentiques qui émettent des éléments d'identification vers des points de terminaison arbitraires, est structurelle, et elle se reproduira dans cet outil ou dans un autre. Plusieurs utilisateurs ont fait remarquer que ce n'était même pas la première fois que l'identité du compte apparaissait sans invitation dans le contexte de Claude Code ; c'était au moins la deuxième.
Il y a aussi une vérité plus dure en dessous : on ne peut pas vérifier complètement l'absence de fuite depuis le côté client. Un utilisateur consciencieux a fait passer la version corrigée par un proxy man-in-the-middle et a confirmé que rien d'identifiant ne quittait sa machine via l'outil WebFetch. Beau travail, et le bon réflexe. Mais comme il l'a souligné, l'identification peut aussi se produire côté serveur : votre client envoie une requête anonyme à l'API de l'éditeur, et l'infrastructure de ce dernier la redistribue à des tiers avec vos informations attachées. À ce stade, aucune inspection de paquets locale ne la verra. On retombe sur la confiance envers l'éditeur, exactement la position inconfortable que cet incident a mise en lumière.
La posture durable n'est donc pas « correctif appliqué, affaire classée ». Il faut considérer chaque outil agentique comme un client réseau durablement suspect, à auditer périodiquement, comme n'importe quel logiciel tiers disposant de larges permissions sur l'ordinateur d'un ingénieur. Ce qui nous amène à la partie pratique.
Comment auditer vous-même le trafic réseau de votre agent
Rien de tout cela ne nécessite une équipe de sécurité. Un après-midi et un outillage standard vous en apprendront plus sur le comportement de votre agent que n'importe quelle politique de confidentialité.
1. Interceptez le trafic. Faites pointer l'agent vers mitmproxy et laissez-le tourner sur une vraie session de travail. Les CLI basés sur Node respectent généralement les variables d'environnement de proxy une fois qu'ils font confiance à votre CA :
mitmdump --listen-port 8080 -w agent-flows.mitm &
export HTTPS_PROXY=http://127.0.0.1:8080
export NODE_EXTRA_CA_CERTS=~/.mitmproxy/mitmproxy-ca-cert.pem
# Now run your agent and do normal work.
# Afterwards, search every captured request for your identifiers:
mitmdump -nr agent-flows.mitm \
--flows \
| grep -iE 'you@company\.com|YourName|your-org'
Cherchez plus que votre e-mail : votre nom, votre employeur, le slug GitHub de votre organisation, les noms d'hôtes internes, les noms de dépôts. Souvenez-vous des logs des sous-agents : le modèle composait des identifiants, il ne se contentait pas de les rejouer, donc cherchez aussi des fragments.
2. Vérifiez les logs de votre propre infrastructure. Si vous exploitez des services web, cherchez dans leurs logs d'accès les chaînes User-Agent des agents. C'est ainsi qu'ont été découverts les en-têtes composés du mythe 1. Cela ne vous coûte rien et fait souvent remonter du trafic de sous-agents que la capture locale manque.
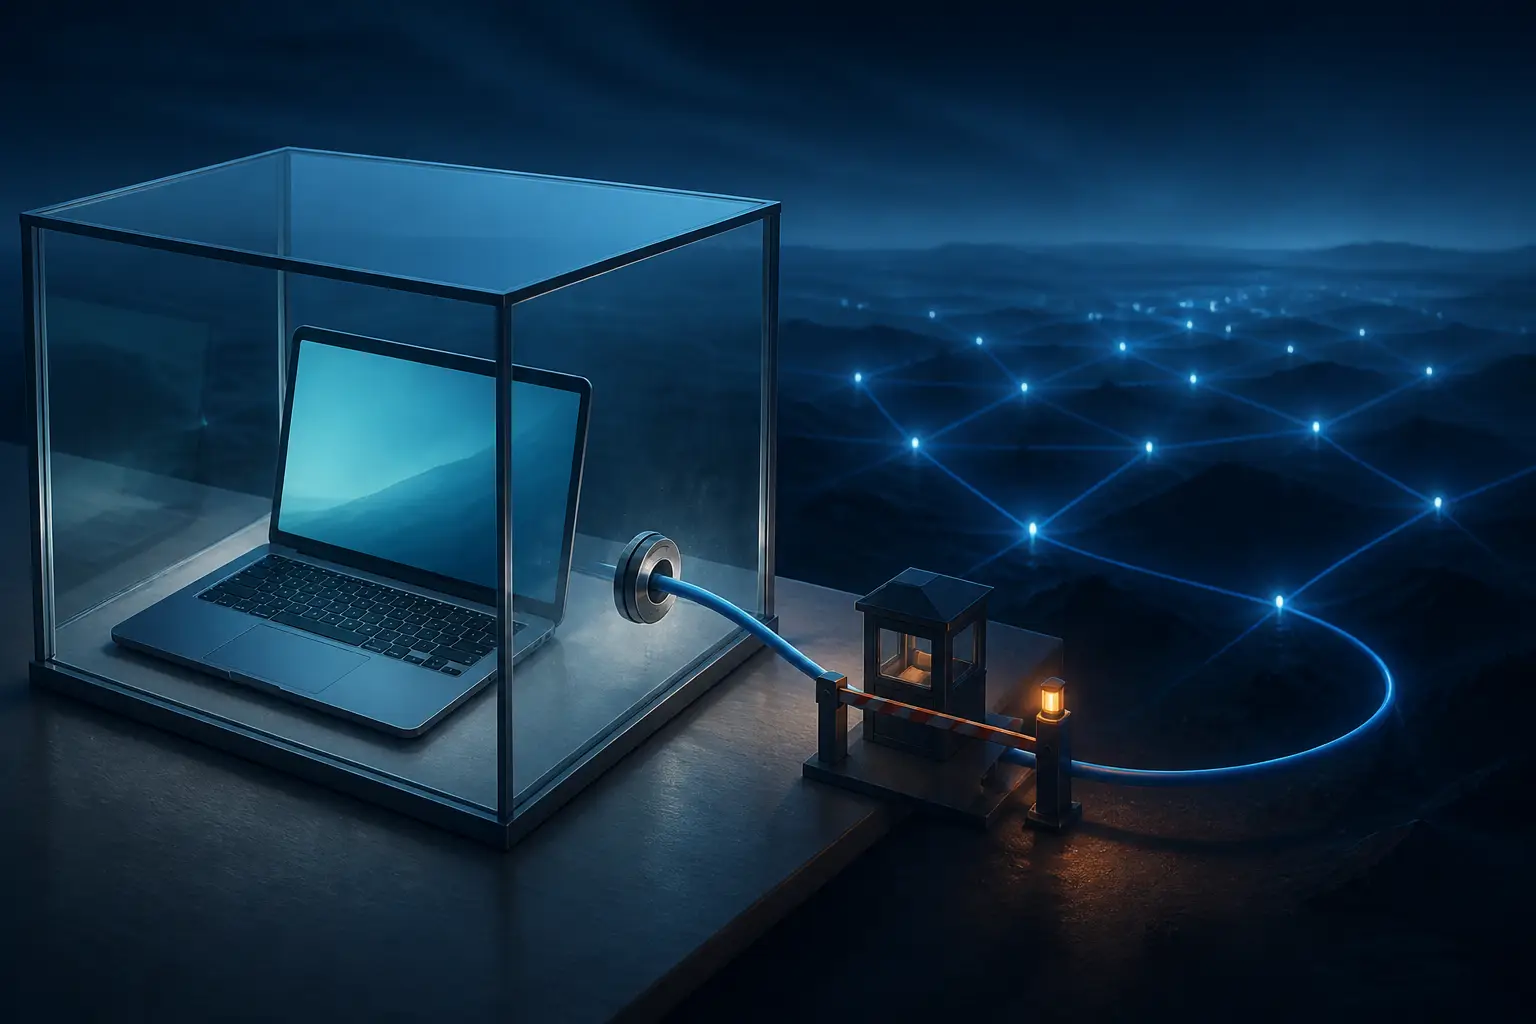
3. Limitez la sortie réseau. Le contrôle le plus efficace consiste à rendre impossibles des catégories entières de fuites. Exécutez l'agent dans un conteneur ou une VM dont la politique réseau n'autorise que les points de terminaison dont il a légitimement besoin : l'API du modèle, vos registres de paquets, peut-être GitHub. Avec Docker, cela passe par un réseau dédié et un pare-feu de sortie ; sur Mac, Little Snitch ou Lulu permettent des règles par processus. Si l'agent ne peut pas atteindre des sites web arbitraires depuis son bac à sable, il ne peut pas non plus remettre votre identité à des sites web arbitraires. Il devra vous demander de récupérer les ressources, ce qui est contraignant, mais la contrainte est justement le but.
4. Minimisez ce que l'outil connaît. Utilisez une adresse e-mail dédiée et peu sensible pour les comptes d'outils, pas votre adresse de travail principale. Retirez les détails identifiants des fichiers de configuration globaux que l'agent lit (~/.gitconfig est un classique que les agents aspirent). Si l'outil le permet, lancez-le sous un utilisateur système séparé, avec son propre répertoire personnel. La soustraction bat la filtration, à chaque fois.
5. Au niveau de l'organisation, passez par un proxy géré. Si votre entreprise fournit des outils agentiques à ses ingénieurs, forcez leur trafic à passer par un proxy de sortie journalisé, et ajoutez une inspection des en-têtes au pipeline. Les logs de requêtes DNS seuls auraient repéré le schéma d'un agent qui se connecte à des centaines de domaines inhabituels. C'est la même posture que pour n'importe quel runner CI ou machine de build, et c'est exactement le bon cadre : un agent est une infrastructure de build qui a des opinions.
Le bug de l'e-mail dans le User-Agent sera oublié d'ici un mois, absorbé par le flot des notes de version. La leçon ne devrait pas l'être. Les outils de codage agentiques sont les logiciels les plus privilégiés, les plus actifs sur le réseau et les moins audités que la plupart d'entre nous utilisons, et ils improvisent. Traitez-les en conséquence : partez du principe que tout ce qui se trouve dans leur contexte est public, vérifiez ce qui circule réellement sur le réseau, et construisez la cage avant d'en avoir besoin, pas après que le spam, adressé à votre nom, est arrivé.


