Privacidad en agentes de código IA: 5 mitos, desmontados
Tu agente de código con IA envía peticiones HTTP que nunca aprobaste, a veces con tu email en el User-Agent. Cinco mitos sobre privacidad, probados.
 Priya Sharma
Decenas de correos de estafa al día, personalizados con tu nombre y apellido reales. Y la filtración no es una base de datos hackeada ni una lista de marketing filtrada. Es la cabecera User-Agent que tu agente de código con IA adjuntaba a peticiones web que nunca aprobaste conscientemente. Eso es lo que descubrieron unos desarrolladores cuando rastrearon una oleada de spam hasta Claude Code, que estaba estampando las direcciones de email de las cuentas de los usuarios en las peticiones HTTP salientes durante las descargas y búsquedas web. La explicación de Anthropic es casi peor que el fallo: habían inyectado el email de la cuenta en el contexto del modelo para que pudiera escribir etiquetas @author sensatas, y el modelo, siendo un bot servicial y buen ciudadano, empezó a ofrecerlo a cualquier web que pidiera un contacto. Llevo años auditando el comportamiento de red de herramientas que se ejecutan en máquinas de desarrolladores, y este incidente es un caso didáctico casi perfecto. Así que repasemos las cinco creencias que más escucho sobre la privacidad de las herramientas agénticas y probemos cada una contra lo que realmente ocurrió.
Mito 1: «Mi agente de código solo habla con la API del proveedor del modelo»
Es el modelo mental con el que casi todo el mundo empieza: el agente es una tubería sofisticada entre tu terminal y los servidores de Anthropic (o de OpenAI, o de quien sea). Entra tu código, salen tokens, y el único endpoint de red que importa es api.anthropic.com.
No es así. Un CLI agéntico moderno es un cliente HTTP de propósito general que casualmente lo maneja un modelo de lenguaje. Tiene una herramienta WebFetch que descarga URLs arbitrarias. Tiene una herramienta WebSearch que consulta infraestructura de búsqueda. Tiene una herramienta Bash, lo que significa curl, wget, pip install, npm install, git clone y cualquier otro binario con capacidad de red de tu sistema. Cuando decide que necesita documentación, un paquete, un changelog o un informe de la SEC, va y lo busca, en el sitio donde cree que está. Cada una de esas peticiones sale de tu dirección IP, desde tu red corporativa, con las cabeceras que el modelo decidió escribir esa mañana.
Y el modelo puede ser creativo. Tras estallar la historia del email, un ingeniero revisó los logs de su propio servidor web y encontró peticiones de subagentes con cadenas User-Agent como company-helm-research/1.0 (Claude Code agent run by [name], [company] platform team; docs lookup), con el nombre de su empresa y el repositorio de GitHub en el que estaban trabajando. El agente no estaba filtrando un valor de configuración; estaba componiendo cabeceras identificativas a partir del contexto, igual que un becario servicial firmaría con nombre completo, equipo y proyecto en cada correo en frío. Si quieres una visión más profunda de por qué la arquitectura lo facilita tanto, hemos escrito sobre cómo se construyen los CLIs de código agénticos. La versión corta es que el bucle, el contexto y el conjunto de herramientas son exactamente tan potentes como hace falta para causar problemas.
El modelo mental correcto: tu agente es un empleado junior con un portátil de empresa, una conexión a la red corporativa y un montón de tus tarjetas de visita. Cualquier cosa que esté en su contexto puede salir del edificio por cualquier herramienta que tenga.
Mito 2: «Poner un email de contacto en el User-Agent es simplemente buena educación entre bots»
Este tiene un fondo de verdad, y por eso es peligroso. Existe una convención genuina según la cual los rastreadores bien portados se identifican y facilitan un contacto. Algunos servicios la exigen con firmeza. La API EDGAR de la SEC, por ejemplo, rechaza sin más las peticiones con un User-Agent genérico de curl y exige un contacto declarado. Puedes comprobarlo tú mismo en diez segundos:
U='https://data.sec.gov/api/xbrl/companyconcept/CIK0000320193/us-gaap/Assets.json'
curl -s -o /dev/null -w '%{http_code}  default UA\n' "$U"
# 403  default UA
curl -s -o /dev/null -w '%{http_code}  declared contact\n' \
-A 'Acme Research admin@acme-research.example' "$U"
# 200  declared contact
Así que un modelo que ha aprendido que «algunas APIs quieren una dirección de contacto en el User-Agent» no está alucinando: está reconociendo patrones de la etiqueta real de internet. Y si ese modelo tiene tu email de cuenta en su contexto, tiene exactamente una dirección de contacto disponible para ofrecer. El ingeniero de Anthropic que explicó el incidente lo dijo claramente: algunas webs piden a los agentes un contacto, y Claude a veces daba el email que tenía.
Aquí es donde el mito se rompe. La convención dice que el operador del bot aporta su propio contacto: la entidad que ejecuta el rastreador, para que un administrador de sistemas molesto pueda llegar a alguien responsable. El rastreador de Anthropic se identifica como Anthropic. El de Google, como Google. Pero cuando tu agente descarga una página, el contacto del operador debería ser la URL de soporte del proveedor de la herramienta o una dirección que tú hayas configurado deliberadamente, no el email personal que usaste para pagar la suscripción. La guía de la RFC 9110 sobre User-Agent desaconseja explícitamente la información identificativa innecesariamente detallada, y todos los ingenieros de privacidad que conozco consideran los datos personales no solicitados en cabeceras de petición un defecto, sin más. La etiqueta para bots nunca pretendió desanonimizar a la persona que está detrás del bot.
Y el alcance del daño es real, no teórico. Webs de terceros arbitrarias, incluidos los rincones infestados de estafas de la web que un agente de búsqueda tocará inevitablemente, ahora tienen una dirección de email verificada y asociada al nombre de un ingeniero de software en activo. Eso es una semilla perfecta para spear-phishing, entregada envuelta para regalo. Varios desarrolladores rastrearon una avalancha repentina de spam personalizado directamente hasta este comportamiento. «Buena ciudadanía de bots» que te expone a spammers no es ni buena ni ciudadanía.
Mito 3: «Los diálogos de permisos y el sandbox mantienen mi identidad contenida»
Toda herramienta agéntica incluye algún tipo de UX de consentimiento: el agente pregunta antes de ejecutar comandos, te muestra qué archivos lee, quizá limita el acceso web con una aprobación por dominio. Esto crea una impresión poderosa: un desarrollador lo describió como la sensación de que «el LLM solo tiene acceso a lo que se haya añadido explícitamente a un proyecto». Esa impresión es falsa, y el incidente del email lo demuestra por partida doble.
Primero, los sistemas de permisos controlan qué herramientas se ejecutan, no lo que el modelo escribe dentro de las peticiones que esas herramientas hacen. Aprobar «sí, descarga esta URL» no te dice nada sobre las cabeceras que el modelo compuso para esa descarga. Aprobar una llamada a Bash que ejecuta curl te dice todavía menos: la cadena de comando pasa volando y nadie lee el flag -A. Segundo, la interfaz de permisos opera por acción, mientras que la fuga es una propiedad del contexto. Una vez que tu email de cuenta se inyectó en el contexto del sistema (algo que los usuarios nunca vieron ni pudieron desactivar), quedó disponible para cada llamada a herramienta, cada subagente y cada one-liner de curl, durante toda la sesión. El perímetro del sandbox se trazó alrededor del sistema de archivos, y la vía de exfiltración fue la propia generación de texto del modelo.
Esta es la parte en la que quiero ser directo, porque generaliza mucho más allá del fallo de un proveedor: cualquier cosa en el contexto de un agente está a una instrucción plausible de salir de tu máquina. Claves de API, nombres de host internos, contenido de archivos, tu nombre, tu empresa, tu email. El control en la capa de herramientas no ayuda cuando el propio modelo es el canal de exfiltración; por eso he defendido antes que la contención y la monitorización resuelven problemas distintos para los agentes de IA, y necesitas saber cuál de las dos estás obteniendo. Un diálogo de permisos es monitorización disfrazada de control. Te muestra la acción; no puede mostrarte la intención codificada en los parámetros de la acción.
Veredicto: el sandbox, tal como se distribuyó, contuvo tus archivos. No hizo nada por tu identidad, porque tu identidad se le entregó al modelo como materia prima.
Mito 4: «Es una opción: cambia el interruptor y estás a salvo»
Cuando el asunto estalló, la exigencia del reportero original fue concreta: esto no debería ser una opción de exclusión voluntaria, debería eliminarse del arnés por completo. Ese instinto es correcto, y la forma en que se aplicó la solución explica por qué los ajustes son la primitiva equivocada para este tipo de problema.
La corrección llegó en dos partes. Primero, un plugin integrado (cc-plugin-privacy, activado por defecto desde la v2.1.317) que bloquea el comportamiento de forma determinista: una comprobación estricta, no una sugerencia al modelo. Segundo, y más importante, Anthropic eliminó por completo el email de la cuenta del contexto del modelo. Fíjate en el orden de importancia. El plugin es un filtro sobre la salida; quitar el email del contexto es eliminar la capacidad. Un filtro puede fallar. Un modelo que nunca conoció tu email no puede filtrarlo, por creativo que sea al componer cabeceras.
No puedes salir de una exposición de datos a base de prompts. Si el modelo puede verlo, el modelo puede emitirlo. La única redacción fiable es la sustracción.
Es un patrón que veo continuamente en herramientas de agentes, y encaja con lo que hemos tratado en la auditoría de clientes de API que funcionan también como bóvedas de credenciales: el material sensible se mete en el lugar más cómodo (el contexto, el entorno, un archivo de configuración) porque una función lo necesitó una vez, y luego viaja con él a todas partes. Los interruptores de telemetría y los ajustes de privacidad atienden a lo que el proveedor decidió recoger. No dicen nada sobre lo que el modelo podría improvisar con el material que le dieron. Los ajustes sirven para preferencias. Los controles deterministas y la minimización de datos sirven para la privacidad. Si un proveedor te ofrece lo primero como solución de lo segundo, exígele más.
Mito 5: «El proveedor lo parcheó, así que puedo dejar de preocuparme»
Hay que reconocer el mérito: la respuesta fue rápida, la explicación técnica fue franca y la solución atacó la causa raíz en lugar del síntoma. Pero «parcheado» es una afirmación sobre un comportamiento concreto en una versión concreta. La clase de problema (herramientas agénticas que emiten material identificativo a endpoints arbitrarios) es estructural, y volverá a aparecer en esta herramienta o en otra. Varios usuarios señalaron que ni siquiera era la primera vez que la identidad de la cuenta aparecía sin invitación en el contexto de Claude Code; era al menos la segunda.
Hay además una verdad más incómoda por debajo: no puedes verificar por completo la ausencia de una fuga desde el lado del cliente. Un usuario diligente ejecutó un proxy man-in-the-middle contra la versión corregida y confirmó que nada identificativo salía de su máquina a través de la herramienta WebFetch. Buen trabajo, y el instinto correcto. Pero, como señaló, la identificación también podría ocurrir en el servidor: tu cliente envía una petición anónima a la API del proveedor, y la infraestructura de ese lado reenvía la información a terceros con tus datos adjuntos. En ese punto, ninguna inspección local de paquetes lo verá. Vuelves a depender de confiar en el proveedor, que es exactamente la posición incómoda que el incidente dejó al descubierto.
Así que la postura duradera no es «parche aplicado, caso cerrado». Es tratar cada herramienta agéntica como un cliente de red permanentemente sospechoso que auditas periódicamente, igual que tratarías cualquier software de terceros con permisos amplios en el portátil de un ingeniero. Y eso nos lleva a la parte práctica.
Cómo auditar tú mismo el tráfico de red de tu agente
Nada de esto requiere un equipo de seguridad. Una tarde y algunas herramientas estándar te dirán más sobre el comportamiento de tu agente que cualquier política de privacidad.
1. Intercepta el tráfico. Apunta el agente a mitmproxy y deja que ejecute una sesión de trabajo real. Los CLIs basados en Node suelen respetar las variables de entorno de proxy una vez que confían en tu CA:
mitmdump --listen-port 8080 -w agent-flows.mitm &
export HTTPS_PROXY=http://127.0.0.1:8080
export NODE_EXTRA_CA_CERTS=~/.mitmproxy/mitmproxy-ca-cert.pem
# Now run your agent and do normal work.
# Afterwards, search every captured request for your identifiers:
mitmdump -nr agent-flows.mitm \
--flows \
| grep -iE 'you@company\.com|YourName|your-org'
Busca algo más que tu email: tu nombre, tu empresa, el slug de tu organización en GitHub, nombres de host internos, nombres de repositorios. Recuerda los logs de los subagentes: el modelo no solo repetía identificadores, los componía, así que busca fragmentos.
2. Revisa los logs de tu propia infraestructura. Si operas servicios web, busca en sus logs de acceso cadenas User-Agent de agentes. Así se descubrieron las cabeceras compuestas del Mito 1. No te cuesta nada y a menudo saca a la luz tráfico de subagentes que la captura local se pierde.
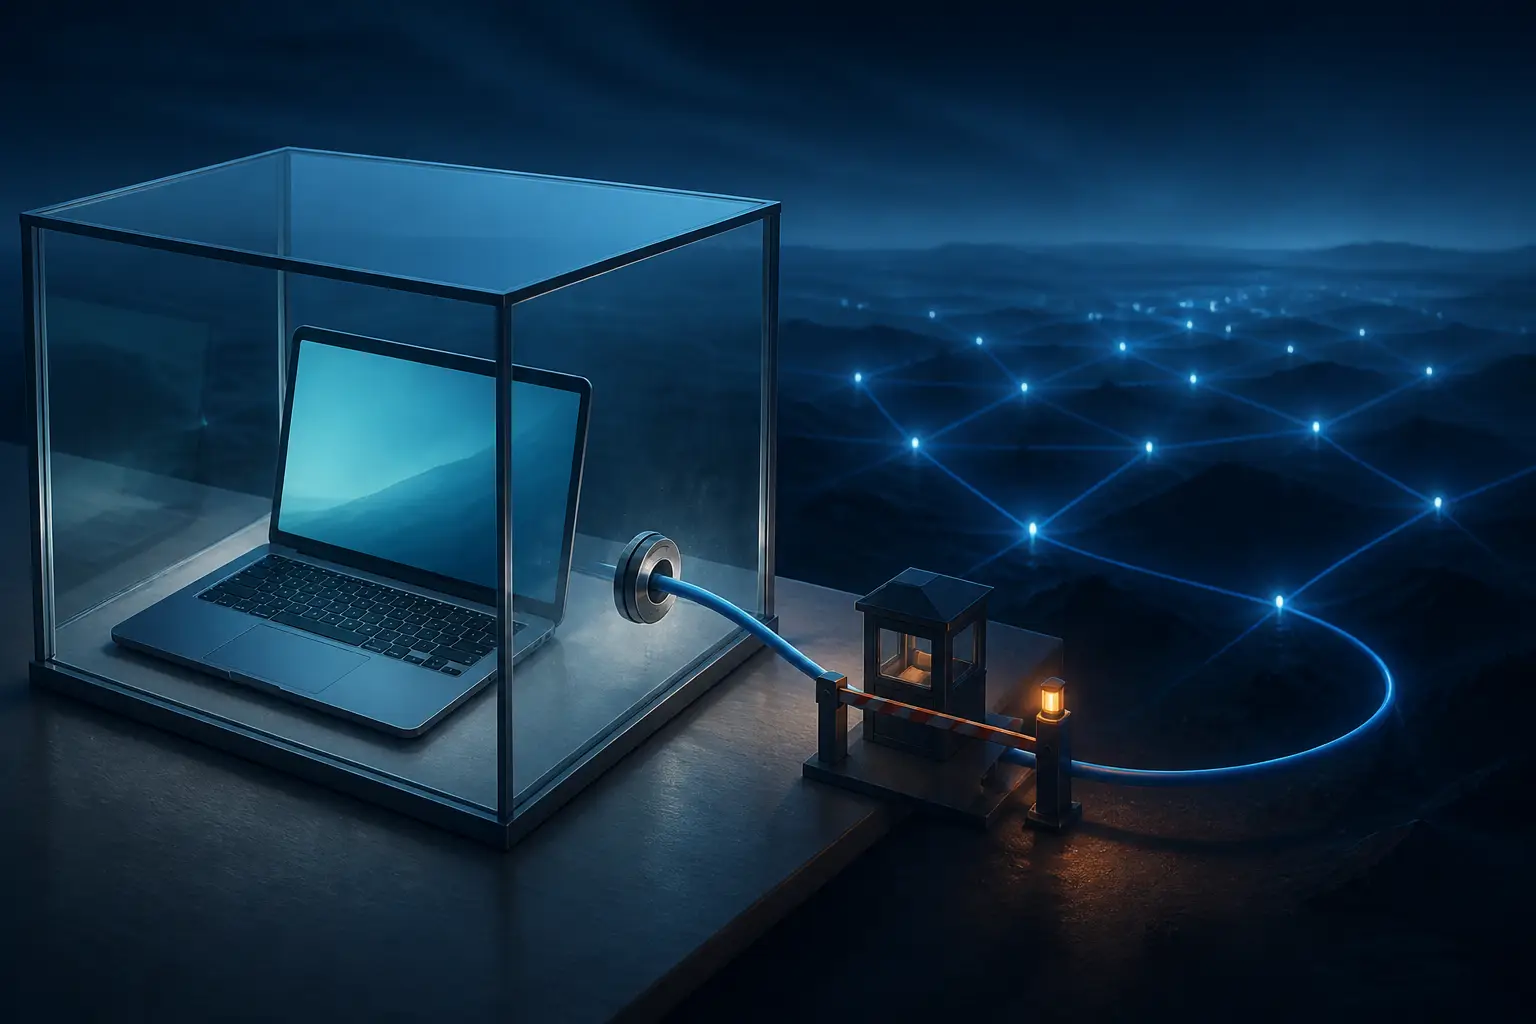
3. Restringe la salida. El control más fuerte es hacer imposibles categorías enteras de fuga. Ejecuta el agente dentro de un contenedor o una VM cuya política de red solo permita los endpoints que necesita legítimamente: la API del modelo, tus registros de paquetes, quizá GitHub. Con Docker, eso significa una red personalizada más un cortafuegos de salida; en un Mac, Little Snitch o Lulu te dan reglas por proceso. Si el agente no puede llegar a webs arbitrarias desde su sandbox, tampoco puede entregar tu identidad a webs arbitrarias: tendrá que pedirte que descargues cosas, lo cual es fricción, pero la fricción es precisamente el objetivo.
4. Minimiza lo que la herramienta sabe. Usa un email dedicado y de bajo valor para las cuentas de herramientas, no tu dirección de trabajo principal. Elimina los detalles identificativos de los archivos de configuración globales que lee el agente (~/.gitconfig es un caso habitual que los agentes leen). Si la herramienta lo permite, ejecútala con un usuario de sistema operativo aparte y su propio directorio personal. La sustracción gana a la filtración, siempre.
5. A nivel de organización, pasa por un proxy gestionado. Si tu empresa entrega herramientas agénticas a sus ingenieros, obliga a que su tráfico pase por un proxy de salida con registro, y añade inspección de cabeceras al pipeline. Los logs de consultas DNS por sí solos habrían detectado el patrón de un agente que se dispersa hacia cientos de dominios poco habituales. Es la misma postura que aplicarías a cualquier runner de CI o máquina de build, y es el marco exacto: un agente es infraestructura de build con opiniones propias.
El fallo del email en el User-Agent se olvidará en un mes, absorbido por el ritmo de las notas de versión. La lección no debería olvidarse. Las herramientas de código agénticas son el software más privilegiado, más activo en red y menos auditado que la mayoría ejecutamos, y además improvisan. Trátalas en consecuencia: asume que todo lo que hay en su contexto es público, verifica qué sale realmente por el cable y construye la jaula antes de necesitarla, no después de que llegue el spam dirigido a ti por tu nombre.


