Códigos ZIP: límites ZCTA vs USPS y cuándo usar cada uno
USPS ya vende límites oficiales de códigos ZIP, pero nunca fueron polígonos. ZCTA vs USPS: cuándo gana cada uno en geocodificación en producción.
 Sarah Chen
Tu pipeline de geocodificación tiene un bug silencioso: una dirección en una urbanización recién construida se geocodifica bien, pero cae en el hueco entre dos polígonos de ZCTA y devuelve una región nula. Aguas abajo, tu modelo de costes de entrega la promedia silenciosamente en el mercado equivocado. Esta es la realidad cotidiana de trabajar con límites de códigos ZIP, un concepto que, hasta hace poco, ni siquiera existía oficialmente. USPS ha empezado a vender polígonos oficiales de códigos ZIP a través de su portal PostalPro, y el mundo de la ingeniería de datos está dividido entre el entusiasmo y el susto por el precio. Esto es lo que realmente cambió y cómo decidir qué datos de límites deben entrar en tu pipeline.
Llevo años construyendo pipelines de matching y enriquecimiento sobre datos de direcciones de EE. UU., y mi opinión firme es esta: la mayoría de equipos trata los ZIP como geografía porque la Oficina del Censo se lo puso fácil, no porque sea correcto. El nuevo producto de USPS no cambia ese cálculo para todos, pero sí zanja por fin una discusión que llevamos décadas teniendo.
Los códigos ZIP nunca fueron polígonos (y tampoco lo son ahora)
El hecho fundamental que rompe la intuición de todos: un código ZIP es un atributo de una ruta de reparto, no una región de terreno. USPS creó los ZIP en 1963 para que el correo correcto llegara al camión correcto. Un ZIP es un conjunto de rutas de cartero ancladas a una unidad de reparto: una oficina de correos, un centro de clasificación o, a veces, un solo edificio. Los grandes destinatarios, como agencias gubernamentales y universidades, tienen ZIP propios que cubren una sola dirección. Los ZIP solo de apartado postal cubren una pared de buzones dentro de un edificio y cero hectáreas de terreno.
Esto tiene consecuencias que el pensamiento en polígonos no puede asimilar. Imagina que un desarrollador construye un barrio nuevo en un terreno vacío entre dos pueblos. Si los ZIP fueran polígonos, mirarías en qué polígono cae el terreno y ese sería tu ZIP. La realidad: USPS lo asigna a la ruta que tenga más sentido logístico, que puede ser cualquiera de los dos pueblos, o un ZIP nuevo recortado de ambos. El límite no existe hasta que existe la ruta. Por eso la propia documentación de USPS dice que su nuevo producto de límites tiene fluctuación temporal: los límites cambian a medida que cambia la distribución del reparto, que es lenguaje burocrático para decir que «las rutas cambian todo el tiempo».
- ZIP de apartado postal y ZIP únicos no tienen área significativa: representan edificios, no terreno.
- Áreas de servicio no contiguas aparecen cuando una misma unidad de reparto atiende bolsillos de direcciones desconectados.
- Huecos rurales existen donde USPS directamente no reparte; las direcciones allí se asignan de forma inconsistente, a veces a varios ZIP candidatos en distintas bases de datos.
- Rotación constante: las nuevas construcciones, la consolidación de rutas y el cierre de oficinas de correos remodelan las rutas subyacentes cada trimestre.
- ZIP+4 reduce hasta una cara de manzana, pero casi nadie lo recoge ni lo almacena, así que rara vez te salva en la práctica.
Compara con el Reino Unido, donde un código postal completo identifica unas diez direcciones: se diseñó desde el principio para señalar un grupo pequeño de puntos de entrega, y se recoge y usa en todas partes. El ZIP estadounidense de cinco dígitos se diseñó para clasificar, y pasamos cincuenta años reutilizándolo como geografía porque era el único identificador geográfico impreso en cada dirección del país.
ZCTA vs límites de USPS: qué es realmente cada conjunto de datos
ZCTA: estadísticas con disfraz de ZIP
Los ZCTA (ZIP Code Tabulation Areas) son la respuesta de la Oficina del Censo al problema del polígono. En cada censo decenal, la Oficina examina cada bloque censal, encuentra el ZIP más común entre las direcciones de ese bloque y agrupa los bloques en ZCTA con el nombre del ZIP dominante. El resultado es un shapefile gratuito y descargable que cubre todo el país sin huecos ni solapamientos.
Este diseño tiene dos propiedades que importan muchísimo en producción. Primero, los ZCTA son áreas estadísticas, diseñadas para agregar datos censales de forma consistente: cada tabla demográfica que publica el Censo a nivel de ZIP es en realidad a nivel de ZCTA. Segundo, son imprecisos: la regla de «gana el ZIP más común» significa que las direcciones minoritarias dentro de un bloque se asignan a un ZCTA que no coincide con el ZIP que escribirían en una carta. En zonas urbanas densas es un error de redondeo. En zonas rurales, con bloques censales enormes y rutas escasas, un ZCTA puede desviarse kilómetros de donde realmente llega el correo de una dirección concreta.
Los nuevos polígonos de USPS: verdad de referencia, a un precio
El producto de USPS se construye desde la otra dirección: datos reales de direcciones de entrega y ubicación, la misma información que dirige los camiones. Eso lo convierte en lo más parecido a una verdad de referencia para la pregunta «¿qué zona considera USPS que cubre este ZIP?». Se actualiza trimestralmente, siguiendo la rotación de rutas que los ZCTA tardan en reflejar. USPS lo vende en tres niveles: Interno, Empresarial (con distribución limitada a filiales y socios) y Publicación (derechos limitados para publicar mapas derivados).
El golpe fue duro para la comunidad: según se informa, el precio parte de unos 10.000 dólares en el nivel más bajo. El enfado es comprensible, porque los mapas de cobertura de la FCC, los límites de tierras federales y la geografía del Censo son gratuitos, y cobrar cinco cifras por geografía postal parece un paso atrás. La razón estructural es que USPS es una agencia autofinanciada que vive sobre todo de los ingresos por franqueo, no de presupuestos del Congreso, y por eso trata los productos de datos como productos. Si es buena política es un debate justo; si debes construir tu pipeline en torno a la realidad de las licencias, no lo es.
Diseñar un pipeline de geocodificación para límites imprecisos
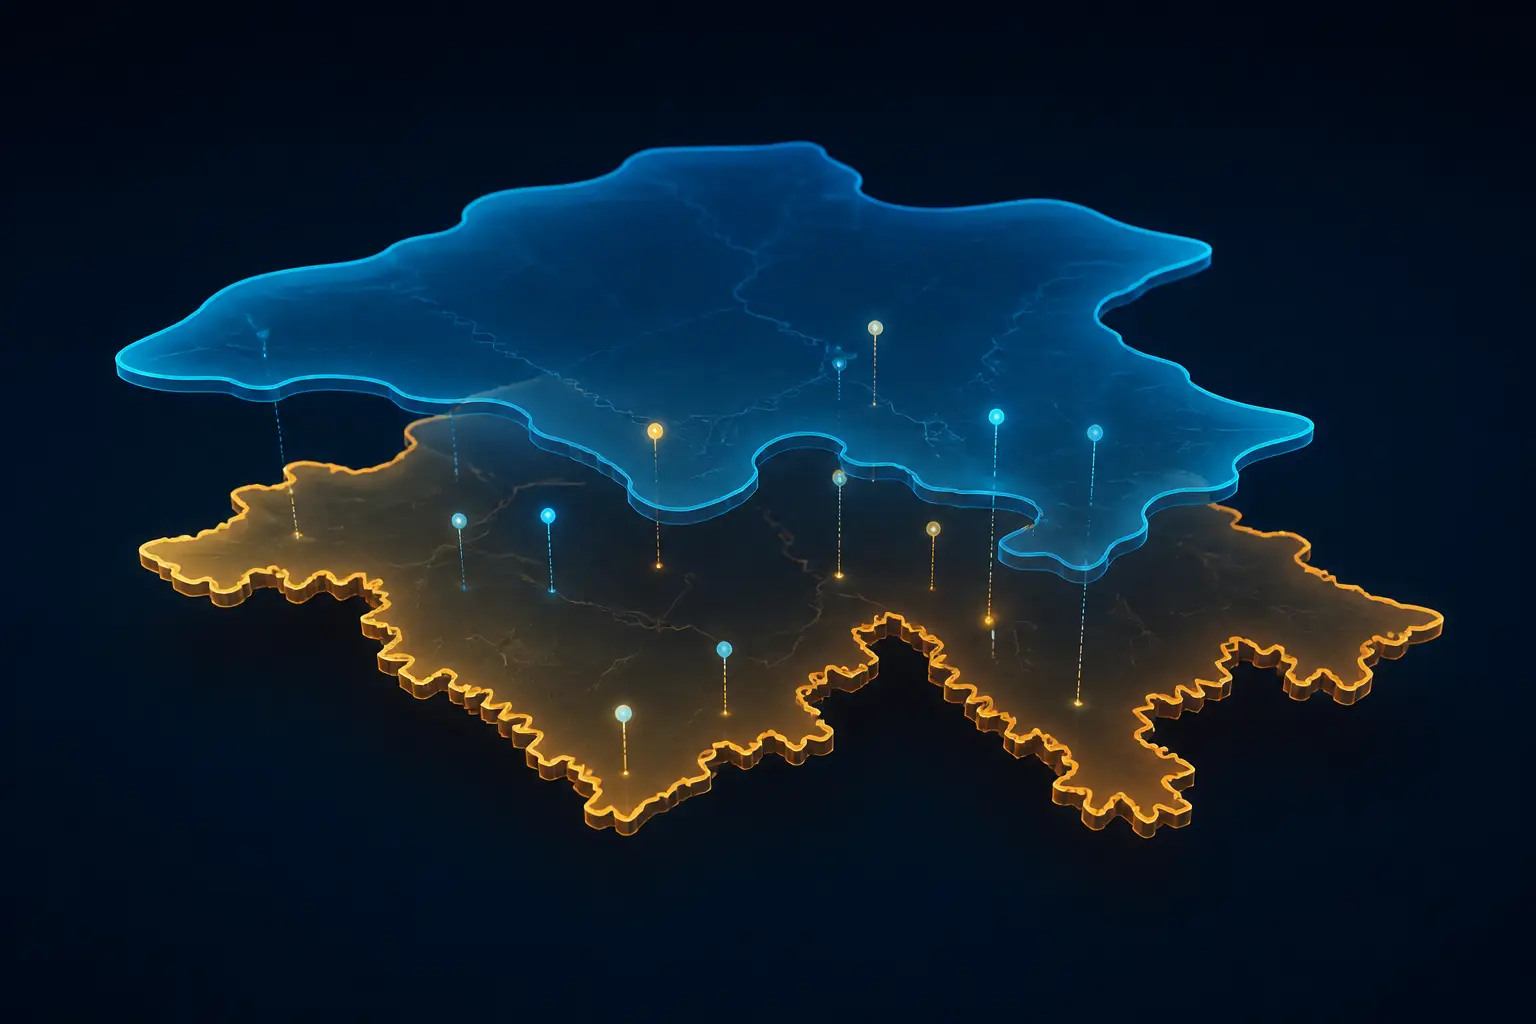
El patrón al que he llegado tras reconstruir este pipeline más de una vez: trata la asignación de ZIP como un join en dos pasadas con un presupuesto de ambigüedad explícito, nunca como una única búsqueda de punto en polígono. La primera pasada es contención estricta; la segunda es un respaldo de vecino más cercano con límite que se registra a sí mismo, así puedes medir con qué frecuencia tus datos discrepan de la geografía. Esto encaja de forma natural con las técnicas de indexación espacial de nuestra comparativa entre geohash e índice espacial: la pasada de respaldo es exactamente el tipo de carga que un R-tree bien hecho abarata.
import geopandas as gpd
# ZCTA boundaries from the Census TIGER/Line shapefiles (free)
zcta = gpd.read_file("tl_2024_us_zcta520.shp")
# Project to a meter-based CRS so distances are meaningful
zcta = zcta.to_crs("EPSG:5070")[["ZCTA5CE20", "geometry"]]
points = gpd.GeoDataFrame(
addresses,
geometry=gpd.points_from_xy(addresses.lon, addresses.lat),
crs="EPSG:4326",
).to_crs("EPSG:5070")
# Pass 1: strict point-in-polygon
matched = gpd.sjoin(points, zcta, how="left", predicate="within")
# Pass 2: unmatched points get the nearest ZCTA, capped at 5 km,
# flagged so downstream consumers know this was an inference
unmatched = matched[matched["ZCTA5CE20"].isna()]
if len(unmatched):
nearest = gpd.sjoin_nearest(
unmatched.drop(columns=["ZCTA5CE20", "index_right"]),
zcta,
how="left",
max_distance=5_000,  # meters, because we projected first
distance_col="fallback_dist_m",
)
matched.loc[nearest.index, "ZCTA5CE20"] = nearest["ZCTA5CE20"]
matched.loc[nearest.index, "zip_inferred"] = True
matched["zip_inferred"] = matched["zip_inferred"].fillna(False)
Tres detalles de ese fragmento te ahorran dolores de producción reales. Proyecta a un CRS basado en metros antes de llamar a sjoin_nearest: pasar max_distance en grados es un error clásico que significa silenciosamente distancias distintas según la latitud. Limita la distancia del respaldo: una dirección a 40 km del borde del ZCTA más cercano no está «dentro» de ese ZCTA, está en un agujero de datos, y quieres un nulo con una marca, no una mentira segura. Y persiste la marca zip_inferred en tu almacén. Cuando un stakeholder pregunte por qué las estimaciones de entrega del tercer trimestre se desviaron en Montana, esa marca es la diferencia entre una respuesta de diez minutos y un proyecto de arqueología de dos semanas.
La higiene operativa importa más que la lógica del join. Fija la versión de tu capa de límites en la configuración del pipeline y regístrala como columna en las filas de salida: cuando cambies de vintage de ZCTA o adoptes la capa de USPS, necesitas saber qué límite produjo cada registro histórico. Programa la reingestión según la frecuencia de actualización de tu fuente (más o menos anual para los ZCTA, trimestral para USPS) y añade un paso de validación que compare recuentos de filas y área total entre versiones; los archivos de límites traen sorpresas de calidad de datos más a menudo de lo que te gustaría. Si disfrutas de este tipo de plomería espacial a gran escala, nuestro artículo sobre convertir un país entero en voxels cubre las mismas lecciones a una escala mucho mayor.
Un nulo con una marca vale más que una mentira segura. El peor código ZIP de tu base de datos es el que parece correcto y no lo es.
Cuándo gana cada fuente de límites de ZIP
La comparación no es ajustada una vez que separas los casos de uso según la pregunta que realmente plantean. «¿En qué ZIP recibe correo esta dirección?» y «¿a qué área estadística pertenece este punto?» suenan idénticas y no lo son.
- Los ZCTA ganan en analítica y cruces demográficos. Si enriqueces registros con datos del Censo (renta mediana, densidad de población, estadísticas de vivienda), los ZCTA no son solo la opción gratuita: son la opción correcta, porque las tablas censales con las que cruzas se publican a nivel de ZCTA.
- Los ZCTA ganan en visualización. Los coropletas, mapas de mercado y dashboards necesitan un teselado sin huecos de todo el país. Una capa de límites con agujeros donde nadie recibe correo parece rota ante un stakeholder, aunque sea precisa.
- Los polígonos de USPS ganan en logística y envíos. Zonas de tarifas de transportistas, enrutamiento de última milla, elegibilidad de área de servicio: cualquier cosa donde la pregunta de negocio sea literalmente «¿qué hará USPS con esta dirección?» merece datos construidos a partir de registros reales de reparto.
- Los polígonos de USPS ganan cuando importan las nuevas construcciones. Las actualizaciones trimestrales siguen la rotación de rutas que deja los ZCTA desactualizados durante años. Si tus clientes construyen en suburbios de rápido crecimiento, esto por sí solo puede justificar la licencia.
- Ninguno gana cuando tienes coordenadas. Si tu caso de uso es «qué hay cerca de este punto», olvídate de los ZIP y haz consultas geoespaciales reales sobre latitud y longitud. La proximidad basada en ZIP es una abstracción con fugas.
Hay también un tercer grupo que merece mención: los proveedores comerciales de límites llevan años vendiendo polígonos de ZIP curados, a menudo con historial de series temporales y tablas de correspondencia con otras geografías. El producto de USPS mina su argumento de verdad de referencia, pero no necesariamente su comodidad. Si ya tienes licencia de uno, la cuestión es si el linaje de registros de reparto de USPS vale la pena de una migración; para la mayoría de cargas analíticas, no lo vale.
La cuestión de la licencia es un callejón sin salida: diseña alrededor de ella
Mucha gente inteligente preguntó si una solicitud FOIA podría liberar estos datos, o si una campaña de crowdfunding podría comprar una licencia y publicar los polígonos. Yo apostaría en contra de ambas. Los niveles de licencia existen precisamente para controlar la redistribución, y un esquema de «comprar una vez, publicar gratis» choca de frente con el propósito entero del nivel de Publicación. Incluso si funcionara, tendrías una instantánea de un conjunto de datos cuyo valor es la frescura trimestral: una fuga estática envejece hasta convertirse en un pasivo a medida que cambian las rutas.
El movimiento pragmático es diseñar para que la capa de límites sea intercambiable. Mantén constantes la lógica del join, el comportamiento de respaldo y los metadatos de versionado; trata la fuente de polígonos como configuración. Así, la actualización de ZCTA a USPS se convierte en una decisión presupuestaria que puedes tomar por línea de producto, no en un proyecto de migración. He visto equipos que codifican supuestos de ZCTA tan a fondo (nombres de tablas, claves de join, filtros de dashboards) que cambiar de fuente costaría más que la licencia que intentaban evitar.
Mi recomendación: por defecto ZCTA, y compra USPS donde compense
Esta es la regla de decisión que daría a cualquier equipo hoy. Por defecto, ZCTA: son gratuitos, teselan el país, coinciden con todas las tablas censales que vas a cruzar y, para analítica, son la opción canónica y no un compromiso. Añade el join en dos pasadas con un respaldo limitado por distancia y que se registra a sí mismo, para que las costuras sean visibles en lugar de silenciosas.
Compra los polígonos de USPS solo cuando la pregunta de negocio trate sobre el reparto de correo en sí: modelado de costes de envío, enrutamiento de transportistas, elegibilidad de área de servicio, y cuantifica primero el valor. Mide qué fracción de tus direcciones cae en zonas de discrepancia ZCTA/USPS (según mi experiencia, a nivel nacional es de un dígito bajo en porcentaje, pero se concentra justo en las zonas de rápido crecimiento y rurales, donde los errores cuestan más). Si esa porción impulsa ingresos o riesgo significativos, la licencia se paga sola; si no, estarás comprando precisión que tu producto no puede percibir.
Y elijas lo que elijas, deja de fingir que los ZIP son geografía. Son rutas de reparto con disfraz de polígono, y los nuevos límites oficiales no cambian eso: solo lo visten mejor. Diseña tu pipeline para tolerar las costuras, registra los lugares donde el mapa y el correo no coinciden, y llevarás ventaja a la mayoría de la industria, que sigue haciendo búsquedas de punto en polígono a secas y preguntándose de dónde salen los nulos.