Confini ZIP Code: ZCTA vs USPS, quando conviene ciascuno
USPS vende ora i confini ufficiali dei ZIP code, ma non sono mai stati poligoni. ZCTA vs USPS: quando conviene ciascuno nelle pipeline di geocoding.
 Sarah Chen
La tua pipeline di geocoding ha un bug silenzioso: un indirizzo in un nuovo quartiere viene geocodificato correttamente, poi cade nello spazio tra due poligoni ZCTA e restituisce una regione nulla. A valle, il tuo modello dei costi di consegna lo infila silenziosamente nel mercato sbagliato. Questa è la realtà quotidiana di lavorare con i confini dei codici ZIP, un concetto che, fino a poco tempo fa, non esisteva ufficialmente. USPS ha iniziato a vendere poligoni ufficiali dei confini dei codici ZIP attraverso il portale PostalPro, e il mondo della data engineering è diviso tra entusiasmo e shock per il prezzo. Ecco cosa è cambiato davvero e come decidere quali dati sui confini far entrare nella tua pipeline.
Lavoro da anni su pipeline di matching e arricchimento basate sui dati degli indirizzi statunitensi, e la mia opinione forte è questa: la maggior parte dei team tratta gli ZIP come geografia perché il Census Bureau ha reso le cose facili, non perché sia corretto. Il nuovo prodotto USPS non cambia questo calcolo per tutti, ma chiude finalmente una discussione che va avanti da decenni.
I codici ZIP non sono mai stati poligoni (e non lo sono ancora)
Il fatto di base che manda in crisi l'intuizione di tutti: un codice ZIP è un attributo di un percorso di consegna, non una regione di terreno. USPS ha creato gli ZIP nel 1963 per far arrivare la posta giusta sul camion giusto. Uno ZIP è un insieme di percorsi dei portalettere ancorati a un'unità di consegna: un ufficio postale, un centro di smistamento, a volte un singolo edificio. I grandi destinatari, come agenzie governative e università, hanno ZIP dedicati che coprono un solo indirizzo. Gli ZIP riservati alle sole caselle postali coprono una parete di cassette all'interno di un edificio e zero ettari di terreno.
Questo ha conseguenze che il pensiero per poligoni non riesce ad assorbire. Immagina che uno sviluppatore costruisca un nuovo quartiere su un terreno libero tra due paesi. Se gli ZIP fossero poligoni, cercheresti in quale poligono ricade il terreno e quello sarebbe il tuo ZIP. In realtà USPS lo assegna al percorso che ha più senso dal punto di vista logistico, che potrebbe essere uno dei due paesi, oppure un ZIP nuovo ricavato da entrambi. Il confine non esiste finché non esiste il percorso. È anche per questo che la documentazione di USPS dice che il loro nuovo prodotto sui confini presenta fluttuazioni temporali: i confini cambiano man mano che cambia la distribuzione delle consegne, che è un modo burocratico per dire che «i percorsi cambiano continuamente».
- Gli ZIP delle caselle postali e quelli unici non hanno alcuna area significativa: rappresentano edifici, non terreni.
- Le aree di servizio non contigue si verificano quando una stessa unità di consegna serve sacche disconnesse di indirizzi.
- I vuoti rurali esistono dove USPS non consegna affatto; gli indirizzi lì vengono assegnati in modo incoerente, a volte a più ZIP candidati in database diversi.
- Ricambio costante: nuove costruzioni, consolidamento dei percorsi e chiusura degli uffici postali rimodellano i percorsi sottostanti ogni trimestre.
- Lo ZIP+4 restringe fino al lato di un isolato, ma quasi nessuno lo raccoglie o lo archivia, quindi raramente ti salva nella pratica.
Confronta con il Regno Unito, dove un codice postale completo identifica circa dieci indirizzi: è stato progettato fin dall'inizio per individuare un piccolo gruppo di punti di consegna, ed è raccolto e usato ovunque. Il codice ZIP statunitense a cinque cifre è stato progettato per lo smistamento, e per cinquant'anni lo abbiamo riutilizzato come dato geografico perché era l'unico identificativo geografico stampato su ogni indirizzo del paese.
ZCTA vs confini USPS: cos'è davvero ciascun dataset
ZCTA: statistiche travestite da ZIP
Gli ZIP Code Tabulation Areas sono la risposta del Census Bureau al problema dei poligoni. Per ogni censimento decennale, il Bureau esamina ogni blocco censuario, trova lo ZIP più frequente tra gli indirizzi del blocco e raggruppa i blocchi in ZCTA, chiamate come lo ZIP dominante. Il risultato è uno shapefile gratuito e scaricabile che copre l'intero paese senza buchi e senza sovrapposizioni.
Questo design ha due proprietà molto importanti in produzione. Primo, le ZCTA sono aree statistiche, costruite per aggregare in modo coerente i dati del censimento: ogni tabella demografica che il Census pubblica a livello di ZIP è in realtà a livello di ZCTA. Secondo, sono lossy: la regola «vince lo ZIP più comune» fa sì che gli indirizzi minoritari all'interno di un blocco vengano assegnati a una ZCTA che non corrisponde allo ZIP che scriveresti su una lettera. Nelle aree urbane dense è un errore di arrotondamento. Nelle aree rurali, con blocchi censuari enormi e percorsi radi, una ZCTA può distare chilometri da dove un dato indirizzo riceve realmente la posta.
I nuovi poligoni USPS: verità di terreno, a un prezzo
Il prodotto USPS nasce dalla direzione opposta: dati reali su indirizzi di consegna e localizzazioni, le stesse informazioni che guidano i camion. Questo lo rende la cosa più vicina alla verità di terreno per la domanda «dove USPS considera che questo ZIP copra?». Viene aggiornato trimestralmente, seguendo il ricambio dei percorsi che le ZCTA inseguono con anni di ritardo. USPS lo vende in tre livelli: Internal, Enterprise (con distribuzione limitata a controllate e partner) e Publication (diritti limitati alla pubblicazione di mappe derivate).
Il problema ha colpito duramente la comunità: il prezzo parte, a quanto si riferisce, da circa 10.000 dollari per il livello più basso. La rabbia è comprensibile: le mappe di copertura della FCC, i confini delle terre federali e la geografia del Census sono tutti gratuiti, quindi far pagare cifre a cinque zeri per la geografia postale sembra un passo indietro. La ragione strutturale è che USPS è un'agenzia autofinanziata che vive in gran parte dei ricavi delle affrancature, non dei fondi del Congresso, e quindi tratta i dati come prodotti. Se sia una buona politica è un dibattito legittimo; se tu debba costruire la pipeline attorno alla realtà delle licenze, non lo è.
Progettare una pipeline di geocoding per confini imprecisi
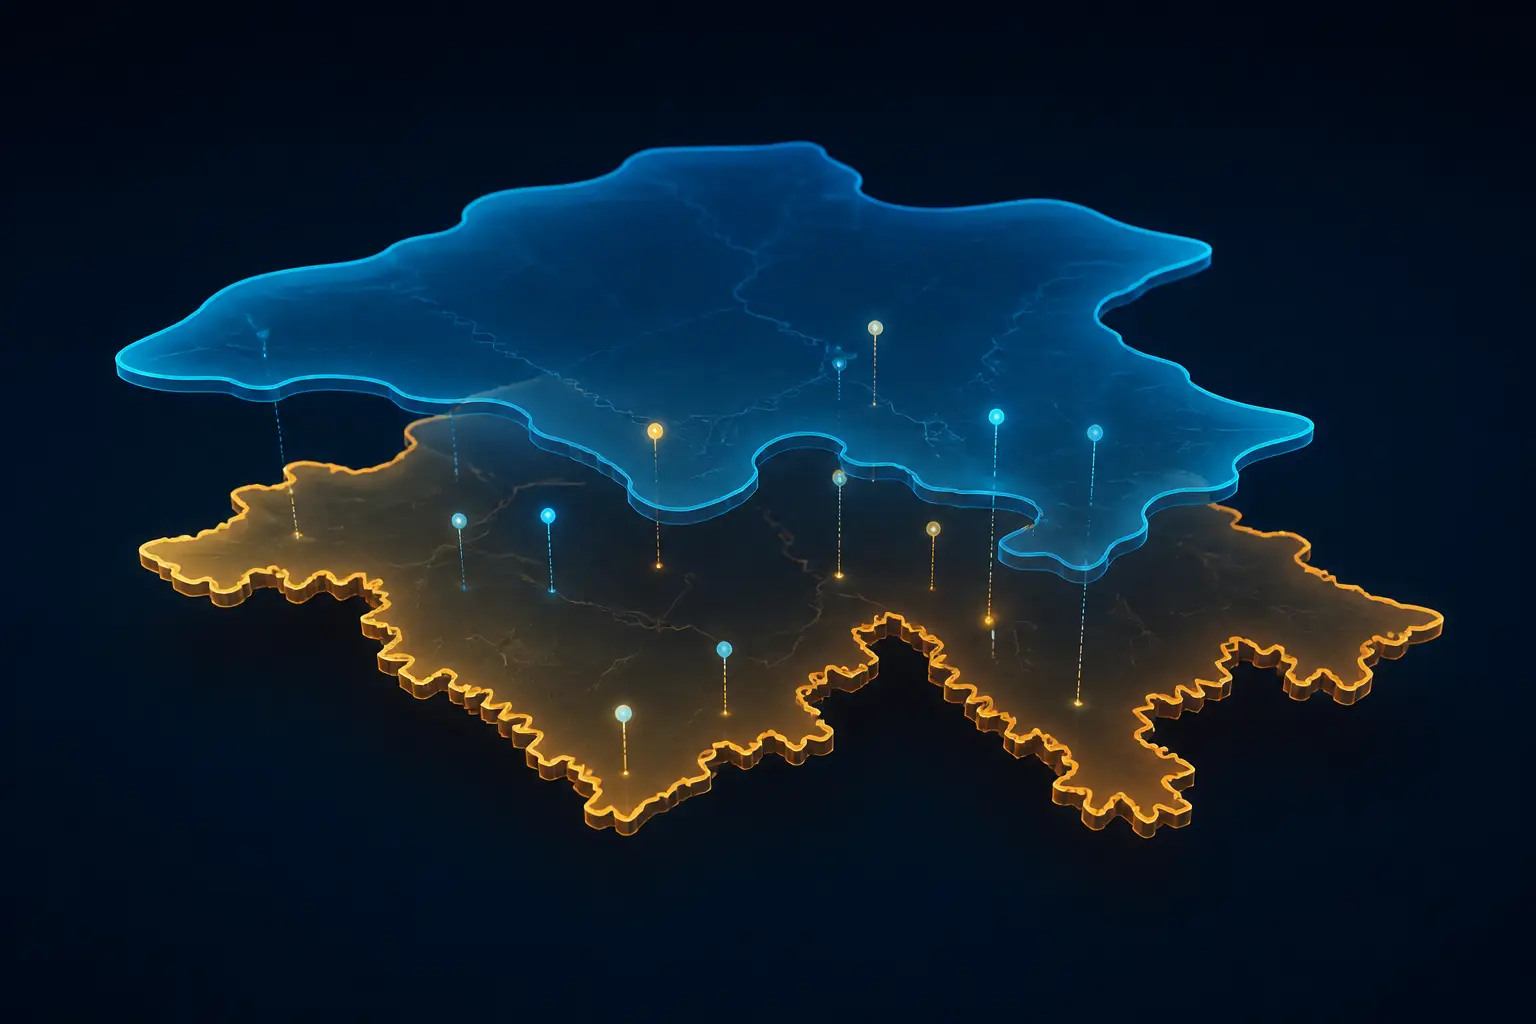
Questo è lo schema a cui sono arrivato dopo aver ricostruito questa pipeline più di una volta: tratta l'assegnazione dello ZIP come un join in due passaggi con un budget di ambiguità esplicito, mai come una semplice ricerca point-in-polygon. Il primo passaggio è un'inclusione stretta; il secondo è un fallback di nearest-neighbor con limite che registra da solo quello che fa, così puoi misurare quanto spesso i tuoi dati non concordano con la geografia. Si abbina bene con i trucchi di indicizzazione spaziale del nostro articolo sul confronto tra geohash e indice spaziale: il passaggio di fallback è esattamente il tipo di carico di lavoro che un buon R-tree rende economico.
import geopandas as gpd
# ZCTA boundaries from the Census TIGER/Line shapefiles (free)
zcta = gpd.read_file("tl_2024_us_zcta520.shp")
# Project to a meter-based CRS so distances are meaningful
zcta = zcta.to_crs("EPSG:5070")[["ZCTA5CE20", "geometry"]]
points = gpd.GeoDataFrame(
addresses,
geometry=gpd.points_from_xy(addresses.lon, addresses.lat),
crs="EPSG:4326",
).to_crs("EPSG:5070")
# Pass 1: strict point-in-polygon
matched = gpd.sjoin(points, zcta, how="left", predicate="within")
# Pass 2: unmatched points get the nearest ZCTA, capped at 5 km,
# flagged so downstream consumers know this was an inference
unmatched = matched[matched["ZCTA5CE20"].isna()]
if len(unmatched):
nearest = gpd.sjoin_nearest(
unmatched.drop(columns=["ZCTA5CE20", "index_right"]),
zcta,
how="left",
max_distance=5_000,  # meters, because we projected first
distance_col="fallback_dist_m",
)
matched.loc[nearest.index, "ZCTA5CE20"] = nearest["ZCTA5CE20"]
matched.loc[nearest.index, "zip_inferred"] = True
matched["zip_inferred"] = matched["zip_inferred"].fillna(False)
Tre dettagli in quello snippet ti risparmiano dolori reali in produzione. Proietta in un CRS basato su metri prima di chiamare sjoin_nearest: passare max_distance in gradi è un classico bug che significa silenziosamente distanze diverse a latitudini diverse. Limita la distanza del fallback: un indirizzo a 40 km dal bordo della ZCTA più vicina non è «dentro» quella ZCTA, si trova in un buco nei dati, e ti serve un null con un flag, non una bugia sicura di sé. E salva il flag zip_inferred nel tuo data warehouse. Quando un stakeholder chiede perché le stime di consegna del terzo trimestre sono scivolate nel Montana, quel flag fa la differenza tra una risposta di dieci minuti e un progetto di archeologia di due settimane.
L'igiene operativa conta più della logica del join. Fissa la versione del layer dei confini nella configurazione della pipeline e registrala come colonna nelle righe di output: quando cambi vintage delle ZCTA o adotti il layer USPS, devi sapere quale confine ha prodotto ogni record storico. Pianifica la re-ingestione in base alla cadenza di aggiornamento della fonte (più o meno annuale per le ZCTA, trimestrale per USPS) e aggiungi un passaggio di validazione che confronti il numero di righe e l'area totale tra le versioni: i file dei confini riservano sorprese di qualità dei dati più spesso di quanto si spererebbe. Se ti piace questo genere di plumbing spaziale su larga scala, il nostro articolo su come trasformare un intero paese in voxel copre le stesse lezioni su una scala molto più grande.
Un null con un flag batte una bugia sicura di sé. Il peggior codice ZIP nel tuo database è quello che sembra corretto e non lo è.
Quando vince ciascuna fonte di confini ZIP
Il confronto non è affatto equilibrato, una volta separati i casi d'uso in base alla domanda che stanno davvero ponendo. «A quale ZIP viene recapitata la posta di questo indirizzo?» e «a quale area statistica appartiene questo punto?» sembrano identiche e non lo sono.
- Le ZCTA vincono per analytics e join demografici. Se arricchisci i record con dati del censimento (reddito mediano, densità di popolazione, statistiche abitative), le ZCTA non sono solo l'opzione gratuita: sono l'opzione corretta, perché le tabelle del censimento a cui ti agganci sono pubblicate a livello di ZCTA.
- Le ZCTA vincono per la visualizzazione. Choropleth, mappe di mercato e dashboard richiedono una copertura senza buchi dell'intero paese. Un layer di confini con vuoti dove nessuno riceve posta sembra rotto agli occhi di uno stakeholder, anche quando è accurato.
- I poligoni USPS vincono per logistica e spedizioni. Zone tariffarie dei corrieri, instradamento dell'ultimo miglio, idoneità all'area di servizio: tutto ciò in cui la domanda di business è letteralmente «cosa farà USPS con questo indirizzo?» merita dati costruiti dai record di consegna reali.
- I poligoni USPS vincono quando contano le nuove costruzioni. Gli aggiornamenti trimestrali seguono il ricambio dei percorsi che lascia le ZCTA obsolete per anni. Se i tuoi clienti costruiscono nelle periferie in forte crescita, questo da solo può giustificare la licenza.
- Nessuna delle due vince quando hai le coordinate. Se il tuo caso d'uso è «cosa c'è vicino a questo punto», salta del tutto gli ZIP e fai query geospaziali reali su lat/lon. La prossimità basata sugli ZIP è un'astrazione che perde.
C'è anche una terza categoria che vale la pena nominare: i fornitori commerciali di confini vendono da anni poligoni ZIP curati, spesso insieme a storico delle serie temporali e crosswalk verso altre geografie. Il prodotto USPS intacca la loro pretesa di verità di terreno, ma non necessariamente la loro comodità. Se ne hai già uno in licenza, la questione è se la genealogia dei record di consegna di USPS valga una migrazione: per la maggior parte dei carichi di lavoro analitici, no.
La questione delle licenze è un vicolo cieco: progetta aggirandola
Molte persone intelligenti si sono chieste se una richiesta FOIA potesse liberare questi dati, o se una campagna di crowdfunding potesse comprare una licenza e pubblicare i poligoni. Scommetterei contro entrambe le ipotesi. I livelli di licenza esistono proprio per controllare la ridistribuzione, e uno schema «compra una volta, pubblica gratis» si scontra frontalmente con lo scopo stesso del livello Publication. Anche se funzionasse, avresti una fotografia di un dataset il cui valore sta nell'aggiornamento trimestrale: una copia statica invecchia e diventa una passività man mano che i percorsi cambiano.
La mossa pragmatica è architettare il sistema in modo che il layer dei confini sia sostituibile. Mantieni costanti la logica del join, il comportamento del fallback e i metadati di versioning; tratta la sorgente dei poligoni come configurazione. Così il passaggio da ZCTA a USPS diventa una decisione di budget che puoi prendere linea di prodotto per linea di prodotto, non un progetto di migrazione. Ho visto team che codificano le ipotesi sulle ZCTA così in profondità (nomi di tabelle, chiavi di join, filtri delle dashboard) che cambiare fonte costerebbe più della licenza che stanno cercando di evitare.
La mia raccomandazione: di default ZCTA, compra USPS dove ripaga
Ecco la regola decisionale che consegnerei oggi a qualsiasi team. Di default usa le ZCTA: sono gratuite, coprono il paese, si agganciano a ogni tabella del censimento che ti capiterà mai di unire e, per l'analisi, sono la scelta canonica più che un compromesso. Aggiungi il join in due passaggi con un fallback a distanza limitata e auto-registrante, così le giunture sono visibili invece che silenziose.
Compra i poligoni USPS solo quando la domanda di business riguarda la consegna della posta in sé: modellazione dei costi di spedizione, instradamento dei corrieri, idoneità all'area di servizio, e quantifica prima il valore. Misura quale frazione dei tuoi indirizzi cade nelle zone di disaccordo ZCTA/USPS (per la mia esperienza è una percentuale bassa a una cifra a livello nazionale, ma concentrata proprio nelle aree rurali e in forte crescita, dove gli errori costano di più). Se quella fetta genera ricavi o rischi significativi, la licenza si ripaga; se no, stai comprando una precisione che il tuo prodotto non percepisce.
E qualunque cosa tu scelga, smetti di fingere che gli ZIP siano geografia. Sono percorsi di consegna travestiti da poligoni, e i nuovi confini ufficiali non cambiano questo: li rendono solo più ben cuciti. Costruisci la pipeline in modo che tolleri le giunture, registra i punti in cui la mappa e la posta non concordano, e sarai avanti rispetto alla maggior parte del settore, che fa ancora semplici ricerche point-in-polygon chiedendosi da dove arrivino i null.