Modelli del mondo vs predizione video: cosa ho sbagliato
Genie 4 sembra un generatore video, ma è un modello del mondo. Cosa imparano i simulatori di ambiente e perché la coerenza interattiva è difficile.
 Sarah Chen
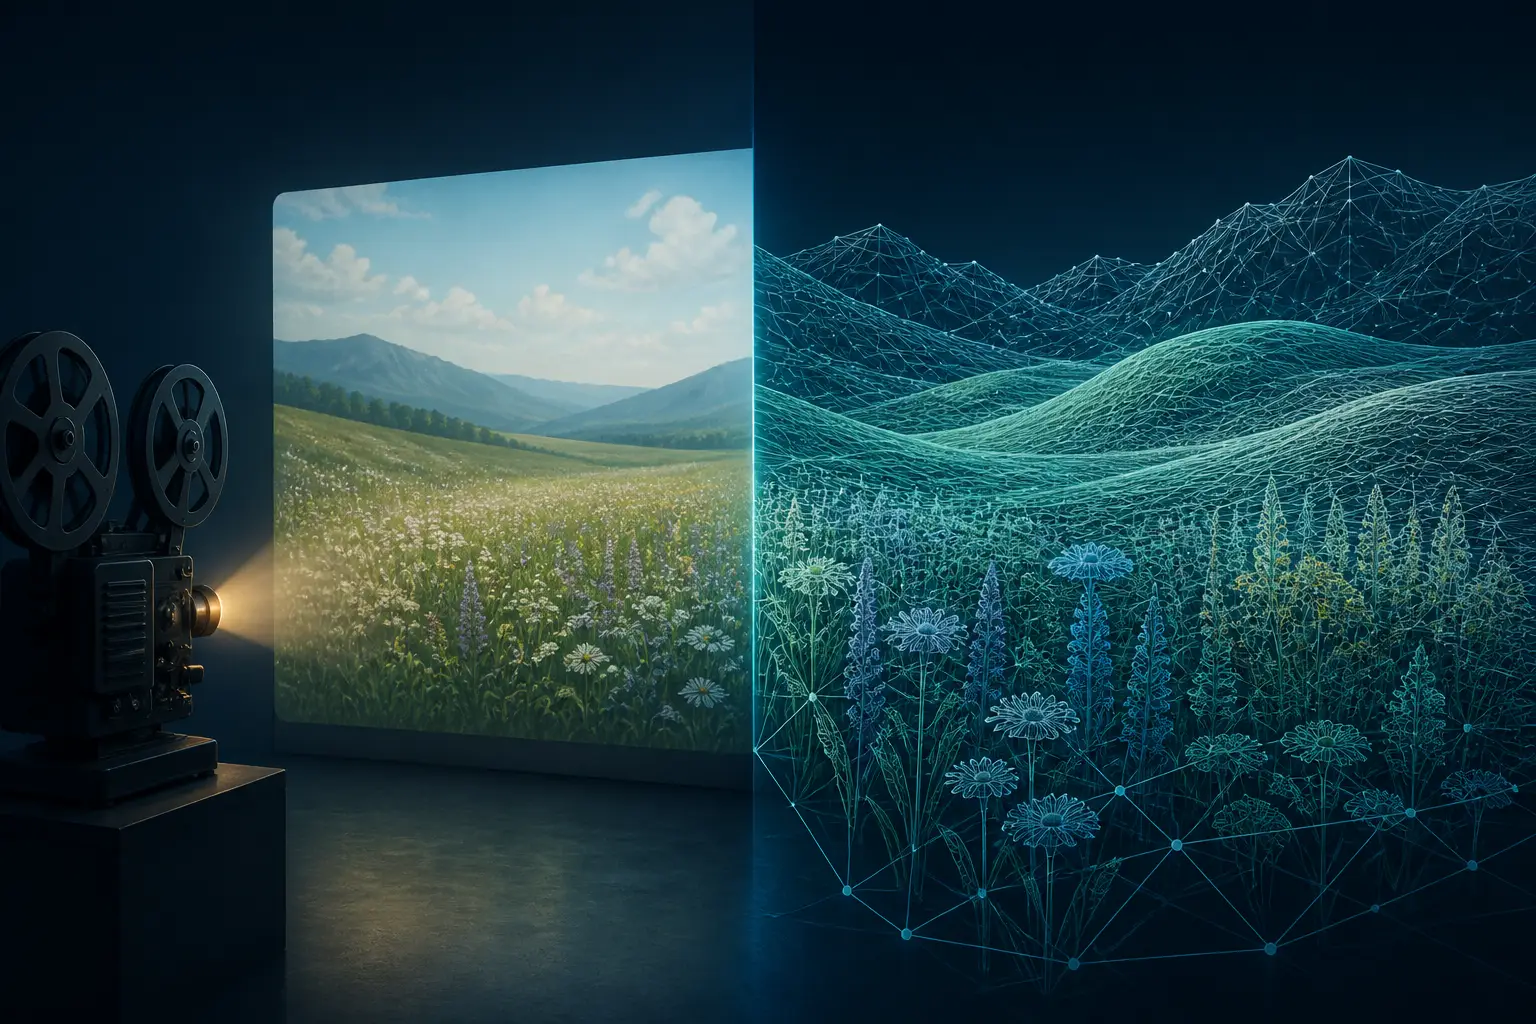
Quando sono usciti i demo di Genie 4, la mia prima reazione è stata la stessa che ho avuto con Sora: è un ottimo generatore video, perché lo chiamiamo modello del mondo? Una giornata a studiare i clip e a leggere le reazioni di persone più brave di me mi ha fatto cambiare idea sulla definizione, e mi ha ricordato tre errori che ho commesso costruendo e valutando modelli del mondo in lavori di simulazione. Non è una recensione del rilascio di DeepMind. È un insieme di lezioni imparate a caro prezzo sulla differenza tra prevedere un video e simulare un ambiente, perché le demo rendono facile confondere le due cose.
Lezione 1: un modello del mondo è una funzione di transizione, non un film
L'errore che ho fatto per molto tempo — e quello che vedo nella maggior parte dei commenti affrettati su Genie 4 — è valutare la simulazione interattiva con la griglia che usiamo per la generazione video. Entra un prompt, esce un clip, giudichiamo fedeltà, fluidità del movimento, aderenza al prompt. Fatto. Quella griglia ignora completamente il punto di ciò che si sta costruendo.
Un generatore video apprende p(frames | prompt). Un modello del mondo apprende qualcosa di più vicino a p(next_state | current_state, action). La distinzione sembra accademica finché non la metti sotto stress. Nella predizione video, nulla di ciò che fai durante la riproduzione cambia qualcosa; non c'è un «tu». In un modello del mondo, un agente (o un utente con una tastiera) inietta azioni a ogni passo, e il modello deve condizionarsi su di esse. Nel momento in cui consenti l'interazione, passi da un problema di arte generativa a un problema di stampo teoria del controllo: il sistema deve rispondere a input che non ha mai visto, in stati in cui scivola da solo, indefinitamente.
Ecco perché la navigazione da tastiera di Genie 4 e la modifica testuale durante la scena contano più del suo fotorealismo. Il fotorealismo è il minimo in questa generazione di modelli; Sora 2 e Veo 3 hanno già superato quella soglia. Il condizionamento delle azioni in tempo reale — premi un tasto, il mondo risponde causalmente e continua a rispondere in modo coerente — è il vero contributo di ricerca. Quando vedo persone valutare le demo solo sulla qualità dell'immagine, stanno dando un voto a un simulatore di volo per come sono belle le finestre.
La soluzione pratica alla confusione: quando valuti un presunto modello del mondo, fatti tre domande prima di guardare un singolo pixel. Accetta azioni in fase di inferenza, o solo un prompt? La stessa azione nello stesso stato produce sempre lo stesso effetto? E cosa succede se lo spingi per diecimila passi di fila? Queste tre domande separano i simulatori di ambiente dalle televisioni molto impressionanti.
Lezione 2: la coerenza fuori campo è dove si nasconde la bugia
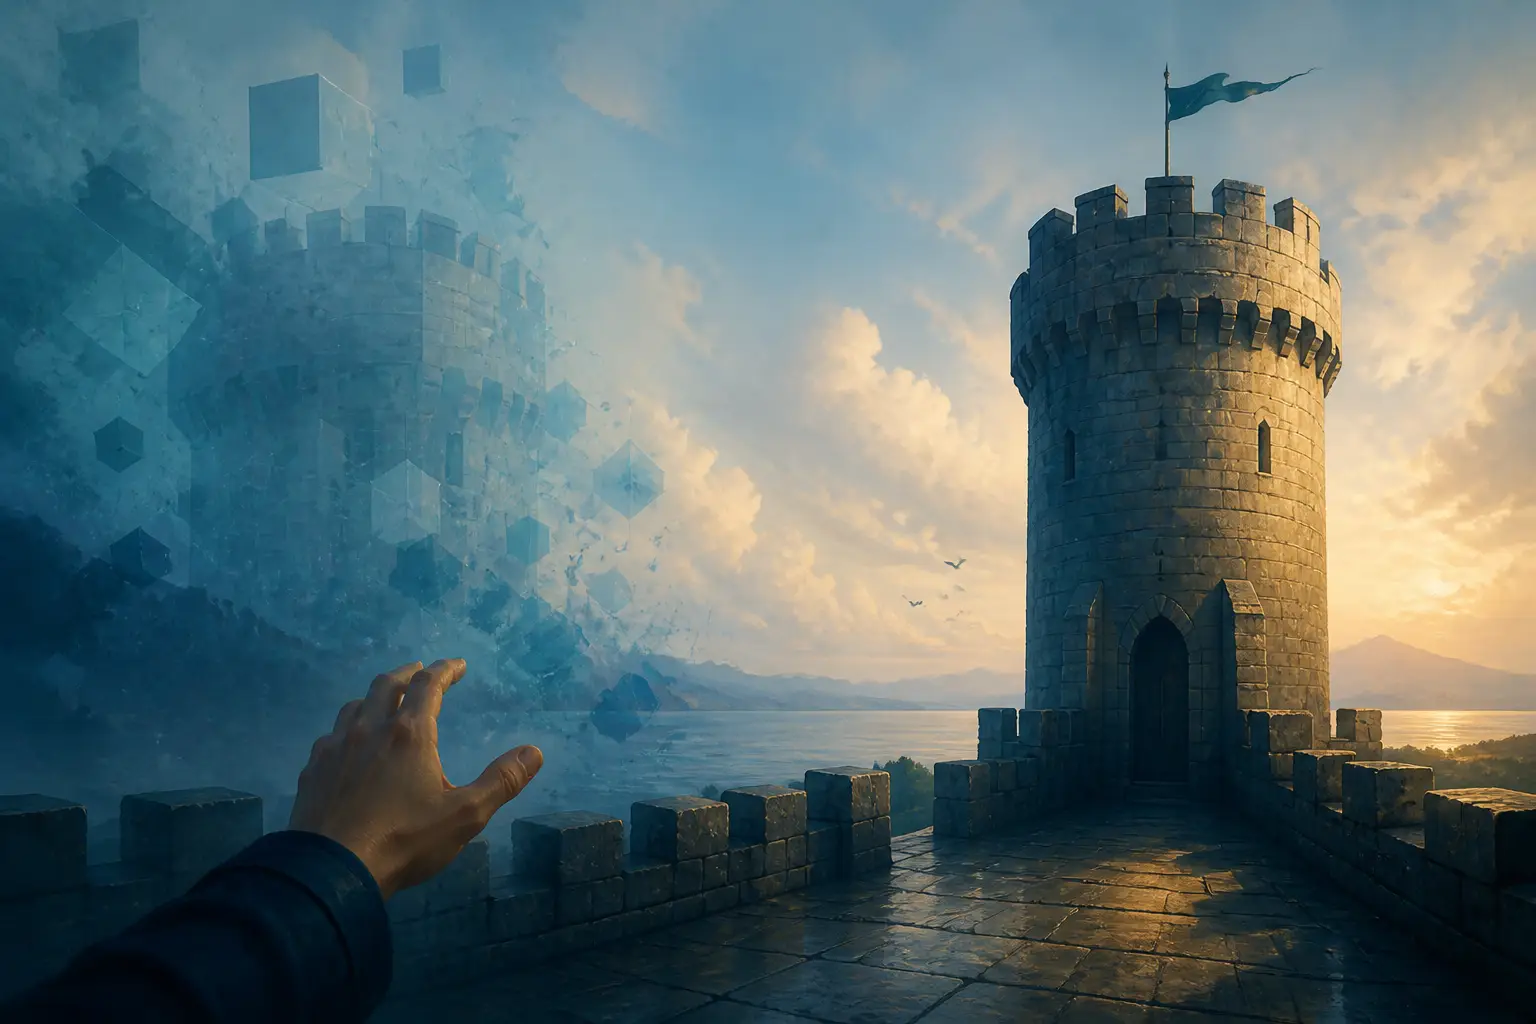
Le osservazioni più acute nella reazione pubblica non riguardavano affatto la qualità dell'immagine. Le persone hanno notato che nella demo della corsa dei draghi, quando la camera ruota verso il castello, una parte del lato destro — catapulta compresa — è sparita, e sembra essere comparso un secondo castello. I pedoni che si allontanano dalla camera sulla banchina del treno cambiano identità quando la camera torna. Un motociclista acquista un casco tra un taglio e l'altro. Il modello mantiene la coerenza in modo splendido per tutto ciò che resta in inquadratura, e improvvisa silenziosamente tutto ciò che ne esce.
Ho costruito sistemi con esattamente questa modalità di fallimento, quindi la riconosco subito. È ciò che ottieni quando lo stato del modello è essenzialmente una finestra scorrevole di fotogrammi latenti recenti più ciò che il meccanismo di attenzione riesce a trasportare. Non c'è una mappa esplicita, nessun archivio di permanenza degli oggetti, nessun scene graph. Il modello non sa che esiste un castello; sa che gli ultimi migliaia di token avevano un aspetto da castello, e una volta che quei token escono dal contesto, l'esistenza del castello diventa un testa o croce pesato dalle priorità. I castelli sono comuni nelle scene con draghi, quindi ne compare uno nuovo.
Un modello che dimentica ciò che è uscito dall'inquadratura non ha imparato un mondo. Ha imparato un presente molto sicuro di sé e molto plausibile.
Ecco la parte scomoda: questo può andare bene per l'intrattenimento e essere completamente squalificante per l'addestramento di agenti. Se addestri una policy di robot dentro un simulatore, la policy impara ciò che il simulatore premia. In un simulatore senza permanenza degli oggetti, un agente può «risolvere» i compiti aspettando che il mondo ritiri i dadi: si allontana da un ostacolo e, quando si gira, potrebbe non esserci più. La policy risultante si trasferisce alla realtà più o meno come una policy addestrata in un videogioco con il rilevamento delle collisioni rotto. Ho visto team bruciare mesi su divari sim-to-real ricondotti esattamente a questa classe di incoerenza.
La soluzione, concettualmente, è la memoria come componente architetturale di primo livello, non una proprietà emergente della lunghezza del contesto. Che si tratti di una rappresentazione spaziale esplicita (stato di scena in stile NeRF, mappe di voxel, slot per oggetti) o di una memoria latente molto più lunga e intelligente, il modello deve poter rispondere a: cosa c'è alle mie spalle in questo momento? senza doverlo sognare di nuovo. Il fatto che DeepMind si appoggi ai modelli di ragionamento di Gemini per «guidare e monitorare» la coerenza della scena mi sembra un'ammissione di questo: la coerenza oggi deve essere sorvegliata da un altro modello perché il nucleo generativo non la mantiene nativamente. È una toppa pragmatica, non una soluzione, e lo intendo come descrizione, non come insulto. Le toppe pragmatiche sono il modo in cui i sistemi reali vengono rilasciati.
Lezione 3: la fisica in uno spazio latente è un prior, non un risolutore
Il materiale di rilascio enfatizza aerodinamica, collisioni e movimento umano naturale, e le demo dello schiacciamento del cocomero e della caduta dei semi sembrano davvero fisicamente fluide. Il mio secondo grande errore, storicamente, è stato supporre che una fisica dall'aspetto fluido in un modello generativo significhi che il modello abbia interiorizzato la fisica in un modo su cui puoi contare. Non è così. Ha appreso le statistiche visive della fisica da enormi quantità di video, che è una cosa molto diversa da un sistema di vincoli.
Il segnale rivelatore è lo spostamento di distribuzione. I modelli di fisica latente azzeccano i casi più comuni — una palla rimbalza, l'acqua increspa, il tessuto si gonfia nel vento, perché i dati di addestramento contengono milioni di questi esempi. Spingendosi verso la coda della distribuzione, i priori si incrinano. Un prompt demo ha lottato molto contro il modello per evitare un «aspetto da videogioco» nonostante chiedesse fotorealismo, perché un pavone che si trasforma in gatto con una bacchetta magica è così fuori distribuzione che il modello è scivolato verso il genere più plausibile tra i suoi priori, che a quanto pare è l'animazione 3D stilizzata. La fisica appresa come texture fallisce proprio dove vorresti più di tutto un simulatore: nelle situazioni nuove che non si possono filmare.
Il test dello skater — creare una linea che inganni uno skater vero — è l'istinto giusto per la stessa ragione. Gli skater portano un motore fisico incarnato, messo a punto da migliaia di cadute. Trasferimento del peso, tempismo dello stacco, il modo in cui il momento si scambia con l'attrito sul cemento: se sbagli anche solo un po' qualcosa, risulta sbagliato a un esperto anche quando sembra a posto per tutti gli altri. I modelli del mondo latenti attuali non superano il controllo di un esperto di dominio sulla meccanica, e scommetterei contro qualsiasi modello addestrato solo su video che lo superi presto. La fisica sta nelle ombre dei dati, non nei pesi come legge applicabile.
La regola empirica che seguo ora: tratta la fisica di un modello del mondo latente come un bravo storyboard artist, non come un ingegnere. Ti disegnerà un'esplosione convincente. Non garantirà che le schegge conservino il momento. Se il tuo caso d'uso richiede garanzie — manipolazione robotica ricca di contatti, interazione fluido-struttura, validazione di sicurezza — ti serve ancora un vero motore fisico, e il lavoro interessante sta nei sistemi ibridi. È lo stesso schema che ho sostenuto per gli agenti di ragionamento ibridi: lascia che il modello appreso gestisca la parte sfocata ad alta dimensionalità, lascia che un componente verificabile gestisca gli invarianti.
Lezione 4: non addestrare agenti dove la verità di riferimento è un umore
Ogni annuncio di modelli del mondo include la promessa per la robotica, e Genie 4 non fa eccezione: ambienti di addestramento infinitamente variabili per robot e agenti. Ogni volta, una parte dei professionisti risponde con uno scetticismo giustificato — non puoi addestrare un robot in un sogno. Entrambe le parti hanno ragione a metà, e la soluzione sta nella specificità su quali agenti e quali competenze.
Per il controllo motorio di basso livello, i simulatori latenti sono oggi una trappola. Una policy di manipolazione ha bisogno di feedback di forza, dinamica dei contatti e fisica ripetibile; un modello che riscrive la geometria fuori campo e approssima le collisioni dalle statistiche video produce policy fragili e sfruttabili. Chi rilascia sim-to-real per la presa dovrebbe restare su simulatori come MuJoCo, Isaac o Bullet e trattare le demo dei modelli del mondo come una direzione di ricerca da tenere d'occhio.
Per il processo decisionale di alto livello, invece, il calcolo si ribalta. Policy di navigazione, test di scenari di guida, agenti per web e interfacce, agenti per giochi, pianificatori multi-step: di solito questi richiedono conseguenze plausibili delle azioni, non una dinamica esatta alla Newton. Abbiamo già visto funzionare lo schema: sistemi di RL basati su modello come Dreamer si addestrano dentro un modello dinamico latente appreso e si trasferiscono a compiti reali su Atari e controllo; Waymo e altri usano da tempo modelli comportamentali appresi per gli altri utenti della strada nelle loro simulazioni. Un modello del mondo generativo è questa idea scalata ad ambienti visivi aperti. L'errore è pretendere che un solo modello serva sia il pianificatore sia il loop di controllo.
- Usa i modelli del mondo latenti per: diversità di scenari, generazione di eventi rari, valutazione di policy di alto livello, test con un essere umano nel loop, dati sintetici per la percezione.
- Usa i motori fisici per: manipolazione ricca di contatti, controllo sensibile alla dinamica, tutto ciò in cui una collisione incoerente su diecimila passi avvelena il segnale di ricompensa.
- Non usarne nessuno alla cieca: valida la policy contro la realtà presto e spesso, perché ogni simulatore — appreso o costruito a mano — ha un divario, e vuoi trovare il tuo nella seconda settimana, non al nono mese.
Lezione 5: audio e dialogo in tempo reale cambiano il prodotto, non la scienza
Genie 4 è il primo di questi modelli a generare audio ambientale e dialoghi interattivi in modo nativo, e internet ha subito notato che suonava un clarinetto quando gli era stato chiesto un sassofono. Divertente, e anche istruttivo. La coerenza tra modalità è lo stesso problema della permanenza degli oggetti con un altro cappello: la testa audio ha una propria nozione latente della scena, e «strumento a fiato ad ancia singola in ottone» è abbastanza vicino nello spazio degli embedding perché lo scambio passi inosservato. Aspettatevi una lunga coda di questi episodi — passi sulla neve che suonano come ghiaia, dialoghi che rispondono a una domanda che la scena ha già superato.
Strategicamente, però, l'audio è un affare più grande di quanto suggerisca la gaffe del sassofono. Un mondo silenzioso è una demo; un mondo sonoro è un prodotto. La guida in linguaggio naturale — cambiare il meteo, aggiungere una persona, a metà del flusso — è l'altra metà. Insieme trasformano il modello del mondo da artefatto di ricerca in un mezzo interattivo, ed è chiaramente ciò che Google vuole: Project Genie, abbonamenti AI Ultra, partner API. La previsione «i film diventano videogiochi» è il percorso commerciale più ovvio, e per una volta la rima dell'hype regge.
Per chi lavora sul campo, la lezione è separare i due filoni nella propria testa. Il filone di prodotto (tempo reale, guidabile, audiovisivo, monetizzabile) si muove in fretta e produrrà strumenti davvero utili per prototipazione, previsualizzazione e narrazione interattiva entro uno o due anni. Il filone scientifico (stato persistente, fisica causale, coerenza affidabile su orizzonti lunghi) si muove al ritmo della ricerca e non va dato per risolto solo perché la demo è splendida. Ho già commesso l'errore di leggere una tappa di prodotto come una tappa scientifica; è così che finisci per progettare un sistema attorno a una capacità che ancora non esiste.
Cosa farei davvero oggi con tutto questo
Se costruisci agenti, la mossa pragmatica non è cambiata: tieni lo stack di controllo su fisica reale, ma inizia a sperimentare con simulatori appresi per i livelli superiori — generazione di scenari, smoke test delle policy e dati sintetici di percezione. La curva dei costi sta scendendo come è successo per l'inferenza degli LLM, e come ho scritto in perché i benchmark dell'IA non colgono il lavoro reale, vincono i team che valutano sulla propria distribuzione di compiti effettivi invece che sulle demo pubbliche. Costruisci un harness che faccia girare il modello del mondo per migliaia di passi interattivi e misuri i fallimenti di coerenza — ricomparsa di oggetti, deriva della geometria, violazioni causali. Quell'harness ti dirà più di qualsiasi video di lancio.
Tieni d'occhio anche il versante a pesi aperti — HY-World 2.0 di Tencent ha ricevuto una frazione dell'attenzione di Genie 4, e se la storia di LLM e modelli di immagini è una guida, l'ecosistema aperto è dove i professionisti impareranno davvero come funzionano questi sistemi. Non puoi introspezionare un'anteprima di ricerca dietro una lista d'attesa. Puoi fare fine-tuning, sondare e rompere qualcosa che puoi scaricare, e il sondaggio conta: come nel caso del lavoro di interpretabilità meccanicistica, i risultati interessanti vengono dal far pressione sulla rete, non dall'ammirarla.
Il riassunto onesto: Genie 4 è un passo reale sull'asse difficile — l'interattività — non solo sull'asse facile dei pixel più belli. Ma il divario tra «mantiene una scena mentre la guardi» e «simula un mondo» è ancora ampio, ed è esattamente il divario che conta per l'addestramento degli agenti. Chiamalo modello del mondo, se vuoi. Ricorda solo che un mondo, a differenza di un video, c'è ancora quando ti giri. Questi, per lo più, non ci sono — ancora.