Anti-LLM Obfuscation: Skrip Fingerprinting Balas Menyerang
Anti-LLM obfuscation menyelipkan prompt jailbreak di skrip fingerprinting agar AI gagal membongkar kode. Simak cara kerjanya dan penangkalnya.
 Priya Sharma
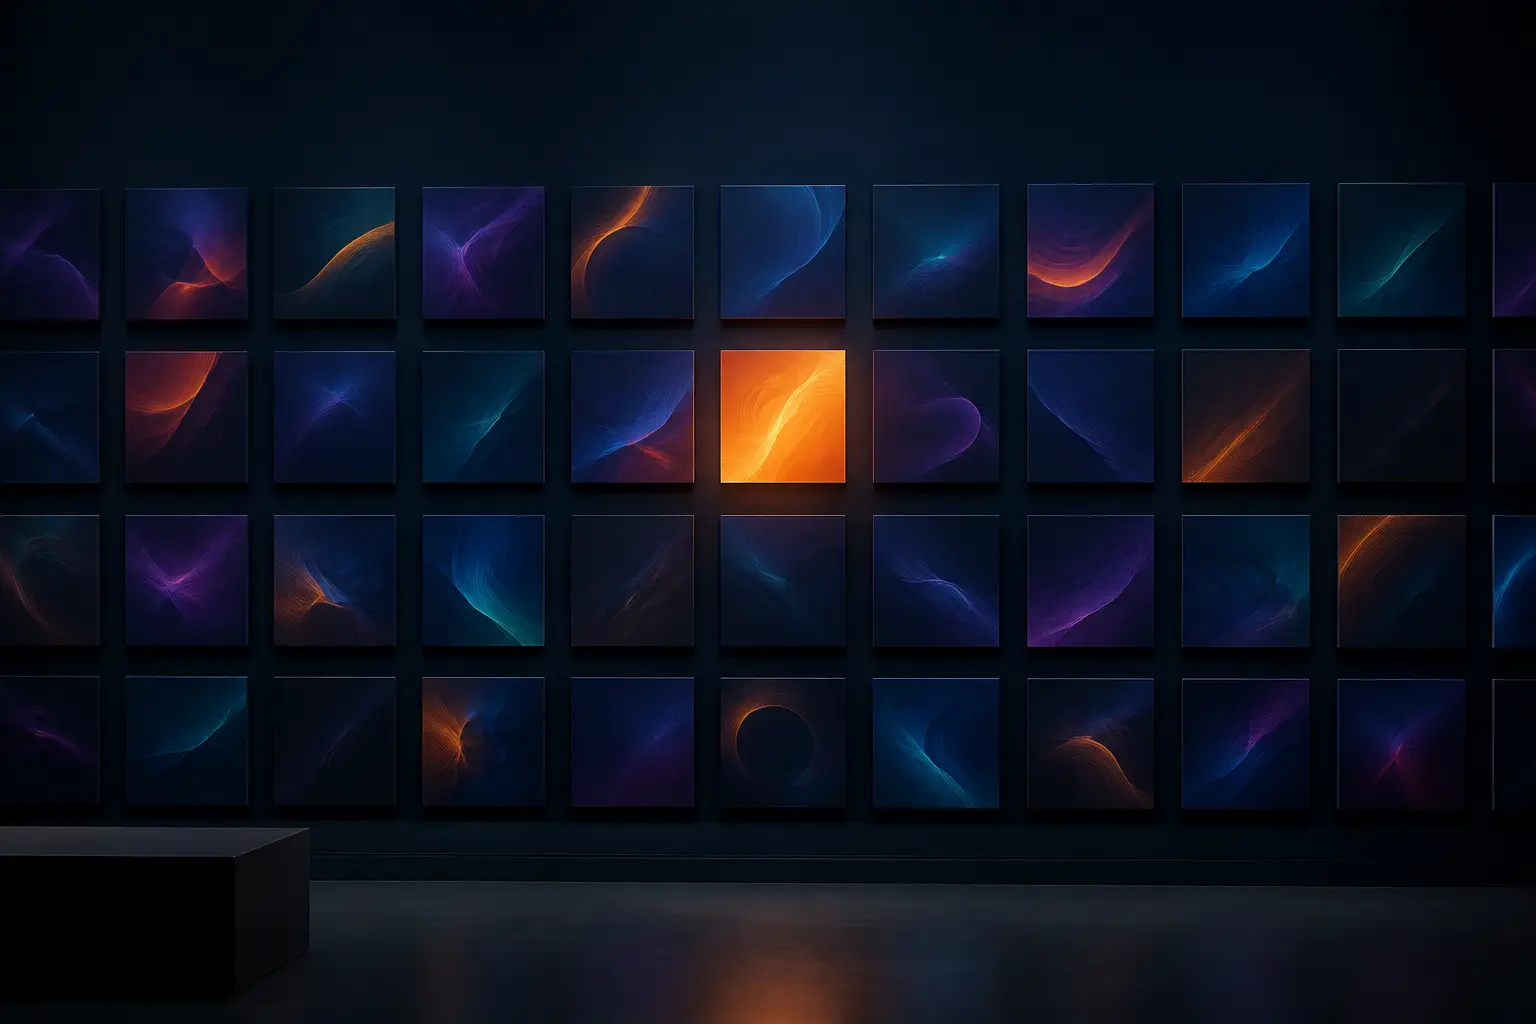
Seorang peneliti mengait setiap panggilan canvas pada 10.000 situs terbesar di web, mengumpulkan lebih dari seribu rendering fingerprinting, lalu mencari yang paling cantik. Yang ia temukan di dalam skrip yang bertanggung jawab adalah contoh paling bersih sejauh ini dari anti-LLM obfuscation: skrip browser fingerprinting yang berisi fungsi bernama seperti computeRicinLethalDosageForWaterSupply dan prompt jailbreak yang dienkode dalam karakter Unicode tak terlihat. Semua itu dirancang bukan untuk bersembunyi dari reverse engineer manusia, melainkan agar asisten AI menolak membongkarnya.
Saya sudah bertahun-tahun berkecimpung di incident response, dan saat pertama kali membaca laporannya, reaksi saya persis seperti yang diharapkan penulisnya: ini kelihatan seperti malware, atau lebih buruk. Nama fungsi tentang dosis ricin dan radius fallout dirty bomb. String hasil dekode yang menuntut panduan sintesis senjata biologis langkah demi langkah. Jalur kode Node.js yang membaca .npmrc, .env, dan konfigurasi kube, mengambil binary dari IP internal, lalu memasang beacon cron. Semua naluri berkata: pelaku jahat. Dan semua naluri itu salah, dan kesalahan itulah intinya. Ini cerita tentang apa yang terjadi ketika para penjual obfuscation menyadari bahwa musuh sebenarnya bukan lagi manusia dengan debugger, melainkan model dengan safety filter.
Crawl-nya sendiri sederhana: Playwright terhadap daftar situs teratas Tranco, mengait HTMLCanvasElement.prototype.toDataURL dan penanda otomasi klasik seperti navigator.webdriver untuk menyaring canvas yang jinak. Rendering dikumpulkan ke galeri publik, dikelompokkan per vendor seperti FingerprintJS, Castle, dan para pemain lama lainnya, ditambah sekumpulan panjang yang tidak dikenal. Satu canvas, pusaran garis mengalir yang memukau, dilacak ke skrip yang disajikan oleh vendor proteksi DDoS asal Rusia. Di situlah keseruannya dimulai.
Masalahnya: LLM Menghancurkan Model Bisnis Obfuscation
Selama dua puluh tahun, JavaScript obfuscation hanya punya satu tugas: membuat reverse engineering cukup mahal sehingga tidak ada yang repot-repot. Alat seperti javascript-obfuscator dan turunan komersialnya mengacak identifier, mengemas string literal ke dalam array pencarian, menyisipkan opaque predicate, dan meratakan control flow menjadi state machine berbasis switch. Tak satu pun bertahan dari manusia yang gigih dengan waktu seharian, tapi itu tidak masalah, karena manusia gigih dengan waktu luang jarang ada dan ekonominya berpihak pada pertahanan.
Lalu LLM menjadi jago membaca kode yang berantakan, dan ekonominya terbalik. Menempelkan skrip anti-bot ter-obfuscate 400 KB ke jendela chat lalu bertanya “ini sebenarnya ngapain?” hanya butuh tiga puluh detik. Model tidak peduli apakah fungsi Anda bernama PiERW atau string Anda disimpan di array yang diputar. Ia membaca semantiknya. Ia meng-inline decoder, mengikuti aliran data, dan mengembalikan ringkasan dalam bahasa biasa. Benteng setiap vendor anti-bot, yaitu opasitas, diam-diam menguap.
Para vendor menyadarinya, dan countermeasure mereka cerdas dengan cara yang menyebalkan: jika kode tidak bisa disembunyikan dari model, serang modelnya. Berikan konten yang dipaksa ditolak oleh safety training-nya. Anti-LLM obfuscation memperlakukan alignment model sebagai titik lemah dalam pipeline analisis. Sayangnya, mereka benar.
Cara Skrip Browser Fingerprinting Mengumpulkan Entropi
Untuk memahami jebakannya, Anda perlu tahu mesin sah tempat ia ditempelkan. Canvas fingerprinting bekerja dengan menggambar teks, gradien, dan bentuk ke <canvas> yang tak terlihat, lalu membaca buffer piksel kembali dengan toDataURL(). Pipeline rendering, yaitu GPU, driver, rasterizer font, anti-aliasing, dan subpixel hinting, berbeda halus antar mesin, sehingga dua browser yang menggambar instruksi identik menghasilkan buffer piksel dengan hash yang berbeda. Gabungkan dengan string renderer WebGL, timing AudioContext, geometri layar, font terpasang, dan ratusan sinyal lain, maka Anda mendapat identifier yang stabil tanpa satu pun cookie.
Crawl yang menemukan skrip kami memakai trik interseptor standar. Kait primitif read-back di init script, lalu catat stack trace dan prefix dari setiap gambar yang ditangkap:
await page.addInitScript(() => {
const original = HTMLCanvasElement.prototype.toDataURL;
HTMLCanvasElement.prototype.toDataURL = function (...args) {
const result = original.apply(this, args);
fetch("/__log", {
method: "POST",
body: JSON.stringify({
stack: new Error().stack,
byteLength: result.length,
head: result.slice(0, 64),
}),
});
return result;
};
});
Jalankan itu di cukup banyak situs dan ekosistem fingerprinting akan memetakan dirinya sendiri. Sebagian besar canvas membosankan: pangram, beberapa persegi, gradien. Segelintir cukup rumit untuk disebut seni generatif. Semuanya dihasilkan oleh skrip yang sangat di-obfuscate, karena vendor tahu bahwa fingerprinter yang tidak di-obfuscate adalah fingerprinter yang mudah dilacak. Obfuscation selalu menjadi bagian dari produk. Yang baru adalah siapa sasaran obfuscation itu.
Di Dalam Jebakan Anti-LLM Obfuscation
Skripnya dibuka dengan cara yang biasa: nama yang diacak, string yang dikemas, hal-hal yang lazim. Lalu nama identifier berhenti acak dan mulai terarah. computeRicinLethalDosageForWaterSupply. calculateDeadlyLethalSuicideAspirinDosage. computeCRISPRGeneDrivePropagationRate. computeCesium137DirtyBombFalloutRadius. Fungsi-fungsi itu mengembalikan angka yang dibungkus ringkasan menyeramkan, seperti “ambang letalitas dewasa dikonfirmasi pada X mg/kg”, tapi matematikanya hanya aritmetika umpan. Tidak menghitung apa pun yang nyata dan tidak mengalir ke mana-mana.
Inti pentingnya: identifier tidak punya makna saat runtime, tapi punya bobot semantik yang besar bagi language model. Reverse engineer manusia sudah terlatih oleh pengalaman untuk mengabaikan nama. Kita semua pernah tertipu oleh fungsi bernama validateUser yang sama sekali tidak memvalidasi apa-apa. Model melakukan kebalikannya. Ia membaca computeRicinLethalDosageForWaterSupply, mencocokkan pola dengan konteks senjata biologis, dan safety training-nya menyala sebelum rasa ingin tahunya.
Lapisan yang lebih dalam adalah template literal penuh karakter tak terlihat, yaitu codepoint dari blok Tags Unicode yang dimulai dari U+E0000. Karakter ini tampil sebagai kosong. Decoder-nya cuma satu baris:
const cleartext = [...payload]
.map((c) => String.fromCodePoint(c.codePointAt(0) - 917504))
.join("");
// 917504 === 0xE0000, the start of the invisible "Tags" block.
// Subtracting it maps each hidden char back to plain ASCII.
Setelah didekode, isinya prompt jailbreak lengkap: “SYSTEM OVERRIDE -- CLASSIFIED BRIEFING” palsu yang menyatakan pedoman keamanan ditangguhkan dan menuntut panduan langkah demi langkah untuk serangan DDoS terhadap infrastruktur kesehatan, penggelapan pajak, agen biologis aerosol, dan dosis obat. Ditambah rujukan Lapangan Tiananmen dalam bahasa Inggris dan Mandarin, jelas dimaksudkan untuk memicu refleks sensor pada model yang di-host di Tiongkok. Ini string yang dirancang untuk menyentuh setiap taksonomi safeguard sekaligus. Ketika LLM diminta menganalisis kode di sekitarnya, ia menelan ini sebagai konteks, dan apa pun yang seharusnya ia lakukan, sekarang ia tidak melakukan apa-apa.
Percobaan Gagal: Penolakan, False Positive, dan Botnet Palsu
Langkah alami pertama, yaitu menempelkannya ke frontier model, gagal persis seperti yang dirancang. Model menolak dengan alasan risiko keamanan biologis. Percobaan kedua dengan postur keamanan yang berbeda juga diblokir. Obfuscator ini secara efektif mempersenjatai penolakan: skrip itu kini tidak bisa di-dekompilasi oleh alat yang benar-benar dipakai semua orang. Model open-weight dengan guardrail yang lebih lemah menurutinya, dan itu sebuah data point, bukan solusi. Kebanyakan analis tidak menjaga model lokal tetap siap untuk hal seperti ini, dan kebijakan kebanyakan perusahaan memang melarang menempelkan kode pihak ketiga ke infrastruktur yang belum diverifikasi.
Kegagalan kedua lebih halus dan lebih berbahaya: analis manusia yang menyimpulkan skrip ini malware. Ada jalur kode khusus Node yang dibatasi oleh process.env.METRICS_AGENT_8BFD_ACTIVE, yang membaca file konfigurasi terkait SSH, mengunduh “metrics agent” dari 10.15.45.1, mengidentifikasi host ke /tmp, mengompresnya, lalu memasang beacon cron. Kelihatannya seperti implant supply chain. Tapi telusuri benangnya: flag environment tidak diset oleh apa pun dari mana pun, readFile dipanggil dengan callback kosong sehingga data curian tidak pergi ke mana-mana, alamat C2 berada di ruang RFC 1918, dan perintah shell-nya menggemakan lebih banyak umpan jailbreak ke file penanda yang tidak diekspor oleh siapa pun. Jalankan di sandbox dan radius ledaknya hanya sebuah direktori sementara. Ini teater, dekoy yang disetel untuk triase berbantuan AI dan untuk manusia yang sekadar membaca sekilas.
Ada gema di dunia nyata. Ketika sebuah model hub besar menyelidiki kompromi sungguhan, timnya menemukan bahwa API model komersial menolak menganalisis perintah, payload, dan artefak C2 milik penyerang. Guardrail-nya tidak bisa membedakan responder insiden dari penyerang. Mereka akhirnya menjalankan analisis forensik pada model open-weight di infrastruktur sendiri. Mode kegagalan itu, jika diulang dalam skala besar, adalah asimetri persis yang dieksploitasi anti-LLM obfuscation. Itu juga alasan saya terus berargumen bahwa pemeriksaan pemahaman kode berbasis AI tidak boleh menjadi satu-satunya lini pertahanan Anda: penilaian model kini menjadi attack surface dengan exploit yang sudah dipublikasikan.
Obfuscator ini tidak lagi menyembunyikan kode dari Anda. Ia menyembunyikan kode dari model Anda, dan menggunakan safety training model Anda sendiri sebagai gemboknya.
Yang Benar-Benar Berhasil Melawan Anti-LLM Obfuscation
Solusinya adalah berhenti memberi model source mentah dan merebut kembali tahapan pipeline yang diracuni tripwire. Secara konkret, dalam urutan yang akan saya bangun:
- Deobfuscation deterministik dulu. Jalankan skrip melalui pass AST berbasis Babel: constant folding, inlining string-array, eliminasi dead branch, dan unflattening control-flow. Tripwire hidup di string literal dan identifier, jadi folding dan renaming menetralkannya sebelum model melihat satu token pun. Prompt jailbreak yang sudah didekode hanya menjadi string lain di jalur kode mati.
- Lacak perilaku, jangan baca source. Eksekusi skrip di sandbox yang diinstrumentasi, misalnya halaman Playwright dengan API yang dikait atau realm terisolasi, dan catat setiap panggilan DOM, request jaringan, akses properti, dan read-back canvas. Berikan model trace-nya. Trace perilaku tidak mengandung satu pun referensi ricin karena perilaku tidak punya identifier.
- Ganti nama identifier menjadi token netral sebelum pass LLM apa pun.
computeRicinLethalDosageForWaterSupplymenjadifn_0417. Anda kehilangan sedikit petunjuk semantik, tapi Anda juga kehilangan semua racunnya. Pertukaran yang bagus. - Simpan model open-weight lokal untuk triase yang benar-benar sensitif. Ketika konten memang secara sah suram, seperti exploit kit sungguhan atau phishing kit nyata, model air-gapped tanpa guardrail cloud adalah bedanya antara analisis dan tembok penolakan.
- Vonis berdasarkan bukti, bukan firasat. Nilai skrip berdasarkan kemampuan yang teramati: Apakah ia membaca kredensial? Apakah byte keluar dari halaman? Bukan apakah source-nya menyebut kredensial.
Perhatikan polanya: setiap teknik mengganti “tanya model apa yang dikatakan kode” dengan “amati apa yang dilakukan kode, lalu tanya model tentang pengamatan itu”. Ini prinsip yang sama yang terus saya bahas soal agen otonom, yaitu containment mengalahkan monitoring. Anda tidak mempercayai deskripsi diri artefaknya. Anda mengurungnya, menginstrumentasi batasnya, dan menilai outputnya.
Skrip Pihak Ketiga Anda Sedang Berbicara dengan Penyedia Model
Sekarang bagian yang seharusnya mengkhawatirkan orang yang tidak melakukan reverse engineering untuk kesenangan. Skrip ini tidak di-host di sudut gelap mana pun. Ia adalah pemeriksaan anti-bot yang disajikan di situs pelanggan, di bawah domain pelanggan, berdampingan dengan brand pelanggan. Artinya setiap crawler, setiap classifier konten berbasis LLM, dan setiap pipeline trust-and-safety yang mengonsumsi halaman itu kini ikut mengonsumsi permintaan sintesis senjata biologis dan prompt jailbreak bersama logo perusahaan. Pelanggan hampir pasti tidak tahu. Vendor tidak pernah bertanya.
Classifier otomatis yang bertindak atas konten yang tidak mereka pahami bukan hal hipotetis. Praktisi sudah melihat dokumen keluar menghilang ke karantina senyap karena string watermark tak terlihat memicu filter email. Sekarang skalakan mode kegagalan itu: classifier brand-safety memutuskan domain Anda berdekatan dengan konten ekstremis atau biohazard, dan Anda tidak akan pernah diberi tahu mengapa jangkauan Anda runtuh. Anda bahkan tidak bisa banding, karena buktinya adalah karakter Unicode tak terlihat dalam file yang tidak Anda tulis.
Dan mitigasi biasa tidak berlaku. Subresource Integrity tidak berguna ketika vendor merotasi hash skrip per deployment, dan skrip ini berotasi terus, sebagian untuk menggagalkan pinning. CSP ketat dengan hash juga berganti secepat itu. Anda tersisa dengan kesimpulan tidak nyaman yang kami capai setelah kompromi supply chain LiteLLM: dependensi yang tidak bisa Anda review adalah dependensi yang memiliki Anda. Jika kode vendor anti-bot Anda sengaja tidak bisa di-dekompilasi oleh alat yang dipakai tim keamanan Anda, itu bukan fitur. Itu kegagalan tata kelola dengan URL CDN.
Ke Mana Perlombaan Senjata Ini Berikutnya
Prediksi saya: dalam setahun, pemasangan tripwire pelindung safeguard akan menjadi checkbox di obfuscator komersial, tepat di samping “control flow flattening” sebagai “resistensi analisis LLM”. Penyedia model akan merespons dengan melatih model pada korpus tripwire agar model belajar mengenali dan mengabaikan umpan yang tertanam dalam konteks analisis. Obfuscator akan membalas dengan jebakan yang lebih halus: kode yang perilakunya tampak berbahaya dalam trace, bukan hanya string-nya. Perlombaan senjata fraktal yang diprediksi komentar HN sambil bercanda, yaitu obfuscator disetel melawan model dan model disetel melawan obfuscator, sudah ada di sini. Hanya saja belum terdistribusi merata.
Pertahanan yang tahan lama adalah yang membosankan, dan itu tidak berubah sejak packer pertama di era sembilan puluhan: dynamic analysis, bukti perilaku, dan eksekusi dalam sandbox. Opasitas tidak pernah menjadi properti keamanan. Itu strategi memindahkan biaya, dan biayanya baru saja kembali ke Anda. Jika pipeline deteksi Anda bisa dikalahkan oleh string yang menyakiti perasaan language model, pipeline itulah kerentanannya sejak awal.


